


Sur cette page
- Le code généré par IA est-il sûr ?
- Pourquoi tant de code généré par IA est-il non sécurisé ?
- Quels types de vulnérabilités le code IA introduit-il ?
- Que ratent les scanners, et les modèles eux-mêmes ?
- Peut-on faire confiance à une IA pour corriger ses propres vulnérabilités ?
- Comment rendre le code généré par IA sûr ?
- Questions fréquentes
- Le code généré par IA est-il sûr ?
- Est-il sûr de déployer du code généré par IA en production ?
- Pourquoi le code généré par IA est-il non sécurisé si le modèle est si capable ?
- Puis-je simplement demander à l'IA de vérifier elle-même son code pour les vulnérabilités ?
- Quelles sont les vulnérabilités les plus courantes dans le code généré par IA ?
- Comment rendre le code généré par IA sûr ?
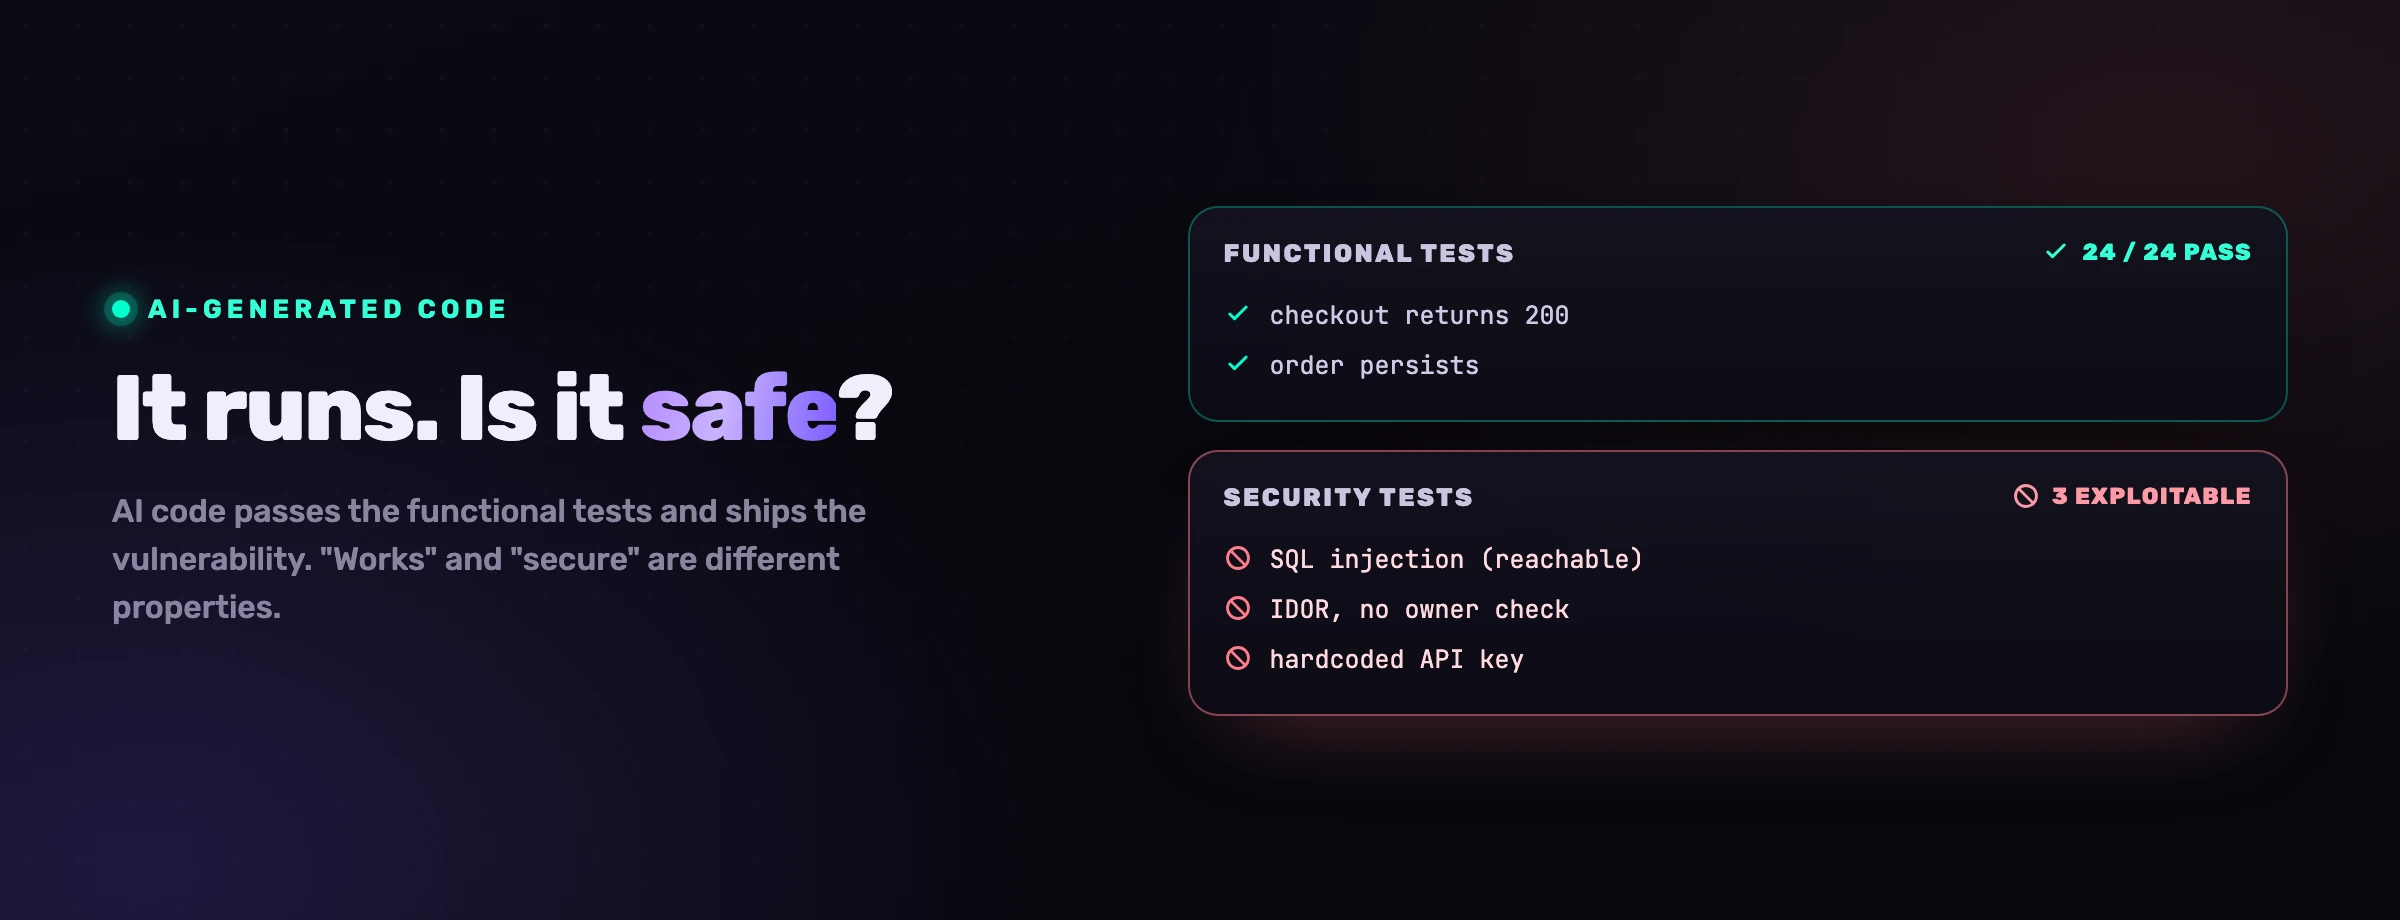
Le code généré par IA est-il sûr ? Il s'exécute, il passe la démo, et il ressemble au code qu'un ingénieur compétent aurait écrit. C'est exactement le problème. « Ça marche » et « c'est sûr » sont deux propriétés différentes : l'agent optimise la première à fond, et un prompt « fais que ça marche » ne demande jamais la seconde. Chaque chiffre de cet article vient d'une source que vous pouvez ouvrir, avec sa date et sa méthode : la réponse honnête à cette question est une mesure, pas une opinion. Vous trouverez ici la réponse directe, les mesures publiées jusqu'en août 2026, les classes de vulnérabilités que les scanners et les modèles eux-mêmes laissent passer, et ce qu'il faut mettre en place pour livrer du code IA sans exposer vos données.
Le code généré par IA est-il sûr ?
Non, pas par défaut. Le code généré par IA vaut ce que valent les contrôles qui l'entourent, et la plupart des installations n'ont aucun contrôle qui agisse avant que le code n'atterrisse. Les benchmarks indépendants décrivent tous la même forme d'échec : le code tourne, il passe ses tests, et il porte quand même une vulnérabilité.
La mesure systématique la plus ancienne reste la plus lisible. Dans Asleep at the Keyboard, soumis en août 2021 par une équipe de New York University avec un co-auteur de l'University of Calgary, les chercheurs ont donné à GitHub Copilot 89 scénarios tirés du Top 25 du MITRE et collecté 1 689 complétions. Leur conclusion : « Of these, we found approximately 40% to be vulnerable. » Le chiffre a cinq ans et porte sur un seul assistant, c'est donc une ligne de base historique, pas le verdict d'aujourd'hui. Méfiez-vous de ceux qui le citent comme « 40 % du code généré par IA », ce n'est pas ce que le papier dit.
Le verdict d'aujourd'hui vient de SusVibes, un benchmark du Language Technologies Institute de Carnegie Mellon, mené avec Columbia, Johns Hopkins et HydroX AI, accepté à ICML 2026 et révisé le 21 août 2026. Il part de 186 demandes de fonctionnalité réelles, tirées de projets open source où l'implémentation humaine était elle-même vulnérable, couvre 79 catégories CWE et fait tourner 12 configurations d'agent. La meilleure, SWE-Agent avec Claude 4 Sonnet, était fonctionnellement correcte sur 57 % des tâches et sécurisée sur 11,8 %. Et 79,3 % de ses solutions fonctionnellement correctes portent quand même une vulnérabilité.
des solutions de la meilleure configuration d'agent étaient sécurisées, contre 57 % fonctionnellement correctes (SusVibes, 186 demandes de fonctionnalité réelles, révisé en août 2026)
des solutions fonctionnellement correctes de ce même agent portaient quand même une vulnérabilité (même benchmark)
des applications testées par l'OWASP présentaient une forme de contrôle d'accès rompu, son risque numéro un pour 2025
Ce qui transforme un taux par tâche en problème d'entreprise, c'est l'échelle. Dans le rapport DORA 2025 sur le développement logiciel assisté par IA, publié le 23 septembre 2025, « 90% of survey respondents report using AI at work » tandis que « 30% report little or no trust in the code generated by AI », et « AI adoption does continue to have a negative relationship with software delivery stability ». Neuf développeurs sur dix en livrent, trois sur dix s'en méfient. Vigilance pour le lecteur français : ce DORA est celui de DevOps Research and Assessment, publié par Google Cloud, rien à voir avec le règlement européen du même sigle.
L'échelle a une conséquence très concrète de ce côté-ci de la Manche. Un endpoint qui renvoie l'enregistrement du client d'à côté n'est pas un incident isolé, c'est une violation de données à caractère personnel au sens du RGPD : l'article 33 fait courir soixante-douze heures de notification à la CNIL dès que vous en avez connaissance, et l'article 32 vous demandait des mesures techniques et organisationnelles appropriées bien avant. Le texte ne parle pas d'intelligence artificielle. Il parle du contrôle de propriété que personne n'a écrit, et l'agent écrit l'endpoint plus vite que la revue ne le lit.
Pourquoi tant de code généré par IA est-il non sécurisé ?
Parce qu'un modèle peut connaître un principe de sécurité et échouer à l'appliquer à la ligne où il compte. Une systématisation de juin 2026 menée à l'University at Buffalo a nommé ce phénomène l'écart connaissance-actuation et l'a mesuré : les modèles scorent bien plus haut quand on leur demande la règle que quand on leur demande du code qui survit à l'exploitation.
Ce papier, SoK: AI Secure Code Generation, met des nombres sur la distance : « The benchmark-level gap is 47.9 points for CWEval and 72.9 points for BaxBench. » L'écart se creuse à mesure que la tâche devient réaliste : CWEval travaille au niveau de la fonction, BaxBench demande des applications web entières, où le garde-fou doit atterrir dans le bon middleware, sur la bonne route, dans le bon fichier. Son treizième enseignement est la phrase à retenir : l'écart est un problème de livraison, les modèles détiennent la bonne connaissance de sécurité et échouent à l'appliquer à la bonne frontière d'implémentation. Ce qui marche n'est donc pas d'enseigner plus de sécurité au modèle, c'est de relier un principe qu'il connaît déjà à l'endroit exact du code.
Deux forces plus anciennes aggravent le tableau. Le corpus, d'abord : le modèle a appris sur un immense volume de code public rempli de SQL concaténé, d'autorisations manquantes, de cryptographie faible et de secrets en ligne, si bien que le non-sécurisé-par-défaut est son a priori statistique. L'absence, ensuite : la sécurité est d'ordinaire un garde-fou présent, et un modèle à qui l'on demande un résultat positif (« ajoute un endpoint de paiement ») n'ajoute pas une protection que personne n'a demandée. La fonctionnalité marche parce que la vérification manquante n'affecte pas le chemin heureux.
Vient enfin le problème du lecteur, et c'est le décisif. La personne qui écrit le prompt sait dire si la fonctionnalité marche. Elle ne sait souvent pas dire si elle est sûre. Cet écart entre l'intention de l'auteur et la compétence du relecteur s'élargit exactement quand un non-spécialiste vibe-code une fonctionnalité en un paragraphe d'intention. Nous creusons ce point dans la sécurité du vibe coding.
Quels types de vulnérabilités le code IA introduit-il ?
Les mêmes que les humains, reproduites plus vite que la revue ne peut suivre : injection, autorisation rompue, secrets en dur, validation d'entrée manquante, désérialisation, logique métier. La plupart figurent au CWE Top 25 2025, et c'est le point : ce ne sont pas des défaillances exotiques de modèle, ce sont les faiblesses les mieux documentées du métier.
- Injection (CWE-89, CWE-78). Du SQL et des commandes shell concaténés à partir d'entrées utilisateur, parce que le modèle les a appris sur un corpus qui en regorge. L'injection SQL est deuxième et l'injection de commande OS neuvième au CWE Top 25 2025. Voyez pourquoi la plupart des constats SAST sont du bruit : seuls les constats atteignables méritent votre temps.
- Autorisation rompue et IDOR (CWE-862, CWE-639). L'agent construit l'endpoint qui renvoie l'enregistrement, rarement la vérification que l'appelant en est propriétaire. L'autorisation manquante est quatrième dans la même liste, et l'OWASP place la catégorie parente en tête : A01:2025 Broken Access Control « maintaining its position at #1 in the Top Ten », avec « 100% of the applications tested » présentant une forme de contrôle d'accès rompu. C'est la classe qui vous met le plus directement face à vos obligations RGPD.
- Secrets en dur (CWE-798). Sommé de livrer une intégration qui fonctionne, le modèle met une clé d'API en ligne pour que le code tourne du premier coup, et le secret vit ensuite dans le dépôt, dans l'historique et dans chaque fork. Cette classe ne figure pas au CWE Top 25 2025, ce n'est donc pas là que vous irez la chercher.
- Validation d'entrée manquante (CWE-20). Les endpoints générés font confiance à leurs entrées, activateur discret de l'injection et de la désérialisation en aval. Dix-huitième au classement 2025.
- Désérialisation non sécurisée (CWE-502). « Recharge l'objet enregistré » devient un
picklesur des octets non fiables, et transforme un blob stocké en exécution de code à distance. Quinzième au classement 2025. - Failles de logique métier. La plus dangereuse, parce qu'aucun scanner n'est taillé pour l'attraper : un panier à quantité négative, un coupon qui se cumule, un remboursement qui saute la vérification de propriété. Le code est syntaxiquement parfait et sémantiquement faux, et il n'apparaît dans aucun classement CWE parce qu'il est propre à votre domaine. C'est notre analyse des failles de logique métier dans le code généré par IA.
Que ratent les scanners, et les modèles eux-mêmes ?
Deux choses. La logique métier, qui n'offre aucun point d'exécution dangereux à faire correspondre, et les angles morts du modèle, qu'il ne peut pas auditer tant qu'ils sont en place. SusVibes a mesuré le second : ajouter des indices de vulnérabilité à la demande de fonctionnalité n'a pas atténué les problèmes de sécurité. Prompter plus fort n'est pas la parade.
Le premier angle mort, c'est la logique métier. Un analyseur statique raisonne sur des motifs de code ; une règle métier (« seul le propriétaire peut modifier ce document », « la quantité doit rester positive ») vit hors du code, dans votre domaine. Il n'y a ni entrée corrompue ni point d'exécution dangereux à faire correspondre, juste une instruction if qui n'a jamais été écrite : le scanner rapporte le fichier comme propre alors qu'il est pleinement exploitable, et c'est cette classe qui expose des données réelles sans déclencher la moindre alerte technique.
Le second, c'est le modèle qui corrige sa propre copie. Demander au même agent qui a écrit le code de le relire revient à hériter des mêmes angles morts : il ne connaît pas votre modèle d'autorisation, il ne voit pas les autres constats autour de la ligne, et il est aussi confiant sur la version non sécurisée que sur la version sécurisée. C'est l'écart connaissance-actuation vu depuis le siège du relecteur. Une vérification digne de confiance a besoin d'un signal extérieur : une analyse consciente de l'atteignabilité, et vos propres règles chargées comme vérité de terrain.
La question n'est pas de savoir si l'IA écrit du code non sécurisé, tout auteur en écrit. Elle est de savoir si quelque chose attrape la ligne non sécurisée avant qu'elle ne parte en production, et à la vitesse de l'IA le seul endroit où l'attraper, c'est là où la ligne s'écrit.
Peut-on faire confiance à une IA pour corriger ses propres vulnérabilités ?
Vous pouvez lui faire confiance pour appliquer une correction bien plus que pour décider ce qui constitue une vulnérabilité réelle et atteignable. Elle réécrit très bien une ligne dès lors qu'elle sait exactement quoi changer, et elle juge très mal l'exploitabilité, qu'un scanner a déjà calculée. Donnez-lui donc des constats confirmés et vos règles, laissez-la corriger, et approuvez chaque diff.
Nous détaillons cette boucle dans la remédiation des vulnérabilités par IA et dans la question de savoir si un agent peut trouver et corriger les vulnérabilités automatiquement.
Ce qui ne marche pas, c'est d'écrire les règles dans un fichier et d'espérer. Dans notre étude contrôlée du 24 août 2026, 30 tickets de développeur ont été rejoués en triplicat sur une base de code de taille moyenne, soit 90 exécutions autonomes et 93 analyses de sécurité indépendantes, avec Claude Opus 5 à effort élevé. Un fichier de règles réaliste, maintenu à la main dans le dépôt, a implémenté exactement 7 spécificités de règle sur 55, soit 13 %, contre 8 sur 65 sans aucun fichier, soit 12 % : il n'a presque rien changé. Les mêmes règles délivrées au moment de l'édition atteignent 57 sur 64, soit 89 %. L'écart ne tient pas au contenu des règles, il tient au moment où elles arrivent.
L'étude publie aussi ses limites : un ticket où le bras non assisté a fait mieux, un autre où la règle a été servie treize fois et où l'agent a quand même démonté ses propres garde-fous, et un protocole qui mesure le maintien à zéro sur une base déjà saine plutôt que la résorption d'un arriéré. Une couche de gouvernance déplace la moyenne, elle ne supprime pas la revue humaine.
Comment rendre le code généré par IA sûr ?
Vous déplacez le contrôle au moment où le code s'écrit, puis vous gardez l'analyse et la revue humaine derrière. Trois mouvements, par ordre de levier : gouverner ce que l'agent écrit avant qu'il ne l'écrive, renvoyer les constats confirmés des scanners dans la boucle, et conserver une barrière en CI plus un humain qui approuve les diffs.
- Gouverner au moment de la génération. Chargez vos règles de sécurité et métier dans l'agent avant chaque édition, pour que le motif sûr soit celui vers lequel il se tourne par défaut. La vulnérabilité jamais écrite ne demande aucun tri, aucune notification et aucun post-mortem. C'est l'idée centrale de la sécurité des agents de code IA.
- Analyser en continu et renvoyer les constats à l'agent. Gardez en marche l'analyse SAST consciente de l'atteignabilité, le SCA, les secrets, l'IaC et le CI/CD, et mettez leurs constats confirmés entre les mains de l'agent pour qu'il corrige les vrais dans la boucle. Dans notre étude, les nouveaux constats de sécurité introduits par tâche tombent de 0,10 sans outil à 0,033 avec la couche, et le décompte du scanner indépendant passe de 1 à 4 sur le bras non assisté au fil de trente tickets, tandis que le bras gouverné reste à 1.
- Garder la CI et la revue humaine en filet. Une barrière SAST sur chaque pull request et un humain qui approuve les diffs attrapent ce qui passe. Nécessaires, mais à la vitesse de l'IA ils ne peuvent plus être la seule ligne.
La version pratique complète, c'est comment ajouter de la sécurité à votre workflow de code IA et comment sécuriser toute une application en cinq minutes.
VibeDefend est la couche qui fait les deux premiers mouvements. C'est un CLI npm gratuit qui s'installe en quelques secondes et câble Claude Code, Cursor, Windsurf, OpenAI Codex et VS Code Copilot dans quatre couches de gouvernance, à l'intérieur de la boucle de l'agent.

Trois couches gouvernent ce que l'agent écrit : les Business Rules extraites de votre dépôt, les Security Rules issues des familles OWASP, SOC 2, RGPD et ISO 27001, et un Action Guard qui bloque les appels destructeurs. La quatrième, Live Findings, câble l'agent dans la plateforme d'analyse de CybeDefend, avec le SAST, le SCA, les secrets, l'IaC et le CI/CD en continu et chaque constat en direct dans son contexte. L'agent n'écrit donc pas seulement du code plus sûr, il corrige aussi les vulnérabilités que vous portez déjà. Rien de votre code ne traverse le réseau, seules des métadonnées de gouvernance structurées circulent, sur des régions UE ou US physiquement séparées.
Questions fréquentes
Des réponses courtes, chacune adossée aux sources citées plus haut : l'étude NYU sur Copilot de 2021, le benchmark SusVibes révisé en août 2026, la systématisation de l'University at Buffalo de juin 2026, l'OWASP Top 10:2025 et notre propre étude contrôlée du 24 août 2026.
Le code généré par IA est-il sûr ?
Pas par défaut. Il s'exécute et passe le chemin heureux, mais les tests indépendants en trouvent régulièrement une large part non sécurisée : environ 40 % des complétions de Copilot étaient vulnérables dans l'étude NYU « Asleep at the Keyboard » de 2021, et dans le benchmark SusVibes révisé en août 2026, la meilleure configuration d'agent était fonctionnellement correcte sur 57 % des demandes de fonctionnalité réelles alors que 11,8 % seulement de ses solutions étaient sécurisées. Il devient sûr quand un contrôle agit là où le code s'écrit, avec la revue humaine et l'analyse en CI derrière.
Est-il sûr de déployer du code généré par IA en production ?
Seulement après l'avoir relu et analysé comme n'importe quel code, et idéalement après l'avoir gouverné au moment où il s'écrivait. Passer directement de « ça marche » à la production est risqué parce que les failles concernées (autorisation manquante, injection, secrets en dur, logique métier) n'affectent pas le chemin heureux et survivent à un test fonctionnel. SusVibes a mesuré cet écart : 79,3 % des solutions fonctionnellement correctes du meilleur agent portaient quand même une vulnérabilité. Mettez une barrière SAST consciente de l'atteignabilité en CI, une revue humaine sur les chemins sensibles, et un contrôle au moment du prompt.
Pourquoi le code généré par IA est-il non sécurisé si le modèle est si capable ?
Parce que savoir produire du code qui fonctionne n'est pas savoir produire du code sécurisé. La systématisation de l'University at Buffalo de juin 2026 appelle cela l'écart connaissance-actuation et le mesure à 47,9 points sur CWEval et 72,9 points sur BaxBench : le modèle connaît le principe et échoue à l'appliquer à la bonne frontière d'implémentation. Ajoutez-y le corpus, saturé de motifs non sécurisés, l'absence, puisque la sécurité est un garde-fou que personne ne demande, et le lecteur, qui sait rarement évaluer la sûreté de ce qu'il génère. Aucun des trois ne se règle avec un modèle plus intelligent.
Puis-je simplement demander à l'IA de vérifier elle-même son code pour les vulnérabilités ?
Cela aide un peu et ne suffit pas. Le même modèle qui a écrit le code partage ses angles morts : il ne connaît ni votre modèle d'autorisation ni votre délimitation de tenant, il ne voit pas les autres constats autour de la ligne, et il est aussi confiant sur la version non sécurisée que sur la version sécurisée. SusVibes a testé le contournement évident : ajouter des indices de vulnérabilité à la demande de fonctionnalité n'a pas atténué les problèmes de sécurité. Une vérification digne de confiance a besoin d'un signal extérieur, l'atteignabilité et vos propres règles comme vérité de terrain.
Quelles sont les vulnérabilités les plus courantes dans le code généré par IA ?
L'injection (CWE-89, CWE-78), l'autorisation rompue et l'IDOR (CWE-862, CWE-639), les secrets en dur (CWE-798), la validation d'entrée manquante (CWE-20), la désérialisation non sécurisée (CWE-502) et les failles de logique métier. Quatre de ces six classes ont une entrée au CWE Top 25 2025, et l'OWASP classe le contrôle d'accès rompu premier pour 2025 en rapportant que 100 % des applications testées en présentaient une forme. Les cinq premières sont détectables par de bons scanners dès lors que vous filtrez par atteignabilité ; la logique métier est la dangereuse, parce qu'aucun scanner n'attrape une règle syntaxiquement parfaite et sémantiquement fausse.
Comment rendre le code généré par IA sûr ?
Déplacez le contrôle au moment de la génération : chargez vos règles de sécurité et métier dans l'agent pour qu'il écrive d'abord le motif sûr, analysez en continu et renvoyez les constats confirmés à l'agent pour qu'il corrige, et gardez une barrière SAST en CI plus la revue humaine en filet. Écrire les règles dans un fichier du dépôt ne suffit pas : dans notre étude contrôlée du 24 août 2026, un fichier de règles réaliste a implémenté exactement 7 spécificités sur 55, soit 13 %, contre 8 sur 65 sans aucun fichier, soit 12 %, alors que les mêmes règles délivrées au moment de l'édition atteignaient 57 sur 64, soit 89 %.


