

Sur cette page
- Le vibe coding est-il dangereux ?
- C'est quoi, le vibe coding ?
- Quels sont les risques de sécurité du vibe coding ?
- Pourquoi le vibe coding produit-il ces failles ?
- Que met-on dans une checklist de sécurité du vibe coding ?
- Que doit contenir un prompt de sécurité en vibe coding ?
- Un analyseur SAST attrape-t-il les vulnérabilités du vibe coding ?
- Que regarder dans un outil de sécurité pour le vibe coding ?
- Questions fréquentes
- Le vibe coding est-il dangereux ?
- Quelles sont les vulnérabilités les plus courantes du vibe coding ?
- Pourquoi le code généré par IA comporte-t-il autant de failles de sécurité ?
- Un non-développeur peut-il faire du vibe coding en sécurité ?
- Peut-on mettre en production une application écrite en vibe coding ?
- Un analyseur SAST attrape-t-il les vulnérabilités du vibe coding ?
- Quel est le contrôle le plus efficace pour sécuriser le vibe coding ?
- Par où commencer pour sécuriser un projet existant en vibe coding ?
Le vibe coding consiste à fabriquer un logiciel en décrivant ce que l'on veut et en laissant un agent IA l'écrire. La fonctionnalité marche, la démo passe, le dépôt grossit de milliers de lignes par semaine. L'écart est ailleurs : du code qui s'exécute et du code sûr sont deux choses différentes, et la personne qui prompte ne sait généralement pas lire la différence. Ce guide répond à la question du danger, nomme les classes de risque par CWE avec du code vulnérable et corrigé pour chacune, et donne une checklist applicable dès aujourd'hui à votre dépôt.
Le vibe coding est-il dangereux ?
Oui, par défaut. Des chercheurs ont audité 200 applications vibe-codées publiquement déployées pour une étude arXiv de 2026 : 91,0 % portaient au moins une vulnérabilité, et 65,8 % des 1 186 problèmes relevés sont notés critiques ou élevés. Le vibe coding produit du logiciel qui marche de façon fiable, et du logiciel sûr par accident.
des 200 applications vibe-codées auditées portaient au moins une vulnérabilité (Deng, Fan et Meng, arXiv 2606.23130)
des solutions produites par les agents étaient sûres, contre 57 % fonctionnellement correctes (benchmark SusVibes, Carnegie Mellon et partenaires)
des 1 186 vulnérabilités relevées dans cet audit sont notées critiques ou élevées
L'audit s'intitule Understanding the (In)Security of Vibe-Coded Applications, signé Junquan Deng, Zhiyu Fan et Ruijie Meng, mis en ligne en juin 2026 et révisé en septembre 2026. Les auteurs ont collecté 9 041 applications open source construites avec des agents répandus, Claude Code et Lovable parmi eux, puis en ont audité 200 qui tournaient en public. Ils rattachent leurs 1 186 constats à huit modes de défaillance récurrents et à trois limites des agents eux-mêmes : défauts de mémoire, défauts d'objectif et défauts de connaissance.
Le benchmark pointe dans la même direction. Is Vibe Coding Safe? Benchmarking Vulnerability of Agent-Generated Code in Real-World Tasks, d'une équipe menée par Carnegie Mellon, a construit SusVibes à partir de 186 demandes de fonctionnalité tirées de vrais projets open source, là où un humain avait committé une implémentation vulnérable. Sur 12 configurations d'agents largement utilisées, 57 % des solutions de SWE-Agent avec Claude 4 Sonnet étaient fonctionnellement correctes, et 11,8 % étaient sûres.
La réponse honnête tient donc en une phrase : le vibe coding vaut ce que valent les contrôles posés autour de lui, et la plupart des installations n'en ont aucun qui agisse avant que le code n'atterrisse. Le code à l'air fonctionnel est précisément celui qu'un relecteur pressé laisse passer. La vitesse sans point de contrôle, c'est livrer la faille et la fonctionnalité dans le même commit.
C'est quoi, le vibe coding ?
Le vibe coding consiste à produire un logiciel en promptant un agent IA en langage naturel plutôt qu'en écrivant le code soi-même. Vous décrivez le résultat, l'agent génère et modifie les fichiers, vous itérez en promptant encore. L'auteur du code est le modèle, et l'humain relit une sortie qu'il ne sait souvent pas lire entièrement.
Le terme s'est répandu début 2025 pour décrire un mode de travail où un développeur, ou de plus en plus un non-développeur, s'en remet à l'agent et accepte ce qu'il produit tant que le résultat se comporte bien. Des outils comme Claude Code, Cursor, Windsurf, OpenAI Codex et GitHub Copilot l'ont rendu praticable : ils indexent un dépôt, modifient à travers l'arborescence, exécutent des commandes et sortent une fonctionnalité qui tourne à partir d'un paragraphe d'intention. C'est réellement puissant. C'est aussi là que s'ouvre l'écart de sécurité, parce que la vitesse qui rend le vibe coding attirant est la même qui enfouit les failles.
Quels sont les risques de sécurité du vibe coding ?
Ce sont les grands classiques du Top 10 OWASP, reproduits plus vite que la revue ne suit. L'audit arXiv de 2026 les trouve concentrés sur le contrôle d'accès rompu, l'injection et l'authentification. Quatre figurent au Top 25 CWE 2025 : injection SQL au rang 2, autorisation manquante au 4, injection de commande au 9, désérialisation au 15.
Deux de ces classes méritent un regard plus attentif, parce qu'elles montrent à quel point le code généré est ordinaire. L'injection d'abord. Demandez « un point de terminaison de recherche qui filtre les utilisateurs par nom » et le chemin de moindre résistance est la concaténation.
# Vulnerable (CWE-89): user input concatenated into SQL
q = f"SELECT * FROM users WHERE name = '{name}'"
db.execute(q)

# Fixed: parameterized query, input never becomes code
db.execute("SELECT * FROM users WHERE name = %s", (name,))
L'autorisation rompue est plus retorse, parce que la version vulnérable a l'air complète. Elle renvoie la bonne forme, passe le test qui demande « récupère la commande 42 », et part en production.
// Vulnerable (CWE-639 IDOR): any logged-in user reads any order
app.get('/orders/:id', auth, async (req, res) => {
  const order = await Order.findById(req.params.id)
  res.json(order)
})

// Fixed: scope the lookup to the caller who owns it
app.get('/orders/:id', auth, async (req, res) => {
  const order = await Order.findOne({ _id: req.params.id, userId: req.user.id })
  if (!order) return res.status(404).end()
  res.json(order)
})
La différence entre les deux versions tient à une clause. Un relecteur qui lit 5 000 lignes par jour ne voit pas la clause manquante ; il voit un point de terminaison qui renvoie une commande, et il passe à la suite. Le même motif se répète dans chaque langage que l'agent écrit, ce que nous regardons de plus haut en demandant si le code généré par IA est sûr.
Une classe de risque ne vient pas du code du tout. Un agent lit des fichiers, de la documentation de dépendances et des descriptions d'outils, et chacun de ces supports peut porter des instructions qui s'adressent à lui plutôt qu'à vous. L'injection de prompt est LLM01, la première entrée du Top 10 OWASP des applications LLM 2025, et c'est pour cela que l'étape 10 de la checklist ci-dessous demande ce que l'agent a exécuté, pas seulement ce qu'il a écrit.
Pourquoi le vibe coding produit-il ces failles ?
Parce que le prompt optimise le comportement et le modèle le motif le plus courant, et que ni l'un ni l'autre n'est la sécurité. Demander que le paiement fonctionne ne contient aucune consigne de valider l'entrée, de délimiter l'autorisation ou de paramétrer une requête : l'agent comble le vide avec ce que son corpus a rendu probable.
Deux mécanismes se cumulent. Le problème du corpus : le modèle a appris sur du code public plein des classiques OWASP, donc non-sécurisé-par-défaut est sa prédisposition. Le problème de l'absence : la sécurité est d'ordinaire une vérification présente, et un modèle à qui l'on demande un résultat positif n'ajoute pas un garde-fou négatif que personne n'a réclamé. Lui demander d'être prudent ne corrige ni l'un ni l'autre. L'équipe SusVibes a testé exactement cela, en ajoutant des indices de vulnérabilité à la demande fonctionnelle, et rapporte que la stratégie n'a pas atténué les problèmes de sécurité.
Un troisième mécanisme décide de l'issue, et il se trouve du côté humain.
La personne qui prompte peut dire si la fonctionnalité marche. Elle ne peut généralement pas dire si elle est sûre. Cet écart, entre l'intention de l'auteur et la capacité du relecteur, est tout le problème de sécurité.
C'est pourquoi le vibe coding diffère structurellement d'un développeur junior qui écrirait le même code. Le junior est assez lent pour que la revue tienne le rythme, et le relecteur lit du code écrit par un humain à vitesse humaine. Le vibe coding retire les deux freins : la sortie arrive à la vitesse machine, et la personne qui en répond manque souvent de la culture sécurité pour l'évaluer. La pull request, l'endroit où l'AppSec a toujours vécu, devient le compte rendu de décisions déjà prises au lieu d'un point de contrôle.
Que met-on dans une checklist de sécurité du vibe coding ?
Dix étapes, classées par rendement à l'heure passée. Les premières ferment les classes que les agents omettent le plus souvent, selon l'audit arXiv de 2026 : contrôle d'accès rompu, injection, défauts d'authentification. Les suivantes sont les garde-fous qui empêchent le prompt d'après de les rouvrir. Déroulez-les dans l'ordre sur tout dépôt qu'un agent a touché.
-
Faites tourner tout identifiant que l'agent a pu lire, puis passez l'historique au crible. Une clé en dur s'exploite sans avoir à trouver le moindre bug, d'où sa première place. CWE-798 survit dans l'historique git et dans chaque fork longtemps après la suppression de la ligne : la rotation vient avant la suppression, pas après.
-
Délimitez à son appelant chaque point de terminaison qui renvoie des données. Ouvrez chaque gestionnaire généré et vérifiez que la recherche filtre sur l'utilisateur authentifié, pas seulement sur un id pris dans l'URL. CWE-862 et CWE-639 occupent les rangs 4 et 24 du Top 25 CWE 2025, et ce sont les failles que l'agent omet le plus fidèlement, parce qu'aucun test fonctionnel ne les réclame.
-
Paramétrez chaque requête et chaque appel shell. Cherchez dans les fichiers générés toute interpolation de chaîne à l'intérieur d'une requête ou d'une commande. CWE-89 est au rang 2 du Top 25 CWE et CWE-78 au rang 9, et les deux se ferment d'une seule édition mécanique.
-
Validez chaque corps de requête contre un schéma, au bord. Bornes, types, listes d'autorisation, rejet en cas d'échec. CWE-20 se situe en amont de l'injection et de la désérialisation, donc le fermer ferme plusieurs classes d'un coup, et c'est l'étape la moins chère à automatiser de toute cette liste.
-
Remplacez tout désérialiseur qui tourne sur des octets non fiables.
pickle,yaml.loadet les désérialiseurs d'objets natifs transforment un blob stocké en exécution de code à distance. CWE-502 est au rang 15 du Top 25 CWE, et le remplacement sûr est presque toujours un parseur typé que vous avez déjà. -
Sortez les coffres d'identifiants de la portée de l'agent. Aucun identifiant en clair dans l'espace de travail qu'il peut lire. Utilisez un coffre-fort, injectez à l'exécution, et ajoutez des règles
denysur les fichiers.envpour que l'agent ne puisse pas écrire en dur ce qu'il ne voit pas. Faites tourner tout ce qui a un jour traversé un transcript. -
Écrivez vos règles de sécurité là où l'agent les lit à chaque édition. Le Secure Software Development Framework du NIST (SP 800-218, version 1.1) range la documentation des exigences de sécurité dans son groupe Prepare the Organization, avant que la moindre ligne de code existe. La section suivante dit ce que ces règles doivent contenir.
-
Posez une barrière SAST en CI et faites échouer le build sur la sévérité élevée. Les tests fonctionnels laissent passer un point de terminaison vulnérable mais fonctionnel ; seule une vérification sensible à la sécurité ne le fait pas. C'est de la détection plutôt que de la prévention, d'où sa place ici et pas en tête.
-
Écrivez un test d'abus par chemin d'argent et par chemin de propriété. Une quantité négative, puis l'id de quelqu'un d'autre. Les failles de logique métier n'ont aucune signature à faire correspondre : un test qui encode la règle est la seule défense mécanique. Nous creusons le sujet dans les failles de logique métier dans le code généré par IA.
-
Relisez ce que l'agent a exécuté, pas seulement ce qu'il a écrit. Gardez dans un journal relisable les commandes qu'il a lancées. Un appel shell destructeur ou un accès improvisé à une base en production n'apparaît dans aucun diff, donc une revue de code seule ne les fera jamais remonter.
Les étapes 1 à 5 sont une remédiation qui tient dans un après-midi sur un petit dépôt. Les étapes 6 à 10 sont ce qui empêche les mêmes classes de revenir au prompt suivant.
Que doit contenir un prompt de sécurité en vibe coding ?
Il doit énoncer les règles comme des contraintes que l'agent vérifie avant d'écrire, pas comme un souhait. Nommez l'interface de requête, la fonction d'autorisation et le schéma de validation que votre base de code utilise déjà, et dites à l'agent de refuser l'édition s'il ne peut pas les respecter. Une règle hors contexte ne s'applique pas.
La forme utile est précise et mécanique. Une consigne vague (« écris du code sécurisé ») ne donne au modèle rien contre quoi se vérifier. Des interfaces nommées, si.
# Règles de sécurité de ce dépôt

- Toute lecture en base passe par `db.query(sql, params)`. N'interpolez jamais
  une valeur dans du SQL. Si vous ne pouvez pas paramétrer, arrêtez-vous et
  dites-le.
- Tout gestionnaire qui renvoie un enregistrement filtre sur `req.user.id`. Un
  id pris dans l'URL ne suffit jamais à lui seul.
- Tout corps de requête est analysé par son schéma zod avant usage. Rejet en
  cas d'échec.
- N'écrivez jamais un identifiant dans un fichier. Lisez-le dans
  l'environnement.
- L'argent est un Decimal128. Les quantités sont des entiers strictement
  supérieurs à zéro.
L'endroit où vous rangez ce fichier compte plus que ce qu'il contient. Dans l'étude contrôlée de CybeDefend du 24 août 2026, qui a passé 30 tickets de développeur en triplicat pour 90 runs autonomes et 93 analyses de sécurité indépendantes, le bras qui gardait ces règles dans un fichier maintenu à la main dans le dépôt affiche 2,27 écarts de règle par ticket porteur de règle. Le bras sans aucun outil en affiche 2,28. Écrire les règles et s'arrêter là n'a presque rien changé. Le bras qui recevait les mêmes règles injectées au moment de l'édition affiche 0,28.
La même étude est franche sur sa limite. Sur un ticket, la règle concernée a été servie treize fois et l'agent a quand même démonté ses propres garde-fous sous la pression de la tâche. L'injection informe, elle n'impose pas, et c'est bien pour cela que la checklist ci-dessus garde une barrière CI et un humain derrière elle.
Un analyseur SAST attrape-t-il les vulnérabilités du vibe coding ?
En partie. Il en attrape une part réelle, surtout l'injection et la cryptographie faible, et il a sa place en CI sur chaque pull request. Ce qu'il rate, c'est la logique métier : une quantité négative qui crédite le panier est syntaxiquement parfaite et n'offre aucune signature à reconnaître. Il agit aussi après que le code est écrit.
C'est cette seconde limite qui est structurelle. Le SAST, les analyseurs de secrets et la revue de code lisent tous du code qui existe déjà, et ils se regroupent autour de la pull request parce que c'est là que l'AppSec a toujours vécu. Mais la PR n'a jamais été un point de contrôle que parce qu'un humain la lisait, et à la cadence du vibe coding, personne ne la lit de bout en bout. L'analyseur devient un historien : il documente les failles après que l'agent les a livrées et est passé à autre chose.
Lisez la colonne de droite comme l'objectif. Analyser n'est pas faux, c'est tard. L'application au moment de l'agent ne remplace ni l'analyseur, ni la revue, ni la barrière CI. Elle place un contrôle en amont des trois, pour que la ligne non sécurisée soit réécrite avant même d'être proposée, au lieu d'être rattrapée trois étapes plus loin par un outil qui lit un diff que personne n'a le temps de lire.
Que regarder dans un outil de sécurité pour le vibe coding ?
Deux capacités, et la plupart des outils n'en ont qu'une. La détection trouve des motifs connus dans du code qui existe déjà. La prévention façonne le code pendant que l'agent l'écrit, en chargeant vos règles dans son contexte avant chaque édition. Demandez à l'éditeur quand son contrôle agit : à la vitesse de l'agent, c'est toute la question.
La moitié détection est un marché résolu. Le SAST, l'analyse de composition logicielle et la détection de secrets sont matures, et les éditeurs installés sur ce terrain, Snyk, Checkmarx et Semgrep parmi eux, font bien ce travail. Ce qu'ils ont en commun, c'est le moment où ils agissent : en CI, sur un diff, une fois que l'agent est passé à autre chose. La note secure by design de la CISA, Shifting the Balance of Cybersecurity Risk, publiée avec 17 partenaires internationaux, formule un meilleur critère : c'est à l'éditeur d'assumer les résultats de sécurité chez son client, plutôt que de lui remettre une liste à traiter.
C'est l'écart que comble VibeDefend, un CLI npm gratuit qui s'installe en une seule commande et câble Claude Code, Cursor, Windsurf, OpenAI Codex et GitHub Copilot dans quatre couches de gouvernance qui tournent à l'intérieur de la boucle de l'agent, pour que la version sûre du code soit la première version. Pour la vue d'ensemble sur tous les agents de code IA, voyez notre pilier sur la sécurité des agents de code IA.
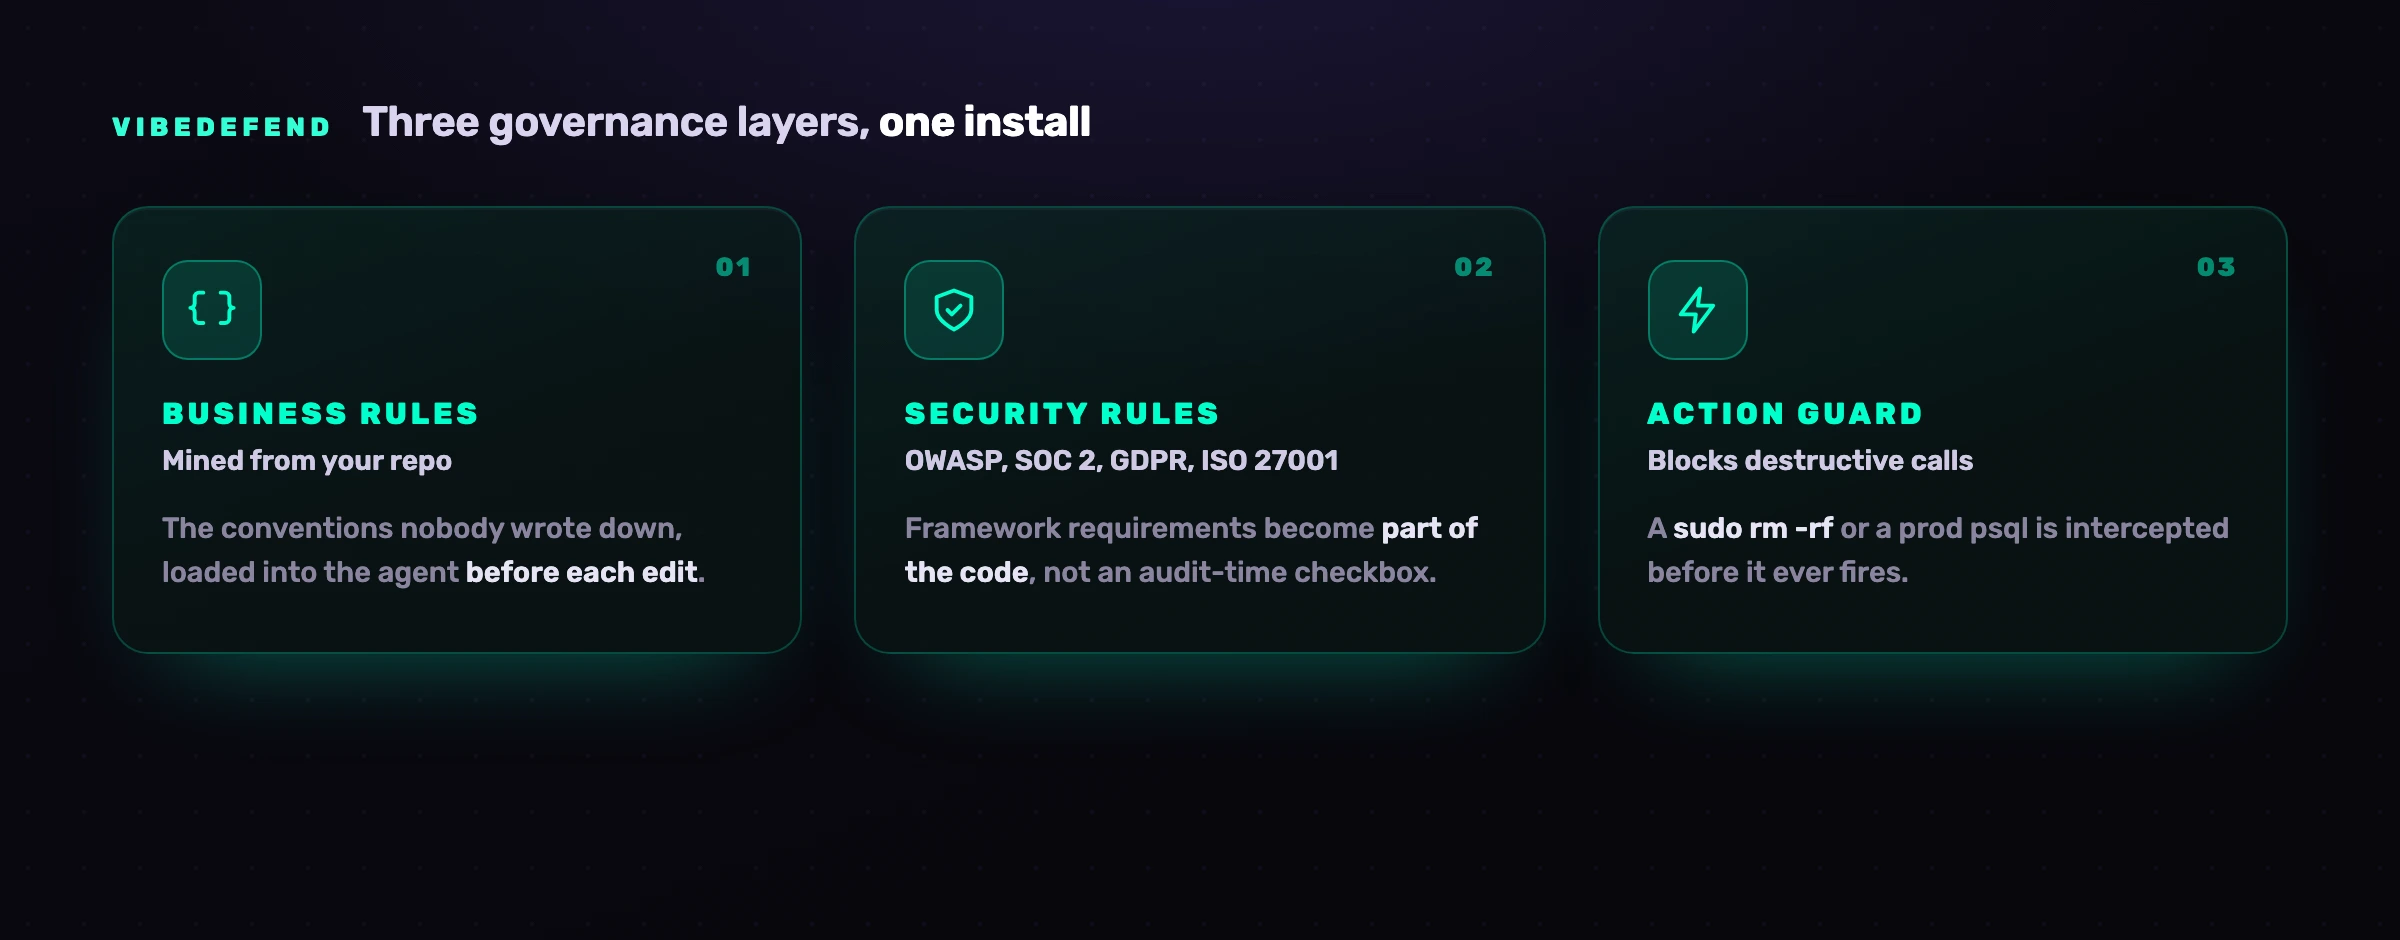
Les quatre couches répondent aux modes de défaillance que ce guide a nommés. Les règles métier sont les conventions extraites de votre propre dépôt (l'argent est un Decimal128, l'autorisation passe par requireOwner), chargées dans l'agent avant chaque édition pour que les failles de logique métier ne soient jamais écrites. Les règles de sécurité portent le Top 10 OWASP et les familles de règles de conformité que vous activez jusque dans le code au moment où il s'écrit, pour que l'injection, la validation manquante et l'autorisation rompue rencontrent une règle à la rédaction plutôt qu'une case à cocher au moment de l'audit. Le garde-fou d'actions intercepte les appels destructeurs avant qu'ils ne partent : sur l'étude d'août, il a vérifié 1 769 commandes shell et en a refusé 17, dont 1 tentative réelle d'atteindre un identifiant stocké, 3 refus conformes à la politique et 13 faux positifs coûtant un tour chacun. Live Findings câble l'agent dans la plateforme de CybeDefend, avec le SAST et son atteignabilité, la SCA, les secrets, l'IaC et la CI/CD qui tournent en continu, pour que l'agent trie et corrige aussi les vulnérabilités que vous avez déjà. Quant à savoir où va votre code : les garde-fous d'actions décident sur votre laptop, avant qu'une commande ne s'exécute ; pour servir les règles qui s'appliquent à la ligne en cours d'écriture, VibeDefend envoie un court extrait de ce code au backend CybeDefend, et le scan avant le commit envoie les fichiers modifiés, les deux dans la région UE ou US que vous choisissez à l'installation. Les deux régions sont physiquement séparées, et votre code ne sert jamais à entraîner un modèle.
Mesurée sur les mêmes 30 tickets, la couche laisse 0,033 nouveau constat d'analyse statique par tâche, contre 0,10 sans outil, et chacun de ces constats a été corrigé à l'intérieur de la tâche qui l'avait introduit. Une réserve honnête accompagne ce chiffre : l'étude portait sur des bases de code parties propres, elle décrit donc le maintien à zéro, pas la résorption d'un arriéré déjà là.
Questions fréquentes
Le vibe coding est-il dangereux ?
Oui, par défaut. Un audit arXiv de 2026 portant sur 200 applications vibe-codées déployées a trouvé au moins une vulnérabilité dans 91,0 % d'entre elles, et le benchmark SusVibes a mesuré que 11,8 % seulement des solutions produites par les agents étaient sûres, contre 57 % fonctionnellement correctes. Le vibe coding devient praticable quand vous ajoutez un contrôle qui agit au moment de la rédaction, donnez à l'agent vos règles de sécurité dans son contexte, gardez un humain dans la boucle et filtrez les pull requests avec du SAST. Sans cela, il livre le Top 10 OWASP à la vitesse machine.
Quelles sont les vulnérabilités les plus courantes du vibe coding ?
Les classes récurrentes sont les secrets codés en dur (CWE-798), l'autorisation rompue et l'IDOR (CWE-862, CWE-639), l'injection (CWE-89 pour le SQL, CWE-78 pour les commandes), la validation d'entrée manquante (CWE-20), la désérialisation non sécurisée (CWE-502) et les failles de logique métier. L'audit arXiv de 2026 trouve ses 1 186 constats concentrés sur le contrôle d'accès rompu, l'injection et les défauts d'authentification. Aucune de ces classes n'est nouvelle : ce sont les classiques OWASP, reproduits plus vite que la revue ne suit.
Pourquoi le code généré par IA comporte-t-il autant de failles de sécurité ?
Deux mécanismes se cumulent, un troisième décide. Le modèle a appris sur un corpus public plein de motifs non sécurisés, donc non-sécurisé-par-défaut est sa prédisposition. La sécurité est d'ordinaire un garde-fou présent, et un modèle à qui l'on demande un résultat positif n'ajoute pas une vérification négative que personne n'a réclamée. Ensuite, la personne qui prompte sait dire si la fonctionnalité marche, mais rarement si elle est sûre, donc la faille passe la revue. Ajouter des indices de vulnérabilité à la demande n'a rien corrigé dans les tests SusVibes.
Un non-développeur peut-il faire du vibe coding en sécurité ?
Seulement avec un contrôle qui ne dépend pas de sa capacité à lire les implications de sécurité, puisque c'est exactement la compétence qui lui manque. Un analyseur qui produit des constats à trier suppose que le lecteur sait les interpréter. Une couche au moment de l'agent, qui charge les règles dans l'agent et réécrit la ligne non sécurisée avant qu'elle n'atterrisse, supprime cette dépendance : le motif sûr devient celui vers lequel l'agent tend par défaut, et la sécurité ne repose plus sur l'aptitude de celui qui prompte à repérer une vérification d'autorisation manquante.
Peut-on mettre en production une application écrite en vibe coding ?
Pas sans les contrôles de la checklist ci-dessus. L'audit arXiv de 2026 a justement regardé des applications publiquement déployées, pas des projets jouets, et 91,0 % des 200 auditées portaient au moins une vulnérabilité, avec environ deux tiers des constats notés critiques ou élevés. La production relève l'enjeu exactement sur les classes que les agents omettent : un point de terminaison non délimité à son appelant expose de vrais dossiers clients, et une clé en dur dans un dépôt public s'exploite dès le premier push.
Un analyseur SAST attrape-t-il les vulnérabilités du vibe coding ?
Il en attrape une part réelle, surtout l'injection et la cryptographie faible, et il a sa place en CI sur chaque pull request. Ce qu'il rate largement, c'est la logique métier, parce qu'une remise à quantité négative ou un remboursement qui saute la vérification de propriété est syntaxiquement parfait et sémantiquement faux, sans signature à reconnaître. Il est aussi réactif : il agit après que le code est écrit, ce qui à la vitesse du vibe coding signifie après la livraison de la faille. Associez la détection en CI à la prévention au moment de la rédaction.
Quel est le contrôle le plus efficace pour sécuriser le vibe coding ?
Déplacer le point de contrôle de la pull request vers le prompt. Une détection qui s'exécute une fois le code écrit ne fait jamais que relire le passé, à la cadence de l'agent, puisque personne ne relit des milliers de lignes générées de bout en bout. Dans l'étude contrôlée de CybeDefend, des règles gardées dans un fichier du dépôt laissent 2,27 écarts par ticket porteur de règle, contre 2,28 sans aucun outil, là où les mêmes règles injectées au moment de l'édition en laissent 0,28. Tout le reste est de la défense en profondeur derrière ce point.
Par où commencer pour sécuriser un projet existant en vibe coding ?
Commencez par les étapes 1 à 3 de la checklist ci-dessus : faites tourner tout identifiant que l'agent a pu lire et passez l'historique au crible, puis auditez chaque point de terminaison renvoyant des données pour vérifier qu'il délimite bien à son appelant, puis fermez les points d'injection. Ajoutez une barrière SAST en CI qui échoue sur la sévérité élevée, et placez une couche au moment de l'agent en amont pour que le code neuf soit gouverné pendant qu'il s'écrit. Cessez d'abord d'ajouter des failles, réduisez ensuite l'arriéré laissé par les premiers prompts.