


Sur cette page
- Que veut dire « contexte » pour un agent de code ?
- Quelles sont les limites de CLAUDE.md, d'AGENTS.md et des skills ?
- CLAUDE.md : lu une fois, suivi quand ça tombe bien
- AGENTS.md : le même fichier, partagé par davantage d'agents
- Skills : chargés quand l'agent y pense
- Ce qu'aucun d'eux ne fait
- Pourquoi l'agent perd-il la règle avant d'écrire ?
- CLAUDE.md, rules, skills, MCP ou hooks : lequel porte quoi ?
- Comment livrer une règle au moment de l'édition ?
- Où s'arrête la version faite maison ?
- À quoi ressemble la méthode complète ?
- Étape 1 : extraire les règles de votre propre code
- Étape 2 : faire valider chaque règle par un humain
- Étape 3 : livrer la bonne règle au moment de l'édition
- Étape 4 : vérifier le résultat en bout de chaîne
- Que change une règle qui arrive au moment de l'édition ?
- Par où commencer cette semaine ?
- Questions fréquentes
- Comment donner du contexte à Claude Code sur sa base de code ?
- Skills ou hooks dans Claude Code : quelle différence ?
- Quelle différence entre les rules et les skills de Claude Code ?
- Peut-on définir des rules dans Claude Code ?
- Les hooks de Claude Code servent-ils vraiment à quelque chose ?
- Mon hook PreToolUse s'exécute, mais Claude ignore sa sortie : pourquoi ?
- Le context engineering, c'est quoi pour un agent de code ?
- Claude Code peut-il générer le CLAUDE.md tout seul ?
- Claude Code lit-il le fichier AGENTS.md ?
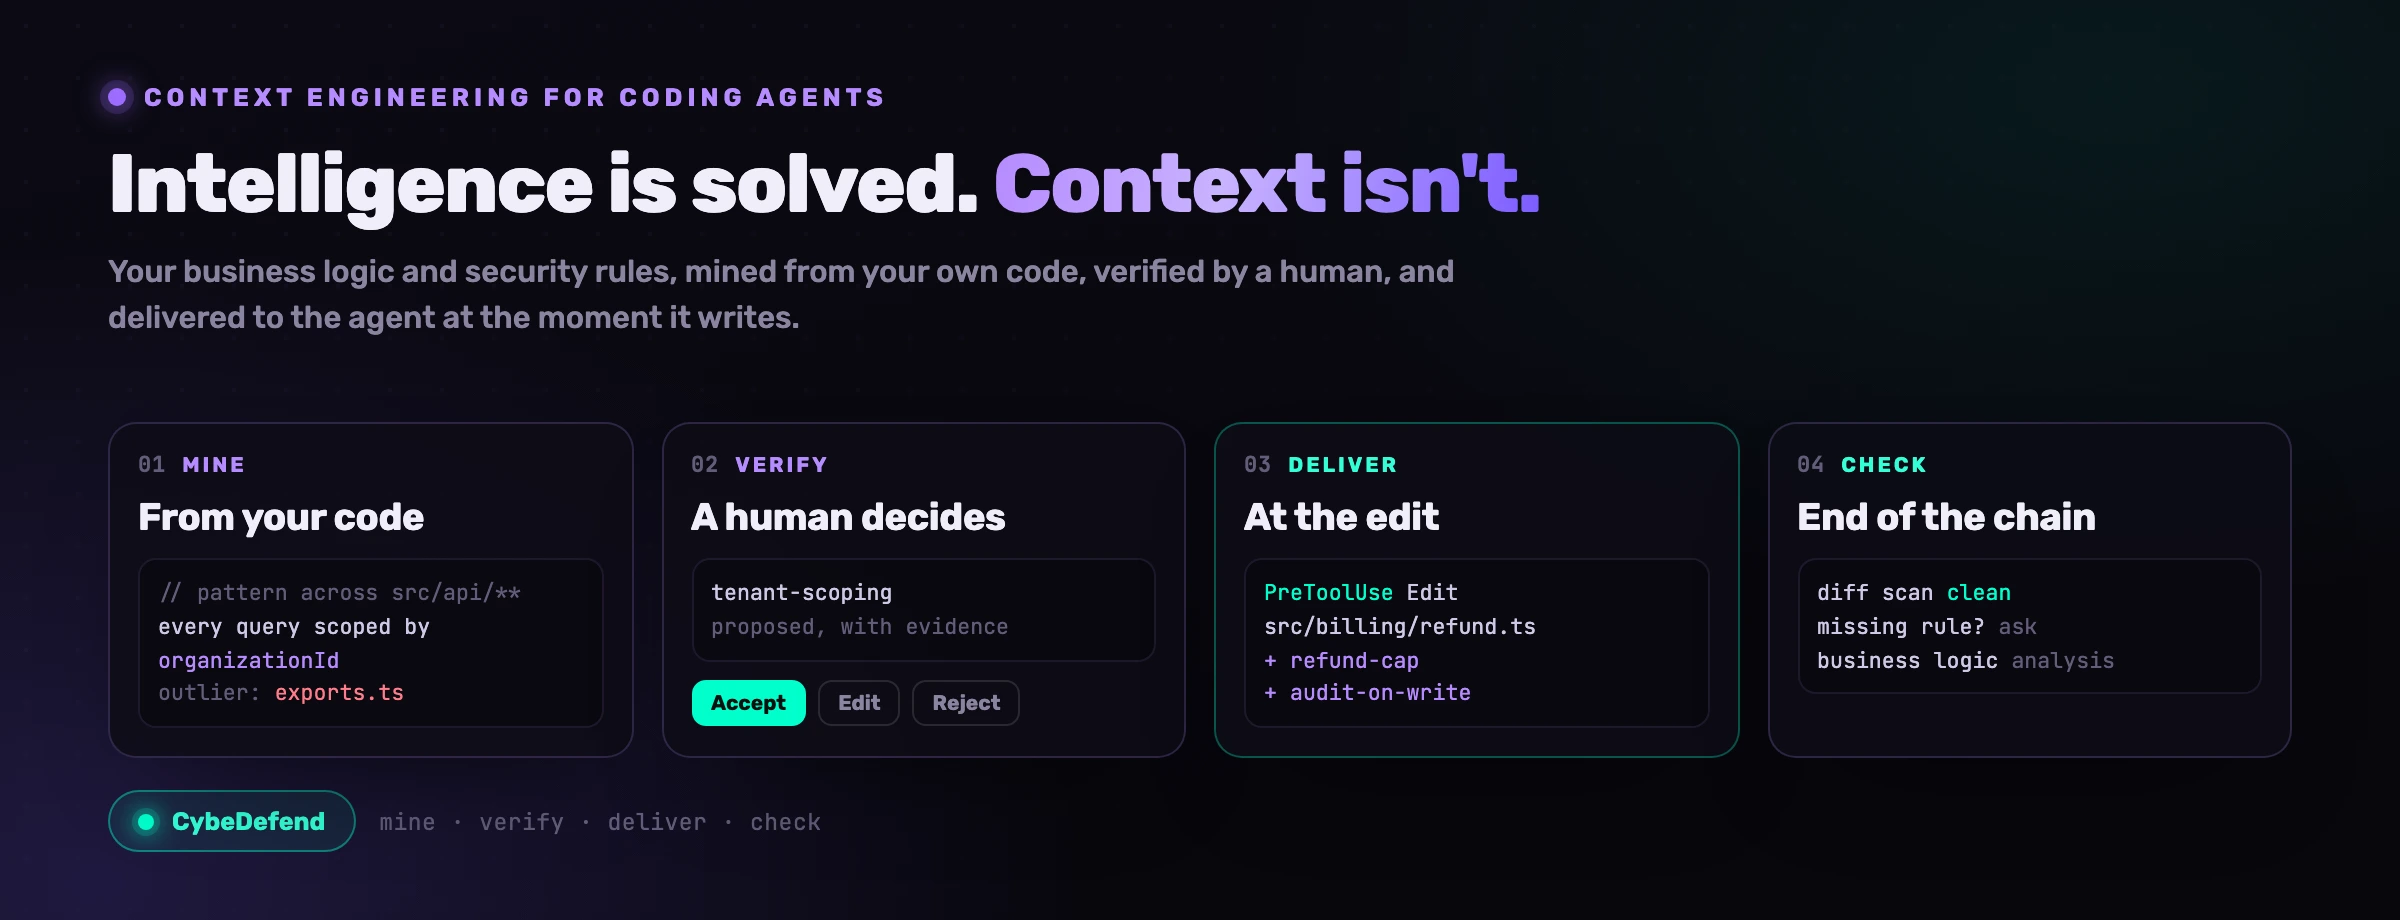
Écrire un endpoint de remboursement, Claude Code sait déjà le faire. Ce qu'il ne peut pas savoir, c'est que le vôtre répond 422 REFUND_EXCEEDS_CAPTURED, qu'il enregistre un événement d'audit avec l'identifiant de l'acteur et qu'il ne déborde jamais d'un tenant sur un autre. Tout cela, c'est du contexte : votre logique métier, votre nomenclature, vos règles de sécurité. Le goulot d'étranglement n'est plus l'intelligence du modèle. C'est l'acheminement de ce contexte jusqu'à lui, au moment précis où il écrit. Ce guide montre où ranger chaque type de contexte, vous donne un hook à copier dès aujourd'hui et détaille la méthode en quatre temps que CybeDefend applique à une base de code entière : extraire les règles de votre code, les faire valider par un humain, livrer la bonne au moment de l'édition, puis vérifier le résultat.
Que veut dire « contexte » pour un agent de code ?
C'est tout ce que le modèle doit savoir de votre système sans pouvoir le déduire du code qu'il a sous les yeux. Anthropic appelle cette discipline le context engineering. Birgitta Böckeler, qui écrit sur les agents de code sur le site de Martin Fowler, en cite la définition la plus courte qui circule : « Le context engineering consiste à trier ce que voit le modèle, pour obtenir un meilleur résultat. » Pour un agent qui travaille sur un vrai produit, ce contexte se répartit en trois couches.
Conventions
La façon dont le code s'écrit chez vous : les patterns du framework, l'organisation des dossiers, la commande de test. Le modèle en capte l'essentiel dans le code environnant, et un CLAUDE.md court couvre le reste.
Logique métier
Ce que votre logiciel doit faire et qu'aucun modèle ne peut deviner : un remboursement ne dépasse jamais le montant capturé, un manager valide au-delà d'un seuil, un statut de commande s'appelle SHIPPED et non DISPATCHED. C'est aussi là que vit votre nomenclature.
Règles de sécurité
Celles derrière lesquelles se tient un régulateur ou un client : quels champs sont des données personnelles, ce qui a le droit de figurer dans un log, quelle requête doit être cloisonnée au tenant, quelle action exige un événement d'audit.
Tous les guides consacrés à CLAUDE.md parlent de la première couche. Les deux autres sont celles où une erreur d'agent coûte de l'argent, et où aucun scanner ne regarde, puisqu'un remboursement qui crédite trop reste du code parfaitement valide. Cette classe de failles fait l'objet d'un article à part, les failles de logique métier dans le code généré par IA. Ici, l'enjeu est de la prévenir à la source, en s'assurant que l'agent connaît la règle au moment où il écrit.
Quelles sont les limites de CLAUDE.md, d'AGENTS.md et des skills ?
Chacun a été conçu pour un vrai besoin, et chacun y répond. Aucun n'a été conçu pour acheminer les règles métier d'une entreprise jusqu'au moment de l'édition. Voici où chacun s'arrête, dans les mots mêmes de son éditeur.
CLAUDE.md : lu une fois, suivi quand ça tombe bien
La documentation d'Anthropic ne s'en cache pas. Les fichiers CLAUDE.md sont « chargés au démarrage de chaque conversation », et « Claude les traite comme du contexte, pas comme une configuration appliquée ». La même page vous demande de viser « moins de 200 lignes par fichier CLAUDE.md », car « les fichiers plus longs consomment davantage de contexte et sont moins bien suivis ». Deux cents lignes, donc, pour vos commandes de build, vos conventions et toutes vos règles métier. Elle prévient aussi que « si deux règles se contredisent, Claude peut en choisir une arbitrairement », et rien ne confronte le fichier au code qu'il décrit.
Les utilisateurs en constatent le résultat dans le gestionnaire d'issues. L'issue #2901, ouverte en juillet 2025 et forte de 31 commentaires, le résume ainsi : « Claude Code enfreint fréquemment les instructions explicites de projet et d'utilisateur définies dans les fichiers CLAUDE.md ». L'issue #33603, toujours ouverte, s'intitule « Règles strictes du CLAUDE.md et instructions de mémoire persistante systématiquement ignorées ».
AGENTS.md : le même fichier, partagé par davantage d'agents
AGENTS.md est le format ouvert que lisent Codex, Cursor, Copilot et d'autres, adopté par plus de 60 000 projets open source. Son propre site en résume la nature : « AGENTS.md, c'est simplement du Markdown standard », « un README pour les agents ». Le standard fixe l'emplacement du fichier. Il ne dit rien de la question de savoir s'il est suivi.
Le seul test rigoureux mené à ce jour n'a rien de flatteur. En février 2026, Thibaud Gloaguen, Martin Vechev et trois coauteurs ont publié Evaluating AGENTS.md : les fichiers de contexte « n'améliorent généralement pas le taux de réussite des tâches, tout en augmentant le coût d'inférence de plus de 20 % en moyenne ». Les instructions qu'ils contenaient étaient pourtant « bien suivies », et les auteurs réservent ces fichiers à la « spécification de pratiques de code non standard », les présentations générales du dépôt n'étant « d'aucune aide ».
S'y ajoutent trois limites pratiques :
- Claude Code l'ignore dès qu'il existe un CLAUDE.md. Quand les deux fichiers sont présents dans le dépôt, Claude Code lit par défaut « uniquement vos fichiers CLAUDE.md ». Une équipe qui entretient les deux voit son AGENTS.md ignoré par Claude Code, alors que ses autres agents le lisent.
- Codex le plafonne. Par défaut, Codex cesse d'ajouter des fichiers d'instructions dès que leur taille cumulée atteint 32 KiB.
- Copilot le veut court. Le prompt que GitHub propose pour rédiger vos instructions exige qu'elles « ne dépassent pas 2 pages » et qu'elles « ne soient pas propres à une tâche ». Or une règle métier est, par nature, propre à une tâche.
Skills : chargés quand l'agent y pense
Un skill est un dossier d'instructions et de scripts qui ne se charge qu'au moment où l'on s'en sert. La documentation d'Anthropic sur les skills explique comment Claude fait son choix : il lit la description du skill pour « décider quand appliquer le skill ». Une règle empaquetée dans un skill ne s'applique donc que si l'agent reconnaît le bon moment.
Cette même documentation énumère les cas où la reconnaissance échoue. La description est « tronquée à 1 536 caractères ». Quand beaucoup de skills sont installés, Claude Code « écarte certaines descriptions pour respecter le budget de caractères de la liste, ce qui supprime les mots-clés dont Claude a besoin pour rapprocher votre demande du bon skill ». Et une fois une longue session compactée, « les skills plus anciens peuvent disparaître complètement ».
Pour les procédures, les skills sont excellents. Comme véhicule de règles qui doivent tenir à chaque fois, ils dépendent justement de ce dont vous cherchez à ne plus dépendre. Enfin, un skill écrit par quelqu'un d'autre exécute du code dans votre session, ce qui est un risque à part entière : voir les skills Claude Code sont-ils sûrs ?.
Ce qu'aucun d'eux ne fait
Tous trois supposent que le plus dur est déjà fait. Aucun d'eux :
- ne trouve vos règles. Chacun ne contient que ce que quelqu'un a pensé à mettre par écrit.
- ne sait quelle règle s'applique à cette édition. Ils se chargent par session, par chemin ou par description, jamais en fonction de ce que fait réellement le code en cours d'écriture.
- ne remarque qu'une règle a cessé de correspondre au code. Une valeur périmée reste dans le fichier jusqu'à ce que quelqu'un tombe dessus par hasard.
- ne vérifie le résultat. Savoir si la règle a été respectée, c'est l'affaire de la revue de code.
- ne fonctionne de la même façon d'un agent à l'autre. Une équipe qui travaille avec cinq agents entretient cinq dialectes.
Pourquoi l'agent perd-il la règle avant d'écrire ?
Parce que l'attention d'un modèle n'est pas uniforme, et qu'une règle lue au démarrage se trouve loin de l'édition au moment où elle compte. L'équipe d'ingénierie d'Anthropic le dit sans détour : le contexte « doit être traité comme une ressource finie, aux rendements marginaux décroissants ». Elle donne même un nom à l'effet, le context rot : « à mesure que le nombre de tokens dans la fenêtre de contexte augmente, la capacité du modèle à retrouver avec précision une information de ce contexte diminue ».
Des travaux indépendants l'ont mesuré. Dans son rapport Context Rot, Chroma a testé 18 modèles et constaté que « les performances des modèles se dégradent à mesure que la longueur de l'entrée augmente, souvent de manière surprenante et non uniforme ». Plus ancienne, l'étude Lost in the Middle montrait déjà que les performances « se dégradent nettement lorsque les modèles doivent accéder à une information pertinente située au milieu d'un long contexte ». Quant à IFScale, qui empile les instructions les unes sur les autres, il établit qu'à 500 instructions simultanées, « même les meilleurs modèles de pointe n'atteignent que 68 % de précision ».
La sécurité ne bénéficie d'aucun traitement de faveur. Dans le benchmark SusVibes, 57 % des solutions produites par SWE-Agent avec Claude Sonnet 4 étaient fonctionnellement correctes, mais seulement 11,8 % étaient sûres, et « enrichir la demande de fonctionnalité d'indices sur les vulnérabilités » n'y a rien changé. Demander à un agent d'être prudent, ce n'est pas lui donner vos règles.
Notre propre mesure s'est attaquée au cas le plus difficile, celui des règles pour lesquelles l'agent a déjà sa propre réponse plausible. Avec une section de règles réaliste dans CLAUDE.md, il a reproduit exactement 7 détails de règles sur 55, soit précisément le score obtenu sans aucun fichier. Le protocole complet se trouve dans Claude Code respecte-t-il votre CLAUDE.md ?. Deux forces l'expliquent. La dilution, d'abord : à la trentième édition, le fichier n'est plus qu'un vieux fragment enfoui sous des dizaines de milliers de tokens de code et de sorties de commandes. L'habitude, ensuite : le code que l'agent a sous les yeux lui montre comment on fait ici, et ce code compile.
Voici ce que cela donne sur un seul prompt. Le 27 septembre 2026, nous avons demandé à Claude Code (modèle Haiku) d'écrire une fonction de remboursement dans un dépôt vide : une fois sans aucune règle, une fois avec le hook présenté plus bas, chargé de notre règle de remboursement. Un seul run de chaque côté, ce qui en fait une illustration et non une mesure.
Les lignes que la règle a changées, dans le second run :
if (amountCents > availableForRefund) {
  throw new RefundError("REFUND_EXCEEDS_CAPTURED");
}
order.refundedCents += amountCents;
await audit.log("refund.created", {
  orderId: order.id, amountCents, actorId,
});
Les deux versions sont du code raisonnable. Une seule est votre code à vous. Cet écart, le bon comportement avec les mauvais détails, c'est justement celui qui échappe au relecteur et sur lequel un client d'API se casse les dents.
CLAUDE.md, rules, skills, MCP ou hooks : lequel porte quoi ?
Chaque mécanisme atteint le modèle à un moment différent, et c'est ce moment qui détermine à quoi il sert.
| Mécanisme | Quand il atteint le modèle | Bon pour | Faible pour |
|---|---|---|---|
| CLAUDE.md ou AGENTS.md | Une fois, au démarrage de la session | Commandes de build, organisation du projet, conventions, pratiques non standard | Une valeur précise dont l'agent a besoin trente éditions plus tard |
.claude/rules/ avec paths | Quand Claude lit un fichier qui correspond au motif | Les règles liées à un répertoire ou à un type de fichier | Les règles déclenchées par ce que fait le code, et non par l'endroit où il se trouve |
| Skills | Quand Claude estime qu'un skill correspond à la tâche | Les procédures et playbooks que vous colleriez sinon à la main | Les règles qui doivent s'appliquer, que l'agent y pense ou non |
| Outils MCP | Quand l'agent décide de les appeler | Gros corpus, recherche, données en temps réel | Tout ce qui suppose que l'agent pense à demander |
| Hooks | Sur un événement, à chaque fois : démarrage de session, prompt, avant ou après un outil | La bonne règle au moment de l'édition ; le blocage d'une commande | Rien, si ce n'est que la logique de correspondance est à écrire vous-même |
Tout se joue dans la deuxième colonne. Un fichier, un skill ou un outil MCP dépendent tous de quelque chose qui s'est produit plus tôt, ou du bon vouloir du modèle d'aller chercher l'information. Un hook, lui, est exécuté par le harness, que le modèle y pense ou non. Les rules bornées par chemin se situent entre les deux. D'après la documentation d'Anthropic, elles « se déclenchent quand Claude lit des fichiers correspondant au motif, et non à chaque utilisation d'un outil ». C'est un vrai progrès par rapport à un gros fichier unique, mais le déclencheur reste un chemin, pas l'opération. Quant à la sécurité des skills, qui exécutent du code venu du dépôt de quelqu'un d'autre, elle est traitée dans les skills Claude Code sont-ils sûrs ?.
Comment livrer une règle au moment de l'édition ?
Avec un hook PreToolUse branché sur les outils d'écriture : il retrouve les règles qui concernent le fichier en cours d'écriture et les renvoie dans additionalContext. Il faut trois fichiers. Commencez par déclarer le hook dans .claude/settings.json :
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          { "type": "command", "command": "node \"$CLAUDE_PROJECT_DIR/.claude/hooks/rules-at-edit.mjs\"" }
        ]
      }
    ]
  }
}
Rédigez ensuite chaque règle dans un petit fichier du dossier .claude/edit-rules/, avec en première ligne les chemins auxquels elle s'applique :
applies-to: src/billing/**, src/api/refunds/**
Refunds: never refund more than the captured amount.
Answer 422 with the code REFUND_EXCEEDS_CAPTURED, never a prose message.
Every refund writes an audit event: audit.log("refund.created", { orderId, amountCents, actorId }).
Reste le hook lui-même, .claude/hooks/rules-at-edit.mjs, qui demande Node 22.5 ou une version ultérieure pour disposer de path.matchesGlob :
import { readFileSync, readdirSync } from "node:fs";
import path from "node:path";

const root = process.env.CLAUDE_PROJECT_DIR ?? process.cwd();
const input = JSON.parse(readFileSync(0, "utf8"));
const file = path.relative(root, input.tool_input?.file_path ?? "");
const dir = path.join(root, ".claude/edit-rules");

const rules = readdirSync(dir)
  .map((name) => readFileSync(path.join(dir, name), "utf8"))
  .filter((text) => {
    const globs = text.match(/^applies-to:\s*(.+)$/m)?.[1] ?? "";
    return globs.split(",").some((g) => path.matchesGlob(file, g.trim()));
  });

if (rules.length > 0) {
  // JSON, not plain text: on PreToolUse, Claude Code only reads additionalContext.
  process.stdout.write(JSON.stringify({
    hookSpecificOutput: {
      hookEventName: "PreToolUse",
      additionalContext: `Rules for ${file}:\n\n${rules.join("\n---\n")}`,
    },
  }));
}
C'est ce montage qui a produit la colonne de droite de la comparaison ci-dessus. Claude Code place le contexte fourni par un hook « à côté du résultat de l'outil » : l'agent découvre donc la règle en même temps que le résultat de son écriture dans ce fichier, et corrige aussitôt. Dans notre run, il a écrit la fonction, lu la règle, puis annoncé « Fonction mise à jour pour » avant d'énumérer le code d'erreur et l'événement d'audit.
Les autres agents ont chacun leur dialecte. Codex, chez OpenAI, documente la même forme sur PreToolUse : « pour ajouter du contexte visible par le modèle sans bloquer, renvoyez hookSpecificOutput.additionalContext ». Chez Cursor, preToolUse peut autoriser, refuser ou réécrire un appel, et c'est le hook postToolUse qui ajoute un additional_context, « après le résultat de l'outil ». Enfin, les instructions de dépôt de GitHub Copilot ciblent les fichiers au moyen d'un motif applyTo, et c'est l'AGENTS.md le plus proche dans l'arborescence qui l'emporte.
Où s'arrête la version faite maison ?
Aux règles elles-mêmes. Le hook résout la question du moment, et il vaut la peine de l'installer dès aujourd'hui. Mais le reste de la liste ci-dessus tient toujours : les règles sortent encore de la mémoire de quelqu'un et continuent de se périmer, rien ne vérifie qu'elles ont été respectées, et chaque agent de l'équipe réclame sa propre version. Le hook ajoute même une limite qui lui est propre, car un chemin n'est pas une intention : un remboursement peut très bien s'écrire dans utils.ts, et aucun glob ne sait distinguer un remboursement d'une fonction de formatage. Au-delà de dix règles et d'un agent, entretenir tout cela à la main devient un travail à part entière.
À quoi ressemble la méthode complète ?
Elle part de là où tous les fichiers s'arrêtent : d'une page blanche, sans aucune règle écrite. C'est la méthode que CybeDefend applique avec VibeDefend, de la base de code jusqu'au diff, et elle est pensée pour une équipe de développement plutôt que pour le portable d'un seul développeur. Les règles vivent à un seul endroit par projet, l'agent de chaque développeur reçoit le même ensemble validé, et chaque étape existe parce que l'une des limites ci-dessus existe.
Étape 1 : extraire les règles de votre propre code
Vos règles figurent déjà dans votre code, écrites sous forme de répétitions. Une fois un dépôt connecté et analysé, un extracteur parcourt son graphe de code en quête de cinq types de régularités :
- Les motifs de présence, un champ ou un appel que portent presque toutes les instances. Chaque entité a un
organizationId, chaque écriture dansordersappelle le logger d'audit. - Les ensembles de valeurs, c'est-à-dire les noms littéraux que votre code donne aux statuts, aux rôles et aux codes d'erreur. C'est votre nomenclature, et un agent qui invente un sixième statut de commande casse tous les consommateurs des cinq autres.
- Les co-occurrences : gardes et décorateurs qui vont toujours ensemble, comme un contrôle d'authentification et un rate limit.
- Les appels obligatoires avant une opération sensible : contrôles de permission, cloisonnement par tenant, rate limits, feature flags.
- Les conventions nommées par un modèle à partir de groupes de code similaire, accompagnées de la liste des écarts.
Chaque proposition arrive avec ses preuves (où le motif a été trouvé, et combien de fois) et un indice de confiance. Ce sont les écarts qui ont le plus de valeur. Un endpoint sans cloisonnement par tenant, dans une base de code où quarante autres l'appliquent, c'est soit une exception voulue, soit une faille que personne n'a remarquée. C'est exactement le point où logique métier et sécurité se rejoignent.
Étape 2 : faire valider chaque règle par un humain
L'extraction propose, elle ne décide jamais. Un motif peut n'être qu'une habitude, et une règle relève de la politique : celui qui l'écrit oriente tous les agents de l'équipe, et c'est bien pour cela que les fichiers d'instructions sont une surface d'attaque à part entière. Dans VibeDefend, chaque proposition est acceptée, modifiée ou rejetée depuis le dashboard, ou directement dans l'agent à l'ouverture d'une session. Une règle suggérée par l'agent lui-même est refusée tant que vous ne l'avez pas confirmée. Chaque semaine, un contrôle de dérive propose une mise à jour dès que le code s'éloigne d'une règle acceptée. C'est ainsi que les règles restent justes sans que personne ait un fichier à entretenir.
Étape 3 : livrer la bonne règle au moment de l'édition
On retrouve le hook de la section précédente, à ceci près que la sélection passe par une recherche (retrieval) et non plus par des globs. Avant chaque écriture, le chemin du fichier et le début du code en cours d'écriture sont envoyés comme intention. En retour, jusqu'à cinq règles métier et cinq règles de sécurité pertinentes pour cette modification arrivent en contexte pour ce fichier. L'installeur câble le tout pour Claude Code, Cursor, Codex, Windsurf et GitHub Copilot sous VS Code, chacun avec les limites de son propre système de hooks.
La livraison informe l'agent, elle ne le contraint pas. Pour ce qui ne doit jamais arriver, une garde distincte examine chaque commande avant son exécution et peut la bloquer. La règle placée dans le contexte est une suggestion appuyée ; la garde posée sur l'action est le contrôle. Nous préférons dire clairement lequel des deux joue quel rôle.
Étape 4 : vérifier le résultat en bout de chaîne
Trois vérifications, de la session jusqu'à l'architecture :
- À la fin d'une session, une revue pose une seule question : ce travail a-t-il fait apparaître une règle durable, écrite nulle part ? Elle en propose une au maximum, souvent aucune, et rien n'est enregistré sans votre accord.
- Avant le commit, le diff est passé au crible à la recherche de vulnérabilités, d'erreurs de configuration d'infrastructure et de secrets, pour que l'agent les corrige dans la même session.
- Sur la logique métier elle-même, BLSA (Business Logic Security Analysis), notre analyse de sécurité de la logique métier, lit l'architecture entière segment par segment pour trouver ce qu'aucun motif ne révèle : un remboursement rejouable, un tenant capable de lire les données d'un autre, des données personnelles qui fuient par un export, une opération qui n'est pas idempotente. BLSA est un axe de recherche mené avec le CNRS et le laboratoire CRIStAL, déjà en service chez des design partners mais pas encore ouvert à tous. Voir ce qu'il cherche dans la fintech.
Mises côte à côte, les deux approches diffèrent moins par l'agent que par l'équipe qui l'entoure.
Que change une règle qui arrive au moment de l'édition ?
La plupart des règles cessent de se perdre en route. Notre étude contrôlée a fait passer 30 tickets de développeur dans trois agents autonomes, sur une seule base de code et avec un seul modèle. Sur les 19 tâches de sa première phase, l'agent sans aucune règle et l'agent doté d'un fichier de règles réaliste ont chacun reproduit à l'identique 7 détails de règles sur 55. L'agent qui recevait les règles au moment de l'édition en a reproduit 46 sur 53.
de valeurs exactes sans aucune règle (7 sur 55)
de valeurs exactes avec une section de règles réaliste dans CLAUDE.md (7 sur 55)
de valeurs exactes avec la règle livrée au moment de l'édition (46 sur 53)
Ce que ces chiffres mesurent, et ce qu'ils ne mesurent pas. Ils mesurent la livraison au moment de l'édition. Les 49 règles ont été écrites par nous et non extraites : l'étude ne dit donc encore rien de la qualité de l'extraction. Il s'agit d'une seule base de code, avec un run par bras et par tâche, noté en aveugle par des auditeurs qui sont des modèles.
L'étude contient même son propre contre-exemple : sur une tâche, une règle a été livrée treize fois et l'agent l'a tout de même enfreinte, raison pour laquelle la garde existe. Le protocole et l'ensemble des chiffres figurent dans l'étude.
Par où commencer cette semaine ?
Par dix règles, pas par une plateforme.
- Listez dix règles que votre équipe répète en revue de code, ces commentaires que vous avez tapés plus de deux fois.
- Triez-les avec une seule question : un ingénieur compétent, fraîchement arrivé dans l'équipe, pourrait-il la deviner ? Si oui, elle a sa place dans CLAUDE.md. Sinon, elle doit parvenir à l'agent au moment de l'édition.
- Bornez ce qui dépend d'un répertoire avec
.claude/rules/et un champpaths. - Ajoutez le hook ci-dessus pour les règles arbitraires, et vérifiez qu'il renvoie bien du JSON.
- Transformez tout ce qui ne doit jamais arriver en règle de refus ou en garde, pas en phrase.
- Testez là où ça casse : une fonctionnalité qui touche à une règle, trente tours après le début d'une session.
Le jour où la liste ne tient plus dans votre tête, c'est le moment de l'extraire plutôt que de l'écrire.
Questions fréquentes
Comment donner du contexte à Claude Code sur sa base de code ?
En trois couches. Les commandes de build, l'organisation du projet et les conventions vont dans un CLAUDE.md court, que Claude lit au démarrage de chaque session. Les règles propres à un répertoire vont dans .claude/rules/ avec un champ paths, pour qu'elles se chargent quand Claude lit un fichier correspondant. Quant aux règles métier et de sécurité que le modèle ne peut pas deviner (codes d'erreur, seuils, formats d'audit), elles doivent arriver au moment de l'édition, par un hook PreToolUse qui renvoie du JSON avec additionalContext.
Skills ou hooks dans Claude Code : quelle différence ?
Un skill, c'est Claude qui choisit de le charger ; un hook, c'est Claude Code qui l'exécute, que Claude le choisisse ou non. La description d'un skill reste en contexte et son corps se charge quand Claude, ou vous, l'invoquez, ce qui en fait le bon outil pour les procédures. Un hook se déclenche sur un événement, qu'il s'agisse d'un démarrage de session, d'un prompt ou d'un appel d'outil : c'est donc le bon endroit pour une règle qui doit atteindre l'agent à chaque fois, ou pour bloquer une commande.
Quelle différence entre les rules et les skills de Claude Code ?
Les rules sont des consignes, les skills des procédures. Les fichiers de .claude/rules/ se chargent en contexte sans condition, ou quand Claude lit un fichier qui correspond à leur motif paths. Un skill emballe une procédure en plusieurs étapes, éventuellement accompagnée de scripts, et ne se charge qu'au moment où l'on s'en sert. Aux rules ce qui doit toujours être vrai du code, aux skills la façon de mener une tâche.
Peut-on définir des rules dans Claude Code ?
Oui. Les fichiers Markdown placés dans .claude/rules/ sont chargés comme des instructions, de façon récursive, à raison d'un sujet par fichier. Une rule dont le frontmatter comporte un champ paths ne se charge que lorsque Claude lit un fichier correspondant à l'un de ses motifs glob ; sans ce champ, elle se charge à chaque session. Les rules personnelles, rangées dans ~/.claude/rules/, s'appliquent à tous les projets de votre machine.
Les hooks de Claude Code servent-ils vraiment à quelque chose ?
Pour tout ce qui doit se produire à chaque fois, les hooks sont le seul mécanisme fiable. La documentation d'Anthropic elle-même indique que, pour bloquer une action « quoi que Claude décide », il faut passer par un hook PreToolUse plutôt que par une instruction. Les hooks savent aussi ajouter du contexte à un moment précis, par exemple les règles du fichier en cours d'écriture, ce dont un fichier lu au démarrage de la session est incapable.
Mon hook PreToolUse s'exécute, mais Claude ignore sa sortie : pourquoi ?
Parce que le texte brut qu'affiche un hook PreToolUse part dans le log de débogage, pas vers le modèle. Claude Code n'ajoute au contexte la sortie stdout en texte brut que pour UserPromptSubmit, UserPromptExpansion, SessionStart et PostModelSwitch. Renvoyez plutôt du JSON, avec hookSpecificOutput.hookEventName égal à PreToolUse et votre texte dans additionalContext. Nous avons vérifié la différence sur Claude Code 2.1.282, le 27 septembre 2026.
Le context engineering, c'est quoi pour un agent de code ?
C'est l'art de décider quelles informations entrent dans la fenêtre de contexte du modèle, et à quel moment, pour qu'il mène la tâche correctement. Pour un agent de code, il s'agit moins d'écrire un prompt plus long que de bien choisir le moment : les faits stables au démarrage de la session, les règles pertinentes au moment de l'édition, et rien d'autre qui vienne lui disputer son attention. L'équipe d'ingénierie d'Anthropic emploie le terme pour désigner la discipline dans son ensemble.
Claude Code peut-il générer le CLAUDE.md tout seul ?
Oui, /init analyse votre base de code et rédige un premier CLAUDE.md avec les commandes de build, les instructions de test et les conventions qu'il repère. C'est un bon point de départ pour la première couche de contexte. Mais ce n'est pas la même chose qu'extraire des règles métier. L'étude Evaluating AGENTS.md a constaté que les fichiers de contexte générés par un modèle n'amélioraient généralement pas la réussite des tâches. Et un fichier généré reste un fichier : il n'arrive qu'une fois, au démarrage de la session, et quelqu'un doit encore le vérifier.
Claude Code lit-il le fichier AGENTS.md ?
Oui, à condition qu'il n'y ait pas de CLAUDE.md. D'après la documentation d'Anthropic, Claude Code lit AGENTS.md comme instructions de projet si aucun CLAUDE.md ni CLAUDE.local.md ne se trouve dans le répertoire de travail ou au-dessus. Quand les deux fichiers sont présents, il ne lit par défaut que vos fichiers CLAUDE.md, sauf si votre CLAUDE.md importe AGENTS.md ou si vous modifiez le réglage. Dans un cas comme dans l'autre, c'est le même mécanisme, un fichier chargé au démarrage de la session, avec les mêmes limites pour les règles dont l'agent a besoin trente éditions plus tard.


