

Sur cette page
- Claude Code respecte-t-il le CLAUDE.md ?
- Que dit déjà la recherche publiée ?
- Qu'avons-nous mesuré que les grandes études ne mesurent pas ?
- Que se passe-t-il quand la règle est dans le fichier, avec la bonne valeur ?
- Les règles n'étaient-elles pas indevinables par construction ?
- Pourquoi deux agents configurés différemment commettent-ils la même erreur ?
- Un CLAUDE.md parfait règle-t-il le problème ?
- Que disent les éditeurs de sécurité des fichiers de règles ?
- Que faut-il changer, et que ne vaut-il pas la peine de changer ?
- Quel crédit accorder à ces chiffres ?
- Ce que nous vendons, dit simplement
- Questions fréquentes
- Comment écrire un bon CLAUDE.md ?
- Que mettre dans un CLAUDE.md, concrètement ?
- Quelle longueur doit faire un CLAUDE.md ?
- Faut-il des règles CLAUDE.md par framework, React ou Next.js ?
- Faut-il committer le CLAUDE.md dans le dépôt ?
- Pourquoi Claude Code ne suit-il pas mes règles ?
- Claude Code lit-il AGENTS.md ou seulement CLAUDE.md ?
- Le CLAUDE.md sert-il vraiment à quelque chose ?
- Karpathy a-t-il vraiment mesuré des erreurs qui tombent de 40 % à 11 % avec un CLAUDE.md ?
- Comment imposer vraiment une règle dans Claude Code ?
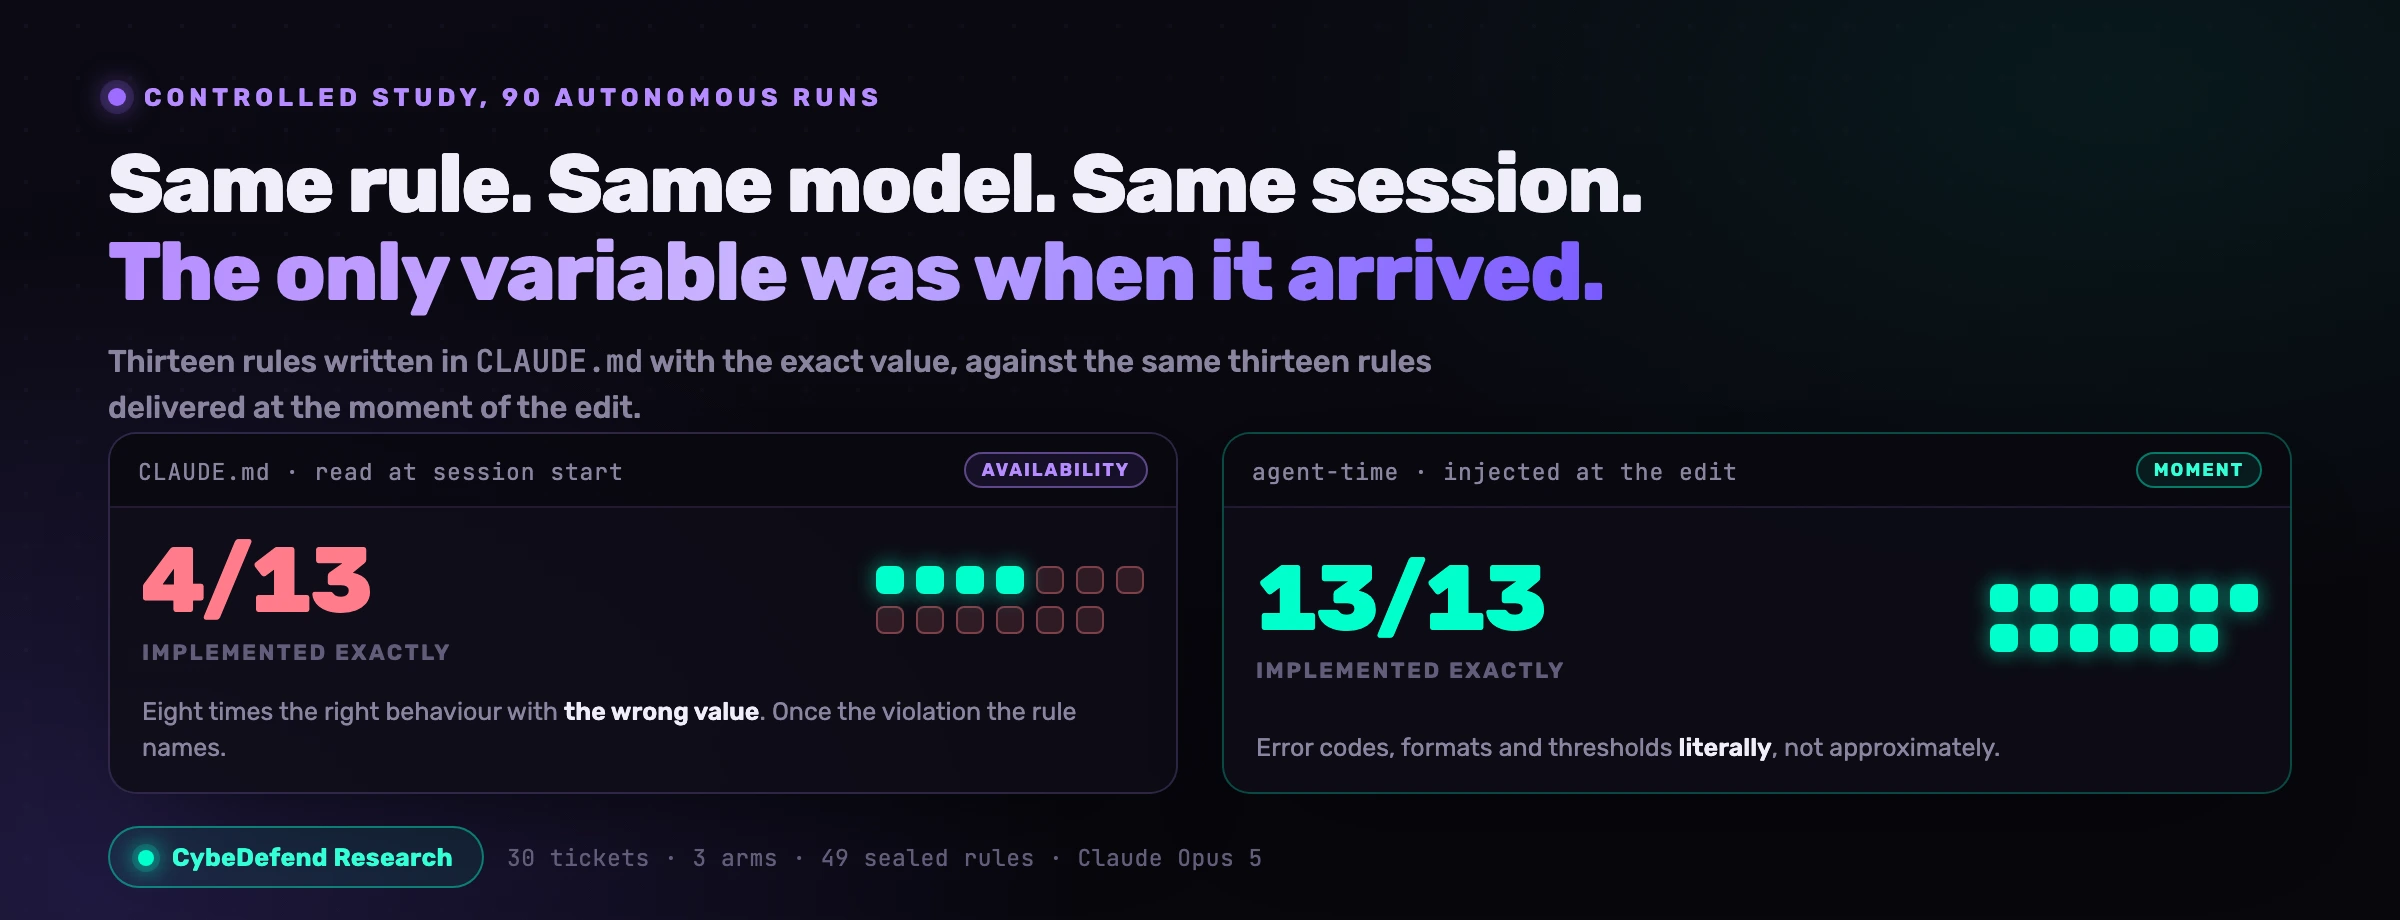
Claude Code suit votre CLAUDE.md exactement là où vous n'en aviez pas besoin, et il le lâche sur les règles qui vous ont fait écrire le fichier. Nous avons passé 30 tickets de développeur dans trois agents autonomes, sur la même base de code et avec le même modèle, soit 90 runs, en ne faisant varier qu'une chose : le canal par lequel l'agent pouvait connaître les 49 règles métier et de conformité de la plateforme. Le bras qui disposait d'une section de règles réaliste, écrite à la main dans CLAUDE.md, a repris la valeur exacte de 7 règles sur 55. Le bras qui n'avait rien du tout : 7 sur 55. Le même score.
Claude Code respecte-t-il le CLAUDE.md ?
En partie, et la partie qu'il laisse tomber est justement celle qui vous intéresse. Anthropic ne s'en cache pas dans sa propre documentation. La page consacrée à la mémoire écrit que les fichiers CLAUDE.md sont « chargés au démarrage de chaque conversation » et que « Claude les traite comme du contexte, pas comme une configuration appliquée ».
La page de dépannage va plus loin : « Claude le lit et essaie de le suivre, mais il n'existe aucune garantie de conformité stricte, en particulier pour les instructions vagues ou contradictoires. »
Ce qu'Anthropic ne publie pas, au 13 septembre 2026, c'est un chiffre. Aucun taux de conformité mesuré nulle part dans la documentation. De bonne guerre pour un éditeur, sans aucune utilité pour l'équipe qui doit trancher une question simple : ce fichier, c'est un contrôle ou une suggestion ?
La question, elle, n'est pas retombée. Cherchez dans les issues du dépôt anthropics/claude-code les titres qui contiennent à la fois CLAUDE.md et une forme du verbe ignorer : 199 résultats, dont 9 encore ouvertes au 13 septembre 2026. Toutes ne parlent pas de respect des règles, mais un titre revient et il ne laisse aucun doute, CLAUDE.md Mandatory Rules Consistently Ignored Across Multiple Repositories, ouverte depuis juin 2025 et 45 réactions plus tard. Le titre parle de plusieurs dépôts, et c'est ce pluriel qui trahit. Personne ne signale un bug, tout le monde signale une propriété.
Que dit déjà la recherche publiée ?
Que les réglages sur lesquels tout le monde s'acharne, la taille du fichier, la place de la règle dans le document, le découpage en plusieurs fichiers, n'ont aucun effet mesurable, et que la conformité s'érode à mesure que la session avance. Ce résultat n'est pas le nôtre, et nous tenons à le dire avant de présenter le nôtre.
En mai 2026, Damon McMillan publiait Instruction Adherence in Coding Agent Configuration Files: A Factorial Study of Four File-Structure Variables (arXiv 2605.10039, soumis le 11 mai 2026). C'est de loin le travail le plus solide sur la question : 1 650 sessions Claude Code CLI, 16 050 observations au niveau de la fonction, deux bases de code TypeScript, cinq tâches de développement, Sonnet 4.6 avec Opus 4.6 en contrôle inter-modèles. Quatre variables manipulées de façon factorielle, la taille du fichier, la position de l'instruction, l'architecture du fichier et les contradictions avec les fichiers voisins.
Le verdict, tel que l'article le formule : « Aucune des quatre variables structurelles, ni aucune des trois interactions d'ordre deux, ne produit de contraste détectable après correction pour tests multiples. » Sur la taille et sur les conflits, ces absences d'effet sont même appuyées par des facteurs de Bayes qui plaident activement pour le nul, BF10 entre 0,05 et 0,10, ce qui est plus fort qu'un simple échec à rejeter.
Une seule chose bouge, et elle n'a rien à voir avec la mise en forme : « chaque fonction supplémentaire générée par l'agent est associée à une baisse d'environ 5,6 % des chances de conformité par pas (OR = 0,944) », un effet que l'article décrit comme non monotone.
Ce second point est la charnière. Une annotation triviale, l'agent n'a aucune raison de l'écrire si le fichier ne la réclame pas : le fichier part de zéro, son travail consiste à faire passer la conformité de presque rien à quelque chose, et ce travail, il le fait. Nous avons voulu poser la question dans sa version commercialement inconfortable. Que se passe-t-il quand l'agent a déjà, d'instinct, une réponse plausible, et que la règle dit que cette réponse plausible est fausse ?
Qu'avons-nous mesuré que les grandes études ne mesurent pas ?
Le cas où l'agent a déjà une réponse. Notre étude contrôlée, publiée le 24 août 2026 a fait passer 30 tickets de développeur sur une base Express et SQLite de taille moyenne, en triplicat : trois agents autonomes, les mêmes tickets, le même modèle (Claude Opus 5, effort high), 90 runs et 93 analyses de sécurité indépendantes. Une seule variable manipulée, le canal par lequel l'agent pouvait connaître les 49 règles de la plateforme : rien, une section de règles dans le CLAUDE.md du dépôt, ou l'injection au moment de l'édition.
Ces règles couvrent onze familles, des remboursements à l'arithmétique du programme de fidélité, de la minimisation RGPD à l'obligation de prix de référence issue de la directive Omnibus, en passant par les plafonds d'espèces et les pistes d'audit. Chacune porte une valeur volontairement arbitraire : 422 REFUND_EXCEEDS_CAPTURED, un seuil de validation manager à 150,00 euros, erased-{id}@removed.invalid, ORD-{store}-{YYMMDD}-{seq}.
La section du bras fichier, elle, a été écrite comme les vraies équipes écrivent la leur : 41 lignes, la moitié du corpus environ, des règles paraphrasées, deux valeurs périmées, des familles entières oubliées. Ce qu'elle disait de chaque règle a été figé avant le premier run, le corpus aussi. Les tickets ont été rédigés comme des incidents, dans la langue d'un développeur, puis passés à la machine pour vérifier qu'aucun littéral n'y avait fuité. Trois auditeurs en aveugle ont noté chaque diff sans savoir de quel bras il venait.
règles reprises à la valeur exacte, avec une section de règles réaliste dans CLAUDE.md
règles reprises à la valeur exacte, sans aucun fichier de règles
règles reprises à la valeur exacte, avec la règle servie au moment de l'écriture
Sept sur 55 dans les deux bras de contrôle. Pas des scores proches : le même score. Sur les dix-neuf tâches de la phase 1, avoir un fichier de règles réaliste dans le dépôt n'a rien changé de mesurable au code produit. Une seule chose a bougé, et c'est la contribution démontrée du fichier : la forme des erreurs. Le bras sans rien a enfreint davantage, 18 contre 12, le bras fichier a plus souvent produit le bon comportement avec la mauvaise valeur, 28 contre 20. Un document paraphrasé fait passer les erreurs de « violée » à « presque ». Il ne les fait pas passer à « exacte ».
Que se passe-t-il quand la règle est dans le fichier, avec la bonne valeur ?
Elle est reprise telle quelle une fois sur trois, 31 % exactement. Comme la couverture du fichier avait été figée règle par règle avant les runs, nous pouvons redécouper la phase 1 selon ce que le fichier disait vraiment. Pour 13 règles, il portait la bonne valeur noir sur blanc, dans un document lu à chaque démarrage de session.
| Ce que le fichier disait de la règle | Règles notées | Reprises telles quelles | Juste, mais autre valeur | Enfreintes | Exactes si servie à l'écriture |
|---|---|---|---|---|---|
| Exacte, la bonne valeur, écrite noir sur blanc | 13 | 4 (31 %) | 8 | 1 | 13 (100 %) |
| Vague, la direction sans la valeur | 21 | 2 (10 %) | 13 | 2 | 15 (71 %) |
| Absente, jamais écrite | 20 | 1 (5 %) | 6 | 9 | 18 (90 %) |
Cette première ligne mérite une deuxième lecture. Ce n'est pas la disponibilité de l'information qui faisait la différence, c'est le moment où elle arrivait.
La tâche M06 est le cas d'école. Le ticket demande d'accepter une carte cadeau d'un montant inférieur au panier, le reste étant payé par carte bancaire. La règle dit qu'un point de fidélité est acquis par euro entier payé en argent et que la part carte cadeau n'en rapporte aucun. Le bras fichier avait cette règle, avec sa valeur. Il a réécrit la fonction de paiement, calculé la part éligible pour ordonner les moyens de paiement, et laissé intacte la ligne floor(total / 100) qui crédite les points sur le total. Dans son propre flux, tout neuf, les euros de carte cadeau rapportent de la fidélité.
Le travail d'un ingénieur soigneux qui n'a jamais vu le document de règles.
Il l'avait vu, pourtant, au démarrage de la session, dans un fichier chargé avant le premier tour. Le bras qui a reçu la même règle dans sa boucle, au moment précis où il éditait le fichier de paiement, a écrit earned = floor(remainderCents / 100) et deux tests dédiés.
Les règles n'étaient-elles pas indevinables par construction ?
Certaines le sont, oui, et c'est une objection à traiter plutôt qu'à enterrer. Le caractère devinable a été noté règle par règle et figé avant le premier run : 35 indevinables, 13 faiblement devinables, 1 devinable. Les valeurs arbitraires sont un choix de protocole, parce que c'est le seul moyen de distinguer un agent qui connaît une règle d'un agent qui en devine une raisonnable.
La tâche M21 fait exactement cette séparation. Les trois bras ont plafonné les paiements en espèces à 1 000 euros : c'est un fait juridique public, le modèle le connaît, personne n'a besoin de le lui dire. Seul le bras qui avait reçu la règle a répondu avec le code d'erreur propre à la plateforme, 422 CASH_LIMIT, testé au centime près sur la part espèces d'un paiement mixte. Les deux autres ont renvoyé un 422 accompagné d'un message en prose.
Pour un client d'API, ce n'est pas la même chose. D'un côté un cas géré, de l'autre un cas que devinera celui qui écrira l'intégration. Une entreprise ne paie pas pour ce que le modèle sait du monde, elle paie pour le contrat arbitraire qui fait tenir ses propres systèmes ensemble. Au lecteur qui trouverait notre corpus trop arbitraire, M21 renvoie la question : vos codes d'erreur et vos formats à vous, ils sont moins arbitraires ?
Pourquoi deux agents configurés différemment commettent-ils la même erreur ?
Parce que les erreurs d'agent ne sont pas variées, elles sont déterministes. C'est le résultat que nous n'avions pas anticipé, et celui qui a la plus grosse conséquence opérationnelle. Sur 16 des 30 tâches, les deux bras de contrôle, lancés séparément dans des arbres distincts, ont convergé vers la même implémentation fausse. Pas une implémentation voisine. La même.
- Le même SQL en écriture absolue au recomptage annuel,
quantity = excluded.quantity, là où la règle exige un mouvement typé dans un registre. - Le même design interdit pour les promotions qui se chevauchent, à savoir « le chevauchement est une fonctionnalité, la plus forte gagne » : l'instinct de l'ingénieur, et précisément ce que la règle de prix interdit.
- Le même plafond de 4 000 caractères sur les diagnostics conservés, et le même champ
ibanoublié dans la liste des champs à masquer.
Si vous partez du principe qu'une mauvaise sortie d'agent est un coup de dé, et que la revue finira par l'attraper à la deuxième ou à la troisième occurrence, abandonnez ce principe. L'entreprise qui ne met pas son contrat sous les yeux de l'agent n'obtient pas un éventail d'interprétations parmi lesquelles un relecteur pourra trancher. Elle obtient partout la même interprétation, raisonnable et fausse, défendue partout par les mêmes tests.
C'est la fin de la phrase qui compte. Après 30 tickets, les bras de contrôle laissaient derrière eux 57 et 52 règles non conformes, dont 21 et 12 violations franches : des données personnelles dans un export transporteur puis dans les logs, un prix barré illégal, des points de fidélité offerts sur les cartes cadeaux, du stock écrasé sans trace. Au moins un tiers de ces écarts étaient verrouillés par des tests au vert que les agents avaient écrits eux-mêmes. La dette n'est pas seulement silencieuse, elle est défendue par la CI. Nous la détaillons dans les failles de logique métier dans le code généré par IA.
Un CLAUDE.md parfait règle-t-il le problème ?
Il fait les deux tiers du chemin, et nous avons préféré le mesurer plutôt que le supposer. Après la tâche 22, l'écart soulevait une objection légitime : le bras fichier avait-il seulement eu sa chance ? Nous avons donc pré-enregistré un amendement et remplacé la section qui avait dérivé par les 49 règles du corpus au complet, verbatim, littéraux machine compris, présentées comme fraîchement synchronisées par l'ingénierie. Impossible d'imaginer une version plus forte du « mettez vos règles dans le dépôt ».
Ces 64 % sont une vraie amélioration et nous n'allons pas prétendre le contraire. C'est aussi le plafond, pour le même coût en tokens, et les quatre échecs sont instructifs. Le bras fichier a réussi sur les règles que le ticket désignait, et il a échoué sur deux autres catégories.
La première, les détails secondaires d'une règle qu'il avait par ailleurs bien traitée. Avec 403 ADJUSTMENT_LIMIT au-delà de plus ou moins 30 unités écrit verbatim dans son fichier, il a posé le seuil exact de 30 et répondu par un 403 en prose, sans le littéral. La dilution ne joue pas seulement à l'échelle d'un document, elle joue à l'intérieur d'une seule règle.
La seconde, les règles transverses que le ticket ne nomme pas. La règle interdisant l'écriture directe des quantités de stock figurait dans son fichier, verbatim, et elle a perdu trois fois sur trois contre l'habitude du code qu'il avait sous les yeux. Le code existant est une instruction implicite plus forte que n'importe quel document : il montre à l'agent comment on fait ici, il est sous ses yeux pendant qu'il écrit, et il compile. Une règle qui contredit une habitude de code ne gagne que si elle arrive en même temps que l'habitude.
Que disent les éditeurs de sécurité des fichiers de règles ?
Les deux choses, souvent dans le même produit, et presque jamais avec une mesure à l'appui.
Le plaidoyer optimiste est arrivé tôt et il est bien fait. En juin 2025, Rami McCarthy, chez Wiz, publiait Rules Files for Safer Vibe Coding et publiait en open source un jeu de règles de sécurité de base pour Cursor, Windsurf, Copilot, l'AGENTS.md de Codex et le CLAUDE.md de Claude. Sa thèse : « les fichiers de règles sont une méthode idéale pour centraliser et normaliser ces améliorations de prompt orientées sécurité ». L'article pose lui-même sa limite, « le meilleur fichier de règles de sécurité est celui qui est propre à votre organisation ». Sur la classe qu'il vise, la posture générique de codage sécurisé, nous n'avons rien à lui opposer.
Le plaidoyer sceptique, lui, porte moins sur le fait que le modèle suive le fichier que sur la question de savoir qui a le droit de l'éditer. Dans son guide de sécurisation des éditeurs de code IA, publié le 31 octobre 2025, Mahesh Babu, de Kodem, note que les protections de ces outils « sont fréquemment désactivées en pratique », ce qui laisse « un environnement où du code non fiable ou des fichiers de règles empoisonnés peuvent s'exécuter sans examen ». Vrai problème, mais problème différent. Une règle peut tomber parce que quelqu'un l'a désactivée ; elle peut aussi tomber parce que le modèle l'a diluée, le fichier restant parfaitement intact.
Reste un motif plus discret et plus parlant, celui des éditeurs qui livrent en même temps un fichier de règles et un produit d'injection de contexte. Sonar publie un AGENTS.md pour son workflow d'agent, avec la consigne de « déposer ce fichier à la racine de votre dépôt, comme fichier d'instructions de l'agent », et vend par ailleurs Vortex, qui « injecte le bon contexte projet et les bonnes contraintes pour que les agents démarrent au clair ». Endor Labs, de son côté, lit votre CLAUDE.md comme une déclaration d'intention destinée à son analyseur, et écrit le 7 septembre 2026 qu'« un CLAUDE.md qui annonce que toutes les routes d'API sont authentifiées par notre middleware SSO apprend à l'analyseur quelque chose qu'aucune reconnaissance de motif ne ferait remonter ».
Aucun d'eux n'a publié de taux de conformité, et Anthropic non plus, autant que nous puissions en juger. Le sujet reposait sur des affirmations et sur des fils GitHub. Il repose désormais sur une grande étude factorielle de la structure du fichier et sur une petite étude du cas difficile. C'est encore maigre. C'est moins maigre qu'avant.
Que faut-il changer, et que ne vaut-il pas la peine de changer ?
Commencez par ce que les données écartent, parce que c'est là que passe l'essentiel de l'énergie des équipes. McMillan a testé, de façon factorielle et à l'échelle, les quatre conseils que donne n'importe quel guide d'écriture d'un bon CLAUDE.md.
| Le conseil courant | Ce que l'étude factorielle a trouvé |
|---|---|
| Raccourcir le fichier | Aucun effet détectable de la taille, avec un facteur de Bayes en faveur du nul |
| Mettre la règle importante en haut | Aucun effet détectable de la position de l'instruction |
| Le découper en plusieurs fichiers, ou utiliser des imports | Aucun effet détectable de l'architecture du fichier |
| Supprimer les contradictions avec les fichiers voisins | Aucun effet détectable des conflits, avec un facteur de Bayes en faveur du nul |
Deux nuances. La documentation d'Anthropic recommande effectivement de viser « moins de 200 lignes par fichier CLAUDE.md », au nom du budget de contexte, et dégraisser un fichier obèse reste une bonne hygiène. Mais si vous misez un résultat de conformité sur le passage de 300 lignes à 150, la seule expérience directe qui existe dit que vous ne verrez pas la différence. L'effet du milieu perdu, ensuite, l'idée que le centre d'un long contexte passe à la trappe, est invoqué en permanence pour remonter les règles en tête de fichier. McMillan a comparé une règle en ligne 2 à la même règle en ligne 250 : aucun effet.
Ce que les données soutiennent, en revanche, est la chose qu'aucune des deux études ne cherchait à mesurer, la distance à l'écriture. La décroissance au fil de la session qu'il mesure et notre écart entre règles servies et règles non servies sont le même phénomène observé par les deux bouts. Sur les 58 règles notées que notre couche a servies au moment de l'édition, 55 étaient exactes (95 %). Sur les 6 qu'elle n'a pas su servir, 4 ne l'étaient pas. Même agent, même session, même intelligence, distance différente. Alors triez vos règles selon une seule question : l'agent pourrait-il la deviner ?
Laissez dans le fichier ce que le fichier sait faire : les commandes de build, l'organisation du projet, les conventions qu'un ingénieur compétent adopterait de lui-même, et tout ce que l'agent ne produirait jamais spontanément. Cette dernière catégorie est justement celle qu'a mesurée l'étude à forte puissance statistique, et là, le fichier marche.
Faites descendre vos valeurs arbitraires au moment de l'écriture. Codes d'erreur, formats de noms de fichiers, seuils, forme de votre ligne d'audit, colonnes que votre export a le droit de contenir. Ce sont les règles qu'un fichier tient le plus mal, parce que l'agent a déjà une réponse concurrente plausible et que le fichier lui parle depuis trente mille tokens en arrière. Ce sont aussi celles derrière lesquelles il y a un régulateur ou un client.
Laissez les règles devenir de la structure. Quand une règle arrivait au moment de l'écriture, l'agent construisait le mécanisme qu'elle suppose : un registre de mouvements, une clé d'idempotence, un événement d'audit. Les tâches suivantes le réutilisaient, parfois sans que la règle soit servie à nouveau. Quand le ticket de piste d'audit est tombé, à la tâche 14, le bras qui émettait des événements d'audit depuis le début a bouclé la piste en 334 lignes ; les deux autres, qui n'en avaient jamais écrit un seul, l'ont reconstruite de zéro en 1 107 et 1 620 lignes. La conformité posée chemin faisant a coûté cinq fois moins de code que la conformité rattrapée.
Pour tout ce qui ne doit jamais arriver, arrêtez la prose. Anthropic est sans ambiguïté : « Pour bloquer une action quoi que Claude décide, utilisez plutôt un hook PreToolUse », et « les instructions du CLAUDE.md façonnent le comportement de Claude, mais elles ne constituent pas une couche d'application stricte. » Une règle que vous ne pouvez pas vous permettre de perdre est un hook ou une permission, pas une puce dans une liste. Et relisez le fichier lui-même comme du code, parce que quiconque peut y committer écrit la politique de votre agent : voir l'injection par fichier d'instructions.
Quel crédit accorder à ces chiffres ?
Moins qu'à ceux de McMillan, et nous préférons le dire nous-mêmes plutôt que vous laisser le découvrir. Un seul run par bras et par tâche, une seule base de code, un seul modèle, 25 tâches porteuses de règles et environ 65 règles notées par bras. Lui a fait 1 650 sessions et 16 050 observations. Les écarts principaux, 13 % contre 87 %, puis 64 % contre 100 %, sont trop larges pour être des accidents de comptage, mais les distributions secondaires se lisent avec cet échantillon en tête. Nous ne publions aucune valeur p, délibérément.
Nous avons aussi écrit le corpus, et nous vendons un outil qui sert les règles au moment de l'édition. Trois garde-fous s'opposent à ce biais : corpus et grilles de notation figés avant tout run, caractère devinable noté à l'avance, tickets vérifiés par machine contre les fuites de littéraux. Les auditeurs en aveugle sont des modèles, pas des humains ; une réplication avec des relecteurs humains serait l'étape suivante, et nous ne l'avons pas faite. L'étude rapporte aussi les endroits où notre propre bras a perdu.
Quatre autres limites, en bref. Deux sur-applications, des corrections justes faites au mauvais moment. Quatre règles jamais retrouvées, chacune dans une famille que le ticket ne visait pas, ce qui explique quatre des sept écarts de notre bras. Six tâches à livraison dégradée, à cause d'un échec d'authentification et d'une panne de canal, comptées contre nous plutôt qu'exclues. Treize faux positifs sur les gardes de commandes.
L'expérience de McMillan est la meilleure, la nôtre porte sur le cas le plus dur. Il a isolé la structure proprement, avec une cible qui n'avait aucun instinct concurrent ; nous avons choisi des cibles qui n'ont que cela, et nous avons payé ce choix en puissance statistique. Mises bout à bout, les deux études disent une chose simple : ce n'est pas la structure du fichier qui échoue, et les règles sur lesquelles un fichier échoue sont celles pour lesquelles vous l'avez écrit.
Ce que nous vendons, dit simplement
Servir la règle au moment où l'agent écrit, c'est notre produit. Cette étude le mesure, et elle dit aussi ce que le produit ne sait pas faire.
VibeDefend s'installe dans l'environnement de l'agent, pas dans votre dépôt. Un hook se déclenche avant chaque édition de fichier et place dans le contexte du modèle les règles pertinentes pour ce fichier et pour cette intention, juste avant l'écriture. Sur les 30 tâches, cela a représenté 669 injections de règles métier et 1 078 injections de règles de sécurité, pour environ un dollar par ticket.
Ce qu'il ne fait pas, c'est imposer. Si la tâche M24 figure dans cet article, c'est parce qu'elle marque la frontière la plus nette de ce que nous vendons. La partie déterministe de la couche, c'est la garde posée sur l'action, pas la règle placée dans le contexte, et nous préférons dire laquelle des deux est un contrôle plutôt que de laisser croire que les deux le sont. Le modèle d'ensemble est décrit dans la sécurité des agents de code IA.
Questions fréquentes
Comment écrire un bon CLAUDE.md ?
Triez vos règles selon ce que le modèle peut deviner, et cessez de régler la structure du fichier. Le seul test factoriel direct, mené sur 1 650 sessions Claude Code, ne trouve aucun effet détectable de la taille du fichier, de la position de l'instruction, du découpage en plusieurs fichiers ni des contradictions avec les fichiers voisins, et une instruction en ligne 2 n'y fait pas mieux que la même en ligne 250. Gardez dans le fichier ce qu'un ingénieur compétent appliquerait de toute façon, faites descendre vos valeurs arbitraires au moment de l'écriture, et transformez en hook tout ce qui ne doit jamais arriver.
Que mettre dans un CLAUDE.md, concrètement ?
Les commandes de build, l'organisation du projet, les conventions maison, et tout ce que l'agent ne produirait jamais de lui-même. C'est cette dernière catégorie qu'a mesurée l'étude la mieux dotée, et le fichier y fait son travail. Ce qui n'y a pas sa place, ce sont vos valeurs à vous, codes d'erreur, formats de nom de fichier, seuils : sur les 13 règles où notre fichier portait la valeur exacte noir sur blanc, l'agent ne l'a reprise telle quelle que 4 fois.
Quelle longueur doit faire un CLAUDE.md ?
Assez court pour votre budget de contexte, mais ce n'est pas la longueur qui décide qu'une règle sera suivie. Anthropic recommande de viser moins de 200 lignes par fichier, et dégraisser un fichier obèse reste une bonne hygiène. L'étude factorielle, elle, ne trouve aucun effet détectable de la taille, avec un facteur de Bayes qui plaide pour le nul : n'attendez pas d'un fichier plus court qu'il fasse survivre une règle donnée jusqu'à l'écriture.
Faut-il des règles CLAUDE.md par framework, React ou Next.js ?
Oui pour les conventions, non pour vos valeurs à vous. Une convention de framework qu'un développeur du métier appliquerait spontanément a toute sa place dans le fichier : c'est exactement la classe de règles sur laquelle il fonctionne. Vos codes d'erreur, vos formats et vos seuils maison sont la classe qu'il tient le plus mal, parce que l'agent a déjà sous les yeux une réponse plausible concurrente.
Faut-il committer le CLAUDE.md dans le dépôt ?
Oui, puis le relire comme du code, parce que quiconque peut y committer écrit la politique de votre agent. Committer n'est pas appliquer, en revanche. La section de règles de notre étude était bien dans le dépôt et chargée à chaque démarrage de session, et le code qu'elle a produit était indiscernable de celui du bras qui n'avait aucun fichier de règles.
Pourquoi Claude Code ne suit-il pas mes règles ?
Le plus souvent, il dilue plutôt qu'il n'ignore. Le fichier est chargé une seule fois, et à la trentième édition ce n'est plus qu'un vieux fragment enfoui sous des dizaines de milliers de tokens de code, de sorties de commandes et de raisonnement. L'étude factorielle de Damon McMillan mesure la même chose par l'autre bout : chaque fonction supplémentaire générée par l'agent fait baisser d'environ 5,6 % les chances de conformité. La seconde cause, c'est votre propre base de code, qui montre à l'agent comment on fait ici, et qui compile.
Claude Code lit-il AGENTS.md ou seulement CLAUDE.md ?
Seulement CLAUDE.md, sauf si vous câblez AGENTS.md vous-même. La documentation d'Anthropic est explicite, Claude Code lit CLAUDE.md et pas AGENTS.md, et propose comme passerelle un import @AGENTS.md ou un lien symbolique. Aucun des deux fichiers ne vaut mieux que l'autre : c'est le même mécanisme dans les deux cas, un document chargé en contexte au démarrage de la session, donc le même mode de défaillance.
Le CLAUDE.md sert-il vraiment à quelque chose ?
Oui pour une classe de règles, non pour celle qui vous a fait écrire le fichier. McMillan mesurait une annotation triviale, que l'agent n'a aucune raison d'écrire si le fichier ne la réclame pas, et là le fichier fait passer la conformité de presque rien à quelque chose. Notre étude a pris le cas inverse, des règles pour lesquelles l'agent a déjà une réponse plausible : une section de règles réaliste y fait exactement le score de l'absence de fichier, 7 valeurs exactes sur 55.
Karpathy a-t-il vraiment mesuré des erreurs qui tombent de 40 % à 11 % avec un CLAUDE.md ?
Nous n'avons trouvé aucune source primaire pour ce chiffre. Il circule dans des fils sociaux et des reprises de seconde main, sous plusieurs formes, 40 % ou 41 % vers 11 %, sans méthode publiée ni taille d'échantillon vérifiable. Les mesures qui ont un article ou un protocole derrière elles sont moins flatteuses : McMillan ne trouve aucun effet détectable des quatre variables de structure sur 1 650 sessions, et nos 90 runs mettent un fichier de règles réaliste à égalité avec l'absence de fichier.
Comment imposer vraiment une règle dans Claude Code ?
Pas avec de la prose. Anthropic renvoie au hook PreToolUse, « pour bloquer une action quoi que Claude décide », et aux réglages managés pour les permissions, puisque « les règles de configuration sont appliquées par le client, quoi que Claude décide de faire ». Une règle que vous ne pouvez pas vous permettre de perdre relève d'un hook ou d'une permission. Une règle avec laquelle vous voulez que l'agent raisonne relève de son contexte, au moment exact où il écrit.


