


Sur cette page
- Que transmet Claude Code à Anthropic ?
- Claude Code est-il conforme au RGPD ?
- Anthropic utilise-t-il votre code pour entraîner Claude ?
- Combien de temps Anthropic conserve-t-il les données de Claude Code ?
- Que garde Claude Code sur votre propre machine ?
- Claude Code peut-il lire votre fichier .env ?
- Comment tenir les secrets et le code réglementé hors de portée de Claude Code ?
- Ce qu'aucun réglage de confidentialité ne couvre
- Questions fréquentes
- Claude Code est-il conforme au RGPD ?
- Claude Code envoie-t-il mon code à Anthropic ?
- Anthropic utilise-t-il mon code pour entraîner Claude ?
- Comment désactiver l'entraînement sur mon code dans Claude Code ?
- Combien de temps Anthropic garde-t-il les données de Claude Code ?
- Où sont stockées les données de Claude Code, et peuvent-elles rester en Europe ?
- Claude Code est-il certifié SOC 2 ou ISO 27001 ?
- Claude Code peut-il lire mon fichier .env ?
- Claude Code stocke-t-il mon code sur mon ordinateur ?
- Peut-on utiliser Claude Code en entreprise sur du code confidentiel ?
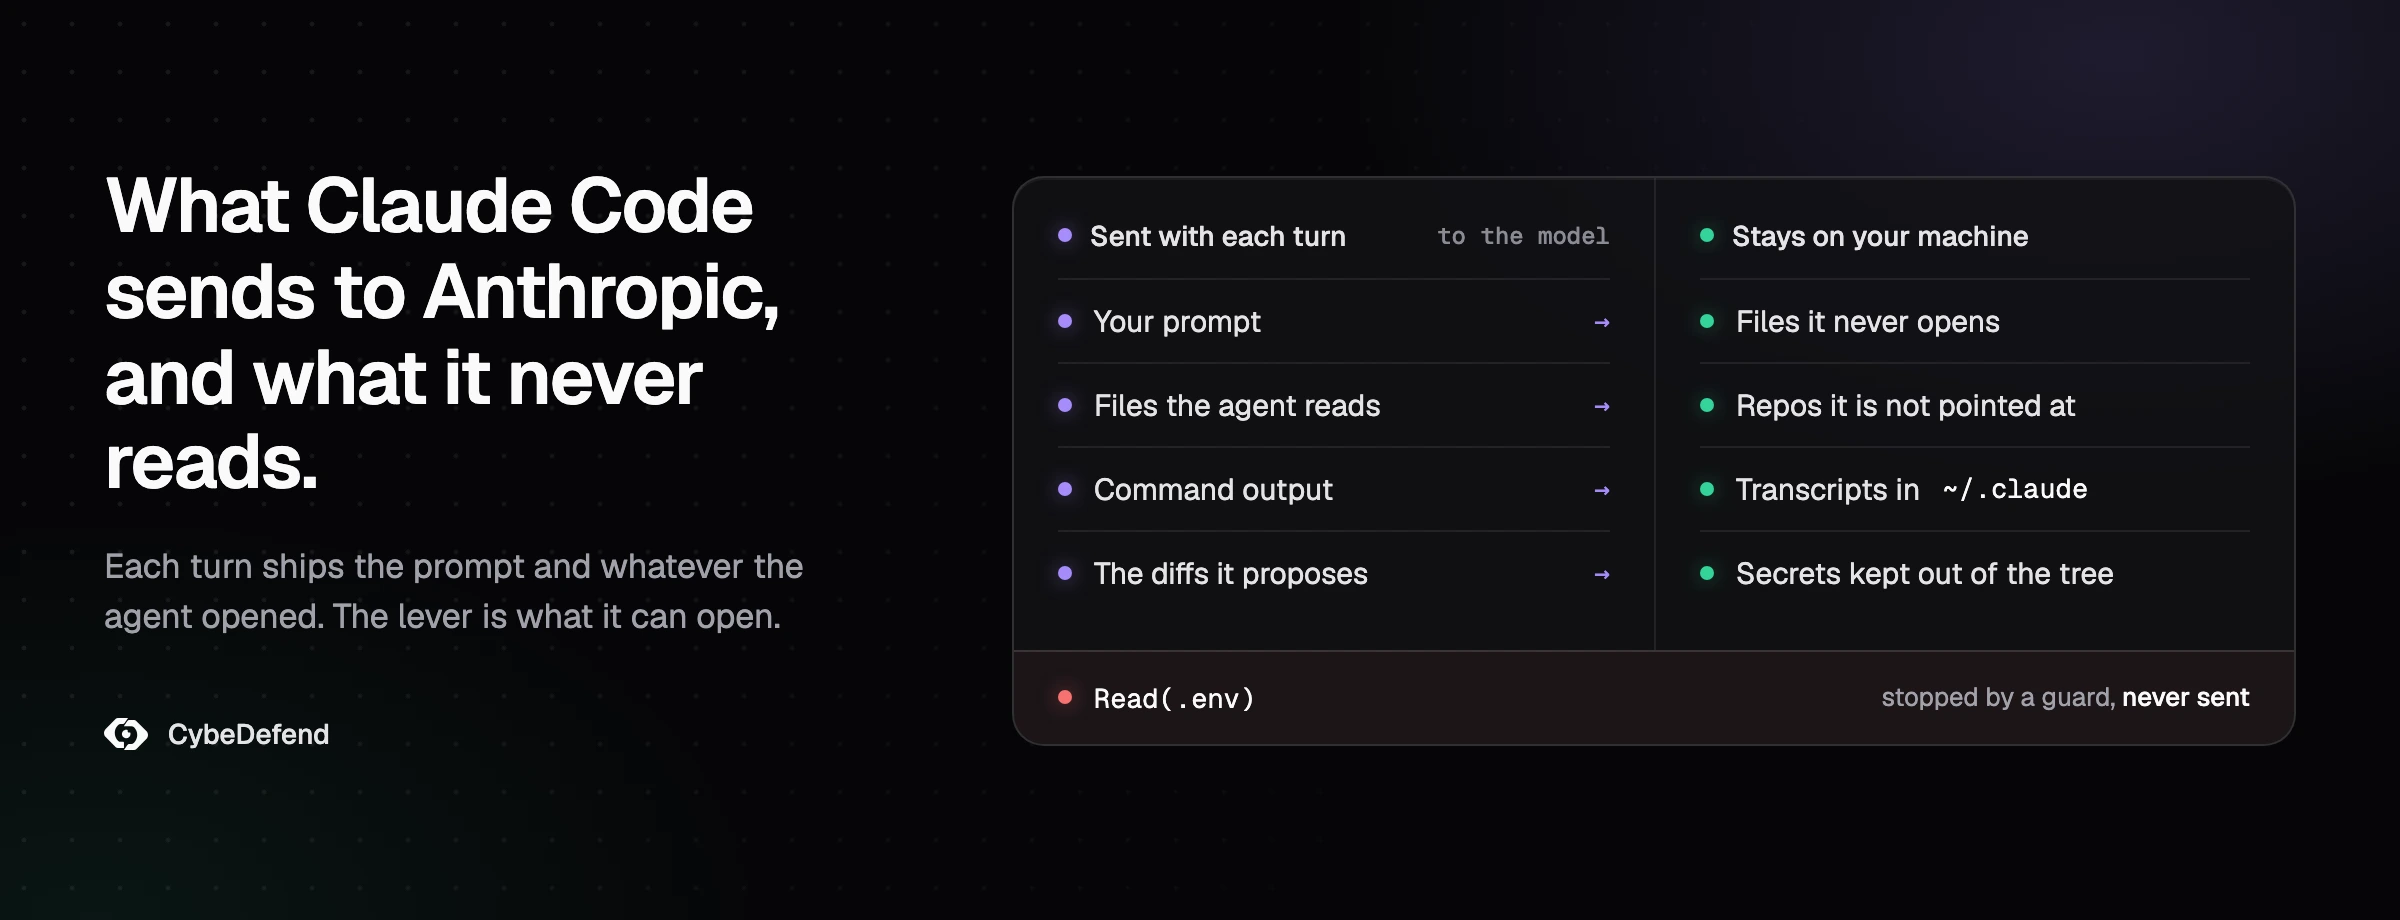
Claude Code est-il compatible avec le RGPD ? Il faut d'abord savoir ce qui sort de la machine, et là, la réponse est simple : oui, Claude Code envoie votre code à Anthropic. Chaque prompt, chaque réponse et tout ce que l'agent place dans sa fenêtre de contexte, les fichiers qu'il lit comme la sortie des commandes qu'il lance, partent vers le modèle, parce que c'est ainsi qu'un agent travaille. Les questions utiles sont plus étroites. Le compte avec lequel vous êtes connecté décide si ce code peut entraîner un modèle, et combien de temps il est conservé. Une partie reste sur votre disque, en clair. Le RGPD appelle une réponse précise, qui n'est ni oui ni non. Et quelques réglages décident de ce que l'agent a le droit d'ouvrir. Ce guide les reprend une à une, documentation d'Anthropic à l'appui, lue le 11 octobre 2026.
Que transmet Claude Code à Anthropic ?
Tout ce dont le modèle a besoin pour répondre, bien au-delà de votre prompt. La page d'Anthropic sur l'utilisation des données le pose sans détour : Claude Code tourne en local, mais pour dialoguer avec le modèle il envoie des données sur le réseau, à savoir l'ensemble des prompts et des réponses du modèle, chiffrés en transit en TLS 1.2 ou supérieur.
Ce qu'on oublie, c'est ce que recouvre le mot prompt. La page qui décrit le fonctionnement de Claude Code énumère le contenu de la fenêtre de contexte : l'historique de la conversation, le contenu des fichiers, la sortie des commandes, CLAUDE.md, la mémoire automatique, les skills chargés et les instructions système. Le modèle ne voit que ce qui se trouve dans cette fenêtre. Chaque échange emporte donc, avec vos mots, les fichiers que l'agent a ouverts et la sortie des commandes qu'il a exécutées. Si l'agent lance cat config ou git log -p, le résultat part avec la requête suivante.
Trois modes d'utilisation en envoient davantage qu'une session locale :
- Claude Code sur le web clone votre dépôt dans la machine virtuelle isolée de la session, chez Anthropic, et Anthropic conserve la transcription de la session pour que vous puissiez y revenir plus tard.
- Remote Control, tant que la connexion est active, stocke lui aussi la transcription sur les serveurs d'Anthropic, afin de la synchroniser entre vos appareils.
- WebFetch envoie à
api.anthropic.comle nom d'hôte de chaque URL consultée, pour le comparer à une liste de blocage tenue par Anthropic. D'après la même page, cette vérification a lieu quel que soit le fournisseur du modèle, et même quand le trafic non essentiel est coupé. Seul le nom d'hôte part, ni le chemin ni le contenu de la page. Le réglageskipla désactive.Web Fetch Preflight
Ce qui ne part jamais, c'est ce que l'agent n'ouvre jamais : tout ce guide tourne autour de ce levier. Une mise en garde, tirée de la page sécurité d'Anthropic : la limite du répertoire de travail n'est qu'une demande de permission, si bien qu'une commande Bash que vous approuvez peut écrire partout où votre compte utilisateur a accès. C'est une question posée, pas un mur.
Si vous faites tourner Claude Code via Amazon Bedrock ou Google Cloud (Vertex AI, rebaptisé Agent Platform), les requêtes partent vers ce cloud, sous ses propres conditions. Avec Microsoft Foundry, tout dépend de l'hébergement du modèle : sur Azure, les prompts et les réponses restent dans Azure, mais les métadonnées d'usage et les contenus signalés par les systèmes de sécurité d'Anthropic partent tout de même chez Anthropic ; hébergées chez Anthropic, les requêtes arrivent sur sa propre infrastructure. Et quel que soit le fournisseur, la vérification des noms d'hôte de WebFetch atteint toujours Anthropic, d'après la même page.
Claude Code est-il conforme au RGPD ?
Aucun outil n'est conforme au RGPD à lui seul : ce qui peut l'être, c'est l'usage qu'en fait votre organisation, et Anthropic fournit les documents qui permettent de le démontrer. Voici les faits que votre DPO vous demandera.
- Qui est responsable. Pour les comptes grand public dans l'Espace économique européen, au Royaume-Uni et en Suisse, la politique de confidentialité d'Anthropic (en vigueur depuis le 10 septembre 2026) désigne comme responsable du traitement « Anthropic Ireland, Limited », et donne le contact de son délégué à la protection des données. En usage professionnel, Anthropic agit comme votre sous-traitant au titre de son Data Processing Addendum, en vigueur depuis le 24 février 2025, qui intègre les clauses contractuelles types (modules deux et trois) et relève du droit irlandais. Ce DPA fait automatiquement partie des Commercial Terms ; sur Bedrock ou Google Cloud, ce sont les conditions de la plateforme qui s'appliquent.
- Où sont stockées les données. Aux États-Unis. Dans sa propre réponse sur l'hébergement en Europe, Anthropic explique que le trafic peut être acheminé vers les États-Unis, l'Europe, l'Asie et l'Australie, puis précise : « Note that data is stored in the US », les données sont stockées aux États-Unis. Sur l'API Claude, les réglages de résidence des données ne proposent que deux zones d'inférence,
"global"et"us", et"us"est aujourd'hui la seule zone de stockage possible pour un espace de travail. - Comment garder les requêtes en Europe. En passant par un cloud. La documentation de Claude Code décrit un préfixe d'inférence
eusur Amazon Bedrock (ANTHROPIC) et une localisation multirégion_BEDROCK _REGION _PREFIX= eu eusur Google Cloud (CLOUD_ML_REGION=eu). Tous les modèles ne sont pas proposés dans toutes les régions : vérifiez la disponibilité de celui dont vous avez besoin avant de vous engager. - Ce qui est certifié. Le centre de confidentialité d'Anthropic cite ISO 27001:2022, ISO/IEC 42001:2023, SOC 2 Type I et Type II, ainsi qu'une configuration compatible HIPAA. Elles attestent des contrôles d'Anthropic, pas de votre usage.
Les autorités européennes ont dit ce qu'elles attendent de celui qui déploie l'outil, et leurs attentes recoupent les réglages décrits plus bas. La CNIL d'abord. Dans ses premières précisions publiées le 18 juillet 2024, « Comment déployer une IA générative ? », elle recommande de privilégier des systèmes locaux, sécurisés et spécialisés, puis ajoute qu'à défaut, « il faut déterminer dans quelle mesure le prestataire opérant le système est susceptible de réutiliser les données fournies au système d'IA, et adapter l'usage en conséquence ». Le modèle de Claude Code ne tournant pas sur votre poste, c'est cette seconde exigence qui s'applique, et la section suivante y répond. En Allemagne, la conférence des autorités de protection des données (DSK), dans son guide sur l'IA et la protection des données du 6 mai 2024, juge préférables les applications qui n'utilisent pas les saisies pour l'entraînement, et suggère de configurer dès leur ouverture les comptes des salariés pour qu'aucune saisie n'entraîne un modèle et qu'aucun historique ne soit conservé au-delà de la session. En Espagne, l'AEPD a publié en février 2026 (version 1.2) des orientations sur l'IA agentique, le seul texte d'autorité que nous ayons trouvé qui traite spécifiquement des agents.
En pratique, la question RGPD d'une équipe porte rarement sur le code source lui-même. Elle porte sur les données personnelles qui l'entourent : des fiches clients dans les fixtures, un dump de production oublié dans tmp/, des adresses e-mail dans un fichier de log, des clés d'accès à des bases remplies de personnes. Ce sont ces fichiers qu'il faut tenir hors de portée de l'agent, et la section sur le .env montre comment.
Anthropic utilise-t-il votre code pour entraîner Claude ?
Tout dépend de votre compte : grand public, oui si un réglage est activé ; professionnel, non.
Pour Free, Pro et Max, la page sur l'utilisation des données l'écrit clairement : Anthropic entraîne de nouveaux modèles avec les données de ces comptes quand le réglage est activé, y compris lorsque vous utilisez Claude Code depuis ces comptes. Ce réglage est celui qu'Anthropic a introduit avec la mise à jour de ses conditions grand public du 28 août 2025, en laissant aux utilisateurs existants jusqu'au 8 octobre 2025 pour faire leur choix. Dans les paramètres de confidentialité, il porte le nom « Help Improve our AI models », et la documentation de Claude Code renvoie directement vers claude.
Le couper n'a rien de rétroactif : la même annonce précise que vos données restent incluses dans les entraînements déjà lancés et dans les modèles déjà entraînés ; Anthropic cesse seulement de se servir des sessions déjà stockées pour les entraînements à venir.
Pour Team, Enterprise, l'API, Bedrock, Google Cloud et Claude Gov, la documentation est catégorique : « Anthropic does not train generative models using code or prompts sent to Claude Code under commercial terms ». Sous conditions commerciales, ni votre code ni vos prompts n'entraînent donc de modèle, sauf si le client a choisi de fournir ses données pour améliorer les modèles, par exemple dans le cadre du Development Partner Program. Ce programme est une adhésion volontaire, décidée par un administrateur et réservée à l'API propre d'Anthropic.
Trois chemins envoient votre code chez Anthropic même quand le réglage d'entraînement est coupé, et ce sont eux qu'une politique d'équipe doit nommer :
- Le feedback. Lancer
/feedbackenvoie à Anthropic une copie de l'historique de la conversation, code compris. Les transcriptions partagées par/feedback,/bugou/sharesont conservées 5 ans. Sur un compte grand public, un pouce levé ou baissé fait lui aussi stocker la conversation entière, jusqu'à 5 ans. - L'enquête de fin de session. La note elle-même n'envoie rien de plus, mais répondre « Yes » à la question qui suit téléverse la transcription et le journal brut de la session. Le code source et le contenu des fichiers partent tels quels, restent conservés jusqu'à 6 mois et ne servent jamais à l'entraînement.
- Les signalements de sécurité. Le centre de confidentialité d'Anthropic précise que les conversations signalées pour un examen de sécurité peuvent encore servir à entraîner les modèles de son équipe Safeguards.
Combien de temps Anthropic conserve-t-il les données de Claude Code ?
Trente jours pour l'essentiel des usages professionnels, 30 jours ou 5 ans sur un compte grand public, davantage dans quelques cas. Les durées ci-dessous proviennent de la page sur l'utilisation des données, de la page Zero Data Retention et du centre de confidentialité.
| Situation | Ce qui est conservé |
|---|---|
| Free, Pro ou Max, entraînement activé | Jusqu'à 5 ans, sous forme désidentifiée, pour les sessions nouvelles ou reprises après l'activation du réglage |
| Free, Pro ou Max, entraînement désactivé | 30 jours |
| Team, Enterprise ou API | 30 jours en standard (les sessions que le produit permet de rouvrir y restent conservées, voir plus bas) |
| Claude for Enterprise avec Zero Data Retention | Rien une fois la réponse renvoyée, sauf obligation légale ou lutte contre les abus |
| Session signalée pour violation des règles d'usage | Entrées et sorties jusqu'à 2 ans, scores de classification de sécurité jusqu'à 7 ans |
Transcriptions envoyées par /feedback, /bug ou /share | 5 ans |
| Transcription envoyée en répondant « Yes » à l'enquête de session | Jusqu'à 6 mois |
Deux nuances pour les offres professionnelles. Avec Team et Enterprise, les conversations et les sessions de code que le produit permet de rouvrir, Claude Code sur le web compris, sont conservées dans le produit à cette fin ; et d'après le centre de confidentialité, les durées de conservation personnalisées d'Enterprise ne s'appliquent pas aux fonctionnalités bâties sur Claude Code sur le web. Sur Bedrock ou Google Cloud, enfin, la conservation suit votre environnement cloud, pas le tableau d'Anthropic.
Zero Data Retention demande une lecture attentive. Pour Claude Code, l'option est réservée aux comptes éligibles de Claude for Enterprise : elle ne fait pas partie de l'offre standard, ne s'active pas depuis les paramètres d'administration, et Anthropic la met en place organisation par organisation. Le centre de confidentialité ajoute l'autre voie : une organisation qui a signé un accord de rétention zéro couvre aussi Claude Code utilisé avec sa clé API commerciale. Dans les deux cas, elle ne couvre pas un développeur connecté avec un compte personnel ou avec une clé API d'une autre organisation, ni les données traitées par des serveurs MCP ou d'autres intégrations externes. Enfin, depuis le 9 juin 2026, la politique d'Anthropic sur les modèles dits couverts impose 30 jours de conservation pour les prompts et les réponses de ses modèles de classe Mythos, Claude Fable 5 et 5.1 compris, sur toutes les plateformes qui les proposent. La page Zero Data Retention les range parmi les modèles qui exigent par défaut une conservation.
Que garde Claude Code sur votre propre machine ?
Plus qu'on ne l'imagine, et en clair. D'après la page sur l'utilisation des données, Claude Code stocke les transcriptions de session en texte clair sous ~/.claude/projects/, pendant 30 jours par défaut, pour que vous puissiez reprendre une session. Le réglage cleanupPeriodDays modifie cette durée ; son minimum est de 1, et la valeur 0 est refusée.
Deux autres fichiers méritent une ligne dans votre politique. La référence du répertoire .claude décrit ~ comme le fichier qui contient chaque prompt que vous avez tapé, avec son horodatage et le chemin du projet. Et les transcriptions des sessions lancées ou reprises dans Claude Desktop ou Cowork sont conservées quel que soit leur âge, sauf si vous définissez desktop (Claude Code 2.1.248 ou ultérieur).
Conséquence concrète : un secret lu par l'agent dort un mois, par défaut, dans une transcription sur le disque, à la portée des sauvegardes, des clients de synchronisation et de quiconque accède au portable. Raccourcir la conservation ne coûte rien ; ne jamais lire le secret vaut mieux.
Claude Code peut-il lire votre fichier .env ?
Oui, s'il se trouve dans le projet et que rien ne l'interdit. En janvier 2026, The Register a fait le test sur Claude Code 2.1.12 : avec .env listé dans un fichier .claudeignore, la rédaction a demandé à Claude de lire le fichier, et Claude l'a lu ; une règle deny dans settings.json, elle, a bloqué la lecture. La page d'Anthropic sur les permissions est désormais explicite : un fichier .claudeignore présent dans le projet n'a aucun effet, et ses entrées doivent passer dans des règles deny Read.
La correction documentée est donc une règle deny. L'exemple ci-dessous est adapté de celui que donne Anthropic sur sa page des réglages :
{
  "permissions": {
    "deny": [
      "Read(./.env)",
      "Read(./.env.*)"
    ]
  }
}
Trois détails décident de sa solidité. Read(./.env) ne vise que le répertoire dans lequel Claude Code a été lancé, alors qu'un Read(.env) sans préfixe suit la syntaxe de gitignore et correspond à n'importe quelle profondeur : dans un monorepo, c'est cette forme nue qu'il faut. Une règle deny couvre les outils de fichiers de Claude, les commandes de fichiers que Claude Code reconnaît dans Bash (cat, head, tail, sed, tee) et les redirections ; elle ne couvre pas un script Python ou Node qui ouvre lui-même ses fichiers. Et grep -r reste en zone grise : la page des permissions indique que la règle ne s'y applique pas, le changelog de la version 2.1.259 affirme qu'il demande désormais une confirmation, et un ticket encore ouvert (#91690) signale que le correctif ne se reproduit pas sous Windows avec l'extension VS Code. Pour un blocage que tous les processus respectent, la documentation renvoie à la sandbox, où une interdiction sandbox tient même à l'intérieur d'une autorisation plus large. La sandbox documente aussi un piège : les commandes qui s'y exécutent héritent des variables d'environnement de Claude Code, secrets compris, à moins que vous ne définissiez CLAUDE.
C'est aussi là qu'un garde-fou a sa place. VibeDefend, la couche que CybeDefend installe dans Claude Code, Cursor et Codex, livre ses garde-fous avec des règles prévues pour exactement ces lectures, actives par défaut. Sa règle sur .env bloque les outils Read, Glob et Grep sur **/.env et **/.env.* (à l'exception des modèles comme .env.example). Une deuxième règle bloque les fichiers de secrets reconnus à leur nom (secrets.*, credentials.json). Une troisième ferme la voie du shell : cat, grep, jq, cp et consorts, ainsi que les runtimes comme node -e ou python -c pointés vers un fichier secret. Afficher une variable dont le nom évoque un secret est bloqué aussi, et le vidage de tout l'environnement déclenche un avertissement. La décision se prend sur votre portable, avant que l'outil ne s'exécute : une lecture bloquée n'envoie rien au modèle.
Un garde-fou qui compare le texte des commandes reste une ceinture de sécurité, pas un mur. La note GuardFall de la Cloud Security Alliance, publiée en juillet 2026, a contourné par injection shell les gardes de commandes de dix agents open source sur onze (Claude Code ne faisait pas partie du panel), et sa conclusion vaut pour tous les outils de ce type, le nôtre compris : de tels gardes « cannot be trusted as a primary control », on ne peut pas en faire le contrôle principal. Le contrôle principal, c'est un secret absent de l'arborescence.
Comment tenir les secrets et le code réglementé hors de portée de Claude Code ?
D'abord le compte, ensuite ce que l'agent peut ouvrir, enfin ce qu'il laisse derrière lui. Par ordre d'impact :
- Choisissez l'identité en fonction des données. Le code de l'entreprise passe par un siège Team ou Enterprise, une clé API de l'organisation, ou Bedrock ou Google Cloud, jamais par un compte personnel. Les requêtes qui doivent rester dans l'Union européenne passent par le préfixe
eude Bedrock ou par la localisationeude Google Cloud. - Sur un abonnement personnel, vérifiez l'interrupteur. C'est « Help Improve our AI models », dans les paramètres Privacy. Rappelez ensuite à l'équipe que
/feedbacket le « Yes » de l'enquête envoient quand même la transcription. - Sortez les secrets actifs de l'arborescence. Un gestionnaire de secrets injecté à l'exécution vaut mieux que n'importe quelle règle. Ce qui n'est pas sur le disque ne peut pas être lu.
- Interdisez les lectures, de façon centralisée. Placez
Read(.env),Read(.env.*)et vos propres chemins de secrets dans les managed settings, pour que la règle s'impose à chaque développeur. Supprimez.claudeignore: il ne fait rien. - Activez la sandbox pour les chemins qui comptent.
sandboxbloque tous les processus, scripts compris, et.filesystem .deny Read CLAUDEretire les identifiants de l'environnement dont héritent les commandes de l'agent._CODE _SUBPROCESS _ENV _SCRUB - Réduisez ce qui reste sur le disque. Baissez
cleanupPeriodDays, définissezdesktop, et faites entrerSession Cleanup Period Days ~dans la politique de sécurité de vos postes./ .claude /history .jsonl - Coupez le trafic facultatif.
CLAUDEdésactive les mises à jour automatiques, la télémétrie, le signalement d'erreurs et_CODE _DISABLE _NONESSENTIAL _TRAFFIC= 1 /feedback. Il n'arrête pas la vérification des noms d'hôte de WebFetch ;skip, si. Quant aux métriques, Anthropic affirme qu'elles ne contiennent jamais ni code, ni prompts, ni chemins de fichiers.Web Fetch Preflight - Surveillez votre propre observabilité. OpenTelemetry est désactivé par défaut et masque les prompts. Activer
OTELou_LOG _USER _PROMPTS OTELrecopie le code et les conversations dans votre collecteur, qui exige alors la même protection que le code._LOG _RAW _API _BODIES - Cherchez les secrets avant qu'ils ne soient lus, et avant qu'ils ne soient committés. Une clé qu'un scanner signale aujourd'hui, c'est une clé que la prochaine session ne chargera pas dans son contexte.
Ce qu'aucun réglage de confidentialité ne couvre
Tous les contrôles qui précèdent portent sur ce que Claude Code lit et envoie. Aucun ne porte sur ce qu'il écrit, et le code qu'il écrit pose ses propres questions de protection des données. Un agent qui code en dur un token aperçu dans une fixture, journalise le corps complet d'une requête contenant l'e-mail d'un client, ou renvoie des enregistrements que l'appelant n'avait pas le droit de voir, crée un problème RGPD qu'aucune durée de conservation ne réglera : la fuite vit désormais dans votre dépôt et vos logs de production.
C'est la couche que VibeDefend ajoute pendant que l'agent écrit. Elle sert vos règles métier et de sécurité à la ligne en cours d'édition, arrête l'action dangereuse avant qu'elle ne s'exécute, et analyse le diff avant le commit (SAST, IaC et secrets). Puisque cet article parle de l'endroit où part le code, voici ce que fait le nôtre. Les garde-fous décident sur votre portable. Pour servir les règles qui correspondent à la ligne en train d'être écrite, VibeDefend envoie un court extrait de ce code au backend de CybeDefend, dans la région UE ou US que vous choisissez à l'installation ; l'analyse avant le commit envoie les fichiers modifiés ; et votre code ne sert jamais à entraîner un modèle. La page sécurité détaille ce qui est conservé, et où.
Des règles servies à la ligne font aussi ce qu'un fichier ne sait pas faire. Dans l'étude contrôlée de CybeDefend, un même agent, sur trente tickets, a enfreint 2,28 règles par ticket sans outil, 2,27 avec un fichier de règles tenu à la main dans le dépôt, et 0,28 avec VibeDefend. Notre article qui demande si Claude Code suit vraiment CLAUDE.md explique pourquoi le fichier change si peu de choses.
Pour le reste du tableau, lisez notre guide des risques de sécurité de Claude Code et celui consacré à --dangerously-skip-permissions. Si votre équipe utilise aussi Codex, la même question côté OpenAI a ses propres réponses. Et si vous déployez Claude Code sur du code qui ne doit pas sortir de l'entreprise, parlons-en.
Questions fréquentes
Claude Code est-il conforme au RGPD ?
Claude Code peut s'utiliser de façon conforme au RGPD, mais c'est à votre organisation de le démontrer. En usage professionnel (Team, Enterprise, API), Anthropic agit comme sous-traitant, sous un Data Processing Addendum qui intègre les clauses contractuelles types et relève du droit irlandais ; pour les comptes grand public en Europe, le responsable du traitement est Anthropic Ireland. Les données sont stockées aux États-Unis, et un acheminement dans l'UE passe par Bedrock ou Google Cloud. Un abonnement Pro personnel sur du code d'entreprise reste le cas le plus difficile à défendre.
Claude Code envoie-t-il mon code à Anthropic ?
Oui. Chaque requête transporte votre prompt et tout ce qui se trouve dans la fenêtre de contexte de l'agent, dont le contenu des fichiers lus et la sortie des commandes exécutées, chiffrés en transit. Un fichier que l'agent n'ouvre jamais n'est jamais envoyé. Sur Bedrock ou Google Cloud, les requêtes partent vers ce cloud, même si la vérification des noms d'hôte de WebFetch atteint toujours Anthropic.
Anthropic utilise-t-il mon code pour entraîner Claude ?
Avec Claude Free, Pro ou Max, Anthropic n'entraîne ses modèles sur vos sessions Claude Code que si le réglage « Help Improve our AI models » est activé. Avec Claude Team, Enterprise, l'API, Bedrock ou Google Cloud, Anthropic ne s'en sert pas pour l'entraînement. Seule exception : une organisation qui adhère au Development Partner Program, proposé uniquement sur l'API propre d'Anthropic.
Comment désactiver l'entraînement sur mon code dans Claude Code ?
Avec un abonnement personnel, coupez « Help Improve our AI models » dans les paramètres de confidentialité de claude.ai. Le changement vaut pour les sessions à venir ; les entraînements déjà lancés gardent les données. Autre voie : un siège Team ou Enterprise, une clé API de l'organisation, Bedrock ou Google Cloud, où l'entraînement est désactivé par défaut. Sur du code sensible, évitez /feedback et le « Yes » de l'enquête, qui envoient tous deux la transcription.
Combien de temps Anthropic garde-t-il les données de Claude Code ?
Sur un compte grand public, 30 jours si l'entraînement est désactivé, jusqu'à 5 ans s'il est activé. Avec Team, Enterprise et l'API, 30 jours en standard. Les entrées et sorties d'une session signalée sont gardées jusqu'à 2 ans, les transcriptions envoyées par /feedback 5 ans. Zero Data Retention existe pour les organisations Claude for Enterprise éligibles et pour les organisations API liées par un accord de rétention zéro, sur décision d'Anthropic.
Où sont stockées les données de Claude Code, et peuvent-elles rester en Europe ?
Aux États-Unis. L'API d'Anthropic n'offre pas aujourd'hui de résidence européenne : l'inférence tourne dans une zone mondiale ou américaine, le stockage aux États-Unis. Pour garder les requêtes en Europe, faites passer Claude Code par Amazon Bedrock avec le préfixe d'inférence eu, ou par Google Cloud avec la localisation multirégion eu, sous les conditions de ce cloud, et vérifiez que votre modèle y est disponible.
Claude Code est-il certifié SOC 2 ou ISO 27001 ?
Anthropic cite parmi ses certifications SOC 2 Type I et Type II, ISO 27001:2022 et ISO/IEC 42001:2023, ainsi qu'une configuration compatible HIPAA pour Claude for Enterprise. Elles couvrent les contrôles d'Anthropic. Votre auditeur SOC 2 voudra quand même savoir comment votre équipe configure Claude Code : quels comptes, quelles règles deny, quelle durée de conservation.
Claude Code peut-il lire mon fichier .env ?
Oui, sauf si vous l'interdisez. Ajoutez Read(.env) et Read(.env.*) à la liste deny de settings.json ; un fichier .claudeignore n'a aucun effet. Une règle deny couvre les outils de fichiers de Claude et les commandes shell reconnues comme cat, pas les scripts qui ouvrent le fichier eux-mêmes : activez la sandbox pour un blocage au niveau du système, et gardez les secrets actifs hors du projet.
Claude Code stocke-t-il mon code sur mon ordinateur ?
Oui. Les transcriptions de session, y compris ce que l'agent a lu, sont stockées en clair sous ~/.claude/projects/ pendant 30 jours par défaut, une durée réglable avec cleanupPeriodDays (minimum 1). Chaque prompt que vous tapez rejoint ~, et les transcriptions de Claude Desktop et de Cowork sont gardées sans limite d'âge tant que vous n'avez pas défini desktop.
Peut-on utiliser Claude Code en entreprise sur du code confidentiel ?
Oui, avec la bonne configuration : un compte professionnel plutôt qu'un compte personnel, des secrets sortis du projet et interdits par règle, la sandbox activée sur les chemins sensibles, une conservation locale courte, et pas de /feedback sur le code d'un client. Reste le code que l'agent écrit, qui demande ses propres vérifications avant d'arriver dans un commit.