


Sur cette page
- Quelles données Codex envoie-t-il à OpenAI ?
- Votre code sert-il à entraîner les modèles d'OpenAI ?
- Que conserve Codex sur votre machine ?
- Codex peut-il « voler » votre code ?
- Comment tenir les secrets et le code sensible hors de portée de Codex ?
- Ce que les réglages de confidentialité ne couvrent pas
- Questions fréquentes
- Le code que je confie à Codex part-il chez OpenAI ?
- Codex en entreprise : notre code sert-il à entraîner les modèles d'OpenAI ?
- Comment désactiver l'entraînement sur mon code dans Codex ?
- Codex garde-t-il une copie de mes sessions sur mon ordinateur ?
- Codex peut-il lire mon fichier .env ?
- Codex et RGPD : les données peuvent-elles rester en Europe ?
- Peut-on utiliser Codex en entreprise sur du code propriétaire ?
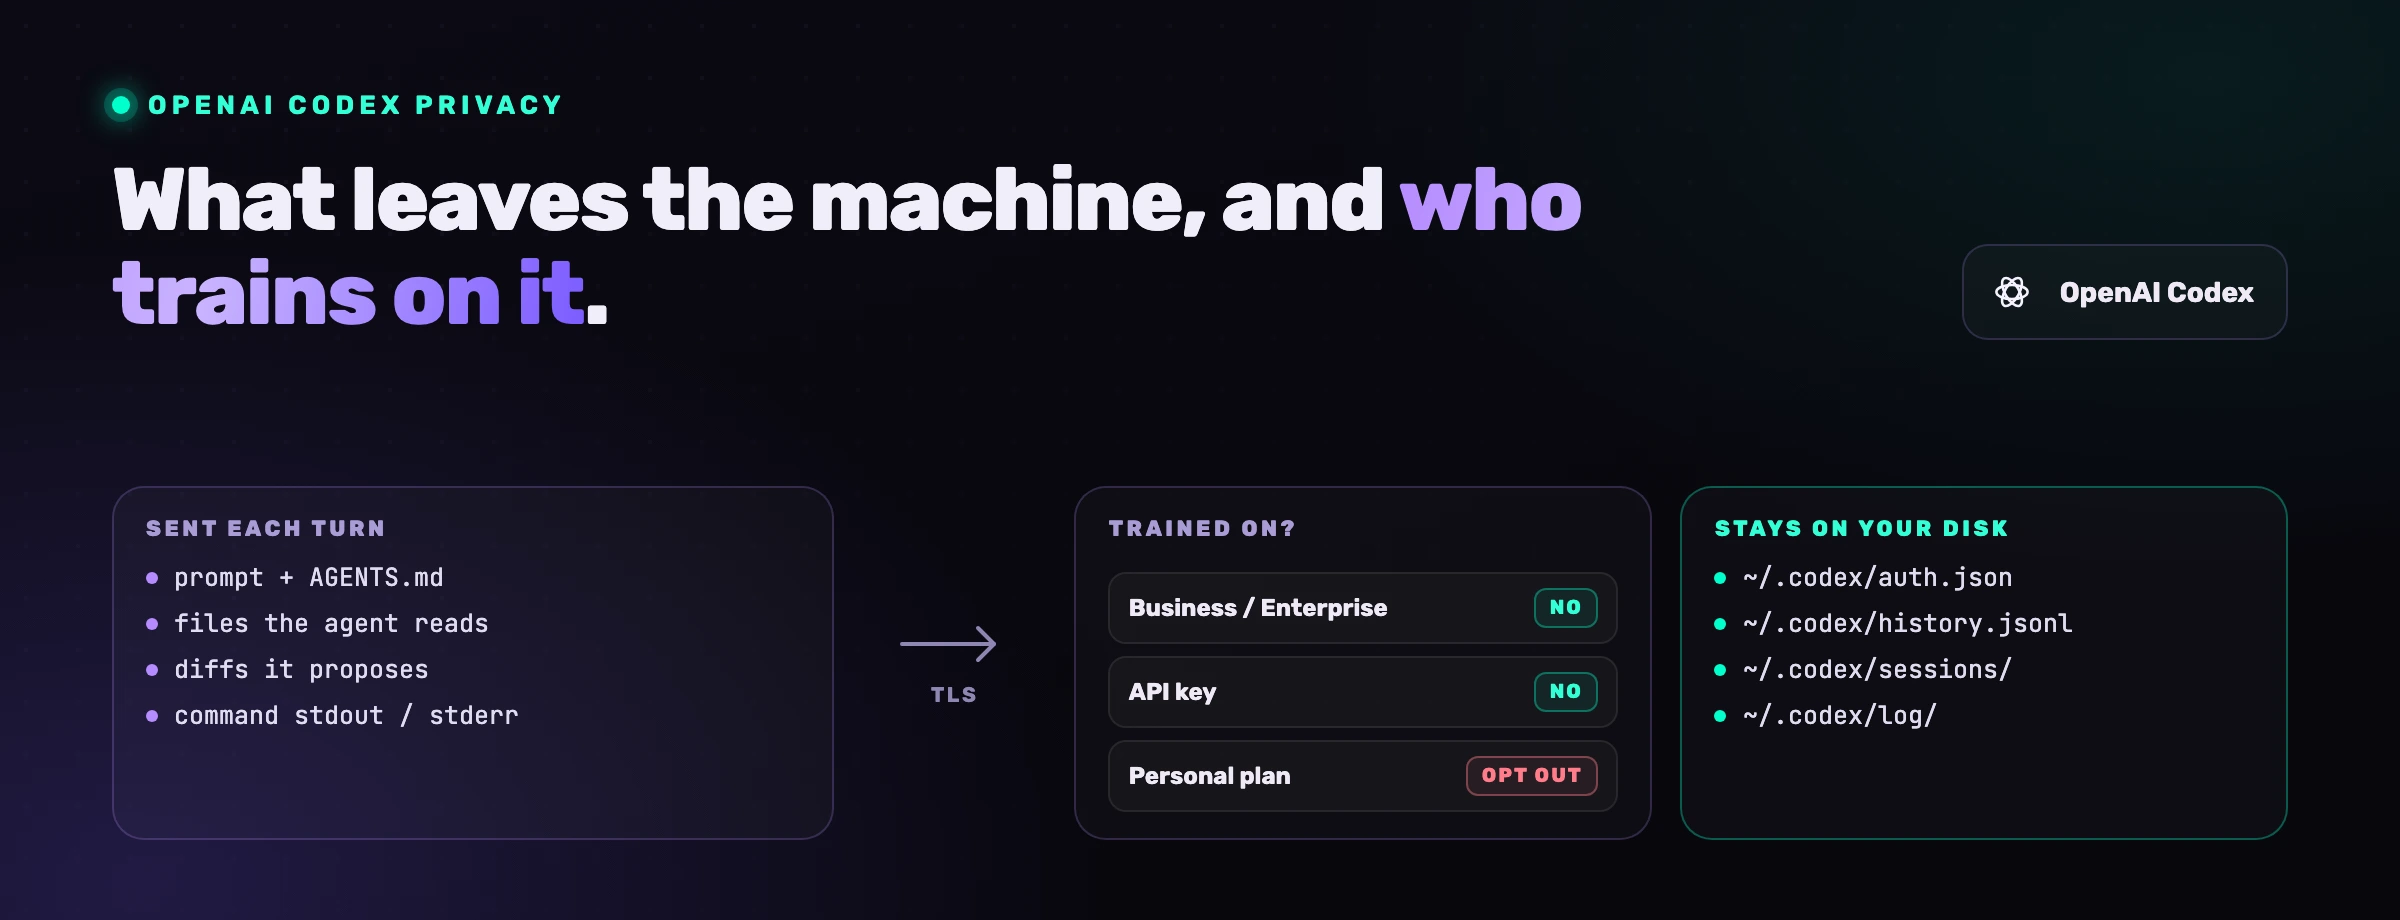
Oui, OpenAI Codex envoie votre code à OpenAI. Le prompt, les fichiers que l'agent décide d'ouvrir, les diffs qu'il propose, la sortie des commandes qu'il lance : tout cela part vers les modèles d'OpenAI, et il ne peut pas en être autrement, puisque c'est là que l'agent réfléchit. Une fois ce point acquis, les questions qui comptent sont plus étroites. Qu'est-ce qui sort exactement de la machine ? Qu'est-ce qui reste dans ~/.codex, sur votre disque ? OpenAI s'en sert-il pour l'entraînement (tout dépend du compte avec lequel vous êtes connecté) ? Qu'est-ce qui est conservé, et combien de temps ? Quels réglages tiennent les secrets et le code sensible hors de portée de l'agent ? Ce guide ne rend pas d'avis de conformité RGPD ; il réunit les faits dont votre DPO aura besoin pour le rendre, chacun avec le réglage qui le commande.
Quelles données Codex envoie-t-il à OpenAI ?
Codex envoie tout ce qu'il lui faut pour raisonner sur la tâche, et rien de ce qu'il n'a jamais ouvert. OpenAI le montre lui-même dans son article d'ingénierie sur la boucle d'agent de Codex : à chaque échange, la CLI adresse à l'API Responses le prompt que vous avez tapé, les fichiers d'instructions comme AGENTS.md, une courte description de l'environnement (répertoire de travail et shell) et la sortie de tous les appels d'outils passés jusque-là. C'est par ce dernier canal que voyagent le contenu des fichiers que l'agent a choisi de lire, les diffs qu'il propose, le stdout et le stderr des commandes exécutées, et ce que ces commandes affichent du dépôt (chemins, état git, arborescence). Avec Codex cloud, Codex crée un conteneur et y clone votre dépôt, chez OpenAI : tout ce qui figure dans ce clone entre dans le périmètre.
La réciproque est ce qui vous donne prise. Un fichier que l'agent n'a jamais lu n'est jamais envoyé, si bien que le vrai levier de confidentialité tient en un mot, la portée : ce que l'agent peut ouvrir, et ce qu'on lui a dit de ne pas toucher.
| Mode d'utilisation | Ce qui sort de la machine | Où tourne le modèle | Conditions applicables |
|---|---|---|---|
| CLI ou extension IDE, connexion par ChatGPT | Prompt, fichiers lus, diffs, sortie des commandes, métadonnées | Chez OpenAI, dans votre espace ChatGPT | Celles de votre abonnement ChatGPT (personnel, ou Business/Enterprise/Edu) |
| CLI ou SDK, avec une clé API | Les mêmes éléments, plus la télémétrie que vous auriez configurée | API d'OpenAI | Contrôles de données de l'API (pas d'entraînement par défaut) |
| Codex cloud | La tâche, et le dépôt entier, cloné depuis votre hébergeur Git dans le conteneur | Sandbox hébergée par OpenAI | Celles de votre abonnement ChatGPT |
codex exec local, en CI | Comme la CLI, sans personne devant l'écran | Chez OpenAI | Celles de l'identifiant confié au runner |
Deux passagers clandestins méritent d'être signalés, parce que personne ne les attend.
Le premier, ce sont les variables d'environnement. Le shell dans lequel l'agent lance ses commandes les voit toutes : un DATABASE_URL ou un AWS_SECRET_ACCESS_KEY exporté dans ce shell peut ressortir dans la sortie d'une commande, et partir avec elle. C'est la shell_environment_policy de Codex qui décide des variables transmises à ce shell, et elle ne retire rien tant que vous ne le lui demandez pas : d'après la référence de configuration d'OpenAI, les variables dont le nom contient KEY, SECRET ou TOKEN sont conservées par défaut.
Le second, ce sont les recherches web. Quand web_search vaut live (c'est ce que fait le flag --search), les requêtes que compose le modèle sortent elles aussi. Le mode par défaut, cached, s'en tient à un index maintenu par OpenAI, sans accès au web extérieur. La même référence signale toutefois qu'avec --yolo, ou tout autre réglage de sandbox en accès complet, ce défaut bascule sur live.
Votre code sert-il à entraîner les modèles d'OpenAI ?
Tout dépend du compte avec lequel vous êtes connecté, et pas du tout de la façon dont vous lancez Codex. La politique d'utilisation des données d'OpenAI traite Codex comme le reste de sa gamme, services aux particuliers d'un côté, services aux entreprises de l'autre, à un interrupteur près, propre à Codex.
| Votre façon d'utiliser Codex | Entraînement par défaut ? | Pour en changer |
|---|---|---|
| Espace ChatGPT Business, Enterprise ou Edu | Non, d'après la page de confidentialité entreprise d'OpenAI | Contrôles de l'administrateur de l'espace ; activation volontaire uniquement |
| Clé API (CLI ou SDK Codex) | Non. Les contrôles de données de l'API d'OpenAI l'écrivent ainsi : « Depuis le 1er mars 2023, les données envoyées à l'API d'OpenAI ne servent ni à entraîner ni à améliorer les modèles d'OpenAI (sauf si vous choisissez explicitement de partager vos données avec nous) » | Activation volontaire uniquement |
| Abonnement personnel (Free, Go, Plus, Pro) | Possible, tant que vous ne vous y êtes pas opposé | Paramètres de ChatGPT, « Contrôles des données », « Améliorer le modèle pour tous », ou le portail de confidentialité d'OpenAI ; l'un des deux suffit |
| Environnements complets de Codex (abonnements personnels) | Réglage à part | Paramètres de Codex, interrupteur d'entraînement sur les environnements complets |
C'est la dernière ligne qui piège. La FAQ d'OpenAI sur les contrôles de données précise deux choses : avec un abonnement personnel, le réglage « Améliorer le modèle pour tous » s'applique bien à vos tâches Codex, mais Codex dispose en plus d'un réglage distinct, géré dans ses propres paramètres, pour l'entraînement sur les environnements complets. Toucher à votre réglage ChatGPT ou passer par le portail de confidentialité n'y change rien.
Aucune de ces deux pages ne dit quelle est la valeur par défaut de ce réglage Codex. Un développeur abonné à Plus, qui a coupé « Améliorer le modèle pour tous » il y a des années (« Improve the model for everyone » si son interface est restée en anglais), n'a donc aucune raison de supposer que Codex a suivi. Vérifiez les deux.
Une exception survit au refus, et la politique d'utilisation des données citée plus haut l'écrit noir sur blanc : si vous envoyez un retour sur une réponse, un pouce levé ou baissé par exemple, toute la conversation qui s'y rattache peut servir à l'entraînement.
Que conserve Codex sur votre machine ?
Codex écrit sur votre disque plus qu'on ne le croit, et mieux vaut connaître ces fichiers par leur nom. Le guide de configuration avancée d'OpenAI recense ce qui se trouve sous ~/.codex :
config.toml, vos réglages ;auth.json, les identifiants mis en cache quand le stockage sur fichier est utilisé (sinon, ils vont dans le trousseau du système) ;history.jsonl, que le guide appelle les transcriptions de session, écrit par défaut ;log/, les journaux.
S'y ajoute sessions/, où Codex conserve chaque fil de travail sous la forme d'un fichier qu'il peut rejouer et reprendre.
Pour la confidentialité, ce sont history.jsonl et sessions/ qui pèsent. À eux deux, ils contiennent vos prompts, les réponses de l'agent et la sortie de ses commandes, donc chaque morceau de code et chaque secret qui y sont passés, et ils restent sur le disque tant que vous ne les supprimez pas.
Voici les clés de config.toml qui décident de ce qui reste en local et de ce qui est exporté :
# Ne plus écrire l'historique des sessions dans ~/.codex/history.jsonl
[history]
persistence = "none"

# Pas d'export OpenTelemetry des logs, et jamais les prompts bruts
[otel]
exporter = "none"
log_user_prompt = false

# Retirer les identifiants du shell dont se sert l'agent
[shell_environment_policy]
ignore_default_excludes = false  # retire aussi les noms contenant KEY, SECRET ou TOKEN

[shell_environment_policy.filters]
"AWS_*" = "exclude"
"DATABASE_URL" = "exclude"

# Statistiques d'usage au niveau de la machine
[analytics]
enabled = false
Trois précisions tirées de la documentation d'OpenAI vont avec ce bloc. history.persistence = "none" arrête history.jsonl, et rien d'autre : les fichiers de sessions/ relèvent d'un mécanisme à part, la référence de configuration ne documente aucune clé pour eux, et le seul moyen documenté de s'en passer est codex exec --ephemeral, qui s'exécute sans les écrire. La table filters est la forme actuelle de shell_environment_policy ; l'ancien tableau exclude fonctionne encore, mais la référence le classe désormais parmi les formes héritées, et Codex refuse un mélange des deux. Enfin, l'export OpenTelemetry des logs est désactivé par défaut : rien ne s'exporte tant que vous n'avez rien configuré, et otel.log_user_prompt est une activation explicite, qui ajoute les prompts bruts à cet export.
Restent deux canaux, actifs par défaut l'un et l'autre : les statistiques anonymes d'usage et de santé, dont OpenAI affirme qu'elles ne contiennent aucune donnée permettant de vous identifier et que analytics.enabled = false coupe, et la commande /feedback (feedback.enabled).
Retenez surtout qu'aucun de ces réglages ne modifie ce que reçoit le modèle. Ils décident de ce que votre machine écrit, et de ce qu'elle fait suivre.
Codex peut-il « voler » votre code ?
Non, et la question mérite mieux qu'une réponse rassurante. Codex transmet votre code à OpenAI dans le cadre des conditions attachées à votre compte, et ces conditions sont publiques : c'est un flux de données que vous avez accepté, pas un vol.
Les deux affaires qui ont nourri cette crainte ne montrent d'ailleurs pas Codex en train de s'emparer de quoi que ce soit. La première concerne codexui-android, une vraie interface web distante pour Codex, publiée sur npm, activement développée et téléchargée quelques milliers de fois par semaine. Comme The Hacker News l'a rapporté le 1er juin 2026, ses versions publiées lisaient ~/.codex/auth.json à chaque lancement et l'envoyaient au serveur d'un attaquant depuis un mois environ, avec un code qui n'a jamais figuré dans le dépôt GitHub. Dans la seconde, BeyondTrust Phantom Labs a révélé, en mars 2026, une faille d'injection de commandes dans l'environnement cloud de Codex, relayée par The Hacker News : un nom de branche piégé suffisait à voler le token GitHub dont Codex se sert, et BeyondTrust cite parmi les surfaces touchées le site de ChatGPT, la CLI Codex, le SDK et l'extension IDE. OpenAI l'a corrigée depuis.
Même scénario les deux fois : ce qui a été volé, ce sont les identifiants qui entourent Codex, et le voleur était un tiers. C'est donc là qu'il faut regarder. Le guide d'authentification d'OpenAI demande de traiter ~/.codex/auth.json comme un mot de passe, et cli_auth_credentials_store = "keyring" déplace les tokens dans le trousseau du système : le fichier n'est alors plus là pour être lu. Vérifiez ce que vous installez, en sachant qu'un dépôt propre ne prouve rien sur le paquet que le registre sert réellement, et accueillez tout module complémentaire pour Codex avec la méfiance que vous auriez pour une extension de navigateur qui réclame votre mot de passe.
Il existe une troisième façon de perdre du code, celle qui ne donne lieu à aucun rapport d'incident. Vous clonez un dépôt, il contient une prompt injection qui demande à l'agent d'expédier vos fichiers ailleurs à coups de curl, et la session avait le réseau ouvert. C'est exactement pour cela que la sandbox workspace-write de Codex garde le réseau fermé par défaut, ce que le guide d'OpenAI sur la sandbox et les approbations énonce sans détour : par défaut, l'agent s'exécute avec l'accès réseau coupé. Notre guide des flags de sandbox et d'approbation de Codex détaille ceux qui l'ouvrent, et les cas où c'est acceptable.
Comment tenir les secrets et le code sensible hors de portée de Codex ?
Réduisez ce que l'agent peut ouvrir, et faites en sorte que ce qu'il ouvre ne vaille rien. Par ordre d'efficacité :
- Aucun secret dans un fichier que l'agent peut lire. Un
.envavec des clés actives, unconfig/production.ymlqui contient le mot de passe de la base, uncredentials.jsonoublié dans l'arborescence : dès lors que le fichier est dans l'espace de travail, l'agent peut le lire, et son contenu peut finir dans l'historique d'une session. Passez par un gestionnaire de secrets, avec injection à l'exécution. - Nettoyez le shell. Donnez à
shell_environment_policyla valeurignore_default_excludes = falseet des entréesfiltersréglées surexcludepour les clés, les tokens et les chaînes de connexion : la sortie d'une commande ne pourra plus les laisser fuiter. - Laissez le réseau fermé.
sandbox_workspace_write.network_accessreste àfalse. Le jour où une tâche a vraiment besoin du registre, ouvrez-le pour cette seule exécution avec-c. - Déclarez non fiables les dépôts que vous ne connaissez pas. Avec
projects."<chemin>".trust_level = "untrusted", la référence de configuration d'OpenAI indique que Codex ignore les couches.codex/embarquées dans le dépôt, configuration locale, hooks et règles compris : un projet cloné ne peut plus reconfigurer l'agent contre vous. - Pas d'historique local sur une machine partagée ou soumise à des obligations réglementaires.
history.persistence = "none", et un nettoyage planifié de~/.codex/sessions/, que cette clé ne couvre pas. En CI, lancezcodex exec --ephemeral. - Choisissez le compte en fonction des données. Code sous NDA, base de code réglementée, fixtures qui contiennent des données clients : utilisez un espace Business ou Enterprise, ou une clé API. Pour les usages API soumis à des obligations plus strictes, les contrôles de données de l'API d'OpenAI documentent trois choses. Les journaux de surveillance des abus sont conservés « jusqu'à 30 jours » par défaut, davantage si la loi l'exige. L'option Zero Data Retention exclut le contenu client de ces journaux sur les endpoints éligibles, dont
/v1/responses, et OpenAI l'accorde sur approbation préalable, pas sur simple demande. La résidence des données est elle aussi soumise à éligibilité : sa région Europe (EEE et Suisse) exige Zero Data Retention ou un autre des contrôles de rétention réduite d'OpenAI, et elle ne couvre pas les données système, métadonnées de compte et d'usage par exemple. - Cherchez les secrets avant que l'agent ne tombe dessus. Une clé committée qu'un scanner signale aujourd'hui, c'est une clé que la prochaine session ne chargera pas dans son contexte.
Ce que les réglages de confidentialité ne couvrent pas
Tous les contrôles qui précèdent portent sur ce que Codex lit et transmet. Aucun ne porte sur ce que Codex écrit, et ce code-là pose ses propres questions de confidentialité.
Prenez un agent qui code en dur un token aperçu dans une fixture, qui journalise le corps entier d'une requête avec un numéro de carte dedans, ou qui renvoie une fiche utilisateur avec des champs que l'appelant n'avait pas le droit de voir. Il vient de créer un problème de protection des données qu'aucune politique de conservation ne réglera, puisque la fuite se trouve désormais dans votre dépôt et dans vos logs de production.
C'est la couche agent-time que VibeDefend ajoute. Placée dans la boucle de Codex, elle confronte à vos règles le diff que l'agent s'apprête à écrire : le secret codé en dur, la ligne de log trop bavarde, le contrôle d'autorisation oublié sont réécrits avant d'arriver dans le dépôt. Son garde-fou tranche en local, sur votre machine, sa télémétrie se réduit à des métadonnées structurées, et son analyse tourne sur des modèles auto-hébergés, dans la région UE ou US que vous choisissez à l'installation, sans API LLM tierce et sans que votre code serve à entraîner un modèle. Dans notre étude contrôlée, l'agent équipé de cette couche a appliqué la règle exacte dans 89 % des cas (57 règles notées sur 64), contre 12 % sans outil et 13 % avec un fichier de règles tenu à la main dans le dépôt.
Pour le tableau d'ensemble, sandbox, supply chain et risques liés à l'autonomie compris, lisez notre guide complet de la sécurité d'OpenAI Codex. Et si votre équipe adopte Codex sur du code qui ne doit pas sortir des murs, parlons-en : cette configuration, nous l'avons déjà mise en place bien des fois.
Questions fréquentes
Le code que je confie à Codex part-il chez OpenAI ?
Oui. Chaque échange envoie aux modèles d'OpenAI le prompt, les fichiers lus par l'agent, les diffs proposés, la sortie des commandes et des métadonnées du dépôt ; avec Codex cloud, c'est le dépôt entier qui est cloné dans un conteneur hébergé par OpenAI. Un fichier que l'agent n'ouvre jamais n'est jamais envoyé : limiter sa portée reste donc le premier levier de confidentialité.
Codex en entreprise : notre code sert-il à entraîner les modèles d'OpenAI ?
Pas par défaut si vous passez par un espace ChatGPT Business, Enterprise ou Edu, ou par une clé API. Avec un abonnement personnel, il peut servir tant que vous ne vous y êtes pas opposé : c'est le réglage ChatGPT « Améliorer le modèle pour tous » qui s'applique à Codex, et Codex possède dans ses propres paramètres un interrupteur distinct, pour l'entraînement sur les environnements complets, qu'il faut vérifier lui aussi.
Comment désactiver l'entraînement sur mon code dans Codex ?
Avec un abonnement personnel, en deux gestes. D'abord, désactivez « Améliorer le modèle pour tous » dans les « Contrôles des données » de ChatGPT, ou passez par le portail de confidentialité d'OpenAI. Ensuite, ouvrez les paramètres de Codex et coupez le réglage d'entraînement sur les environnements complets, car le premier geste ne change rien au second. L'autre voie consiste à vous connecter par un espace Business ou Enterprise, ou par une clé API, où l'entraînement est désactivé par défaut.
Codex garde-t-il une copie de mes sessions sur mon ordinateur ?
Oui, par défaut. L'historique des sessions s'écrit dans ~/.codex/history.jsonl, à côté des identifiants dans ~/.codex/auth.json (sauf si vous utilisez le trousseau du système), d'un fichier rejouable par session dans ~/.codex/sessions/ et des logs dans ~/.codex/log/. Poser history.persistence = "none" dans config.toml n'arrête que history.jsonl : les fichiers de session demandent leur propre nettoyage, ou codex exec --ephemeral pour les exécutions scriptées.
Codex peut-il lire mon fichier .env ?
Oui, dès lors que le fichier se trouve dans l'espace de travail et que le mode de sandbox autorise la lecture. Or read-only et workspace-write l'autorisent tous les deux : seules les écritures sont confinées. Tenez les secrets actifs hors de l'arborescence, et servez-vous de shell_environment_policy pour les retirer du shell où l'agent lance ses commandes.
Codex et RGPD : les données peuvent-elles rester en Europe ?
Pour les usages API, OpenAI documente des régions de résidence des données qui incluent l'Europe (EEE et Suisse), ainsi qu'une option Zero Data Retention sur les endpoints éligibles et, par défaut, une conservation allant jusqu'à 30 jours pour la surveillance des abus. Les deux options sont soumises à éligibilité et à l'approbation d'OpenAI, la région Europe exige un contrôle de rétention réduite comme Zero Data Retention, et la résidence ne couvre pas les données système. Pour un espace ChatGPT, le lieu de traitement dépend du contrat attaché à votre espace : faites-le confirmer par OpenAI avant d'y faire passer un traitement réglementé.
Peut-on utiliser Codex en entreprise sur du code propriétaire ?
Oui, à condition de choisir le bon compte et la bonne configuration : un accès sans entraînement (Business, Enterprise ou clé API), des secrets tenus hors de l'espace de travail, le réseau laissé fermé, les dépôts inconnus déclarés non fiables, et pas d'historique local quand la machine est partagée. Reste le code que l'agent écrit, qui demande sa propre couche de relecture.


