

Nesta página
- O código gerado por IA é seguro?
- Por que razão é que tanto código gerado por IA é inseguro?
- Que tipos de vulnerabilidades introduz o código de IA?
- O que escapa aos scanners, e aos próprios modelos?
- Podes confiar numa IA para corrigir as suas próprias vulnerabilidades?
- Como é que tornas o código gerado por IA seguro?
- Perguntas frequentes
- O código gerado por IA é seguro?
- É seguro colocar código gerado por IA em produção?
- Por que razão é que o código gerado por IA é inseguro, se o modelo é tão capaz?
- Posso simplesmente pedir à IA que verifique o seu próprio código?
- Quais são as vulnerabilidades mais comuns no código gerado por IA?
- Como é que torno o código gerado por IA seguro?
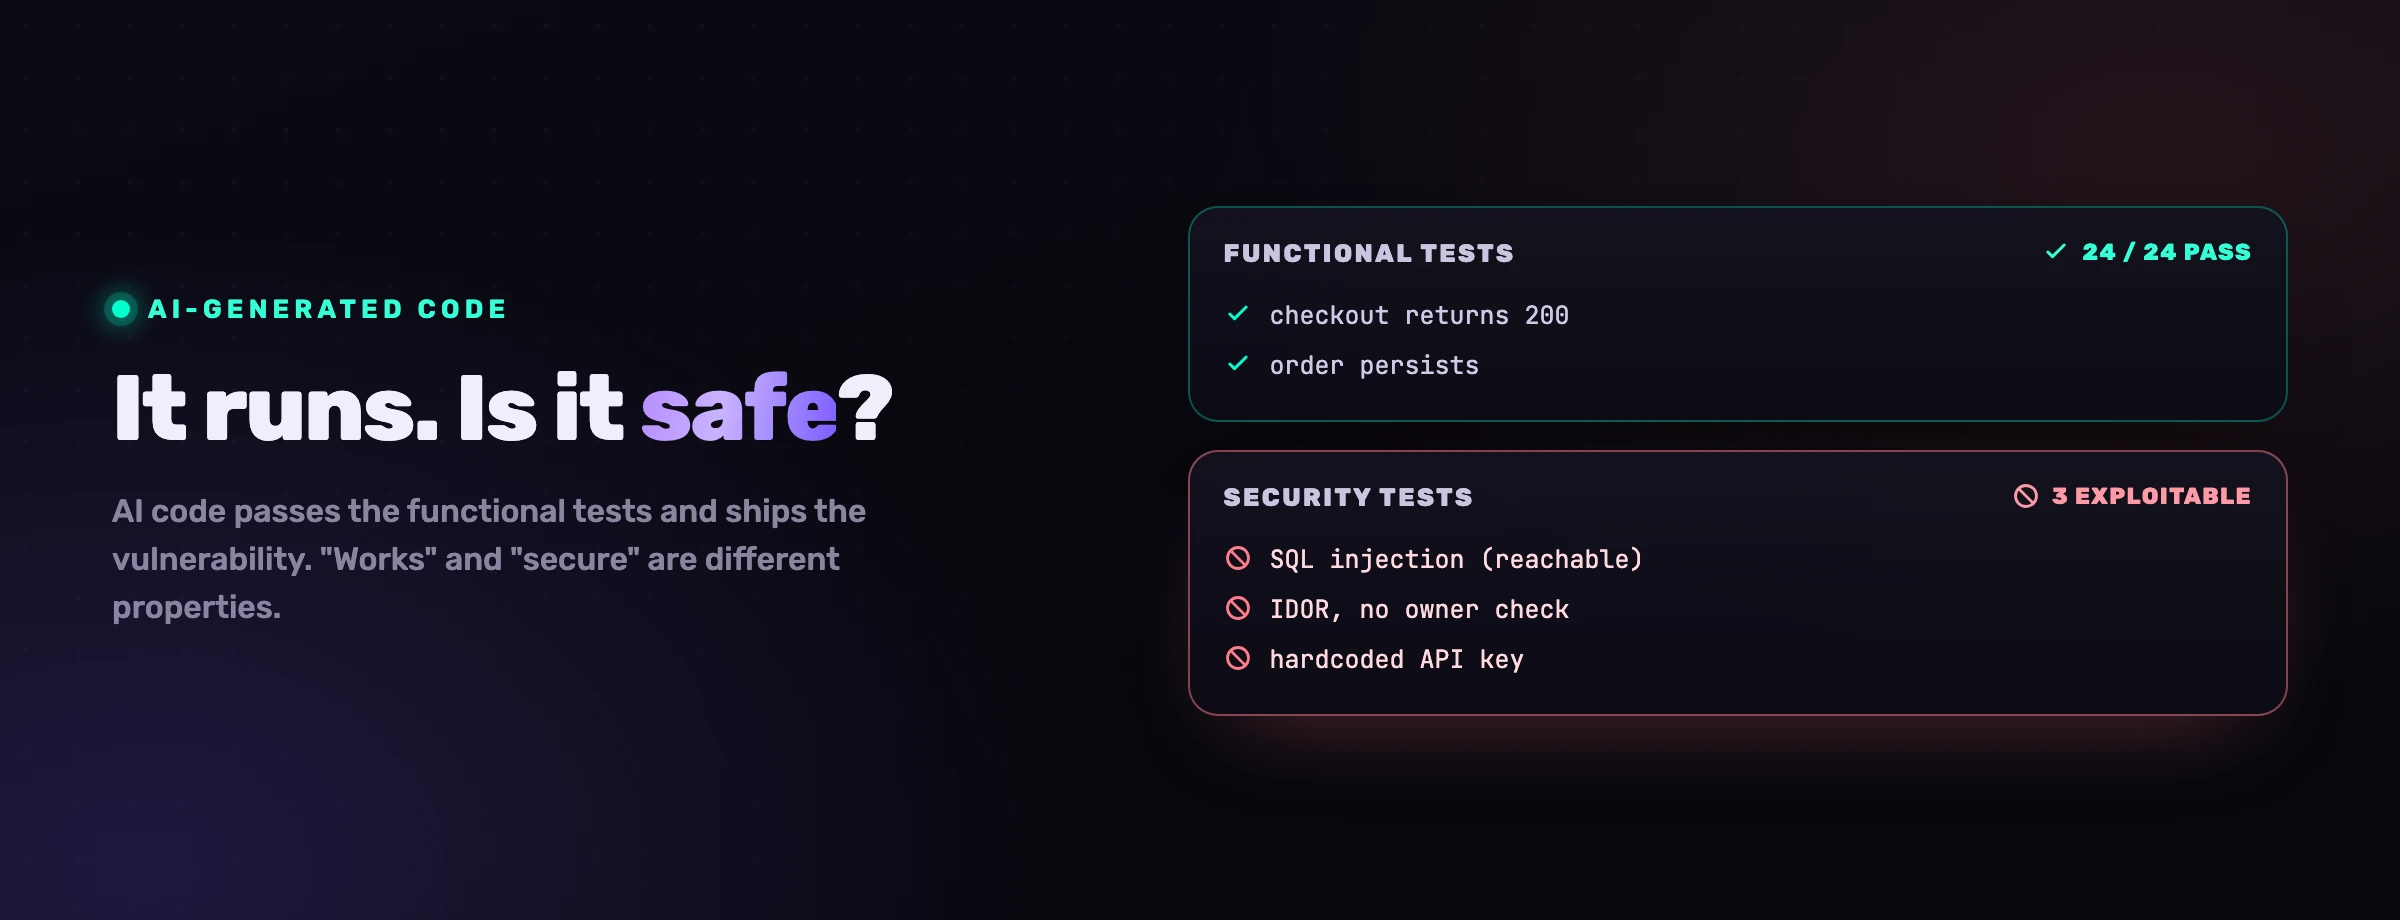
É seguro? A resposta é mensurável, o que neste tema é raro. O código gerado por IA corre, passa na demonstração e parece código de alguém competente. É aí que mora o problema: "funciona" e "é seguro" são propriedades diferentes, e um agente otimiza com toda a força a primeira enquanto um prompt de "faz isto funcionar" nunca chega a pedir a segunda. Cada número aqui vem de uma fonte que podes abrir, com data e método ao lado, porque a resposta honesta é uma medição, não uma opinião. Fica a resposta direta, as medições de 2021 a 2026, as classes que escapam aos scanners e aos próprios modelos, e o que muda para o poderes entregar.
O código gerado por IA é seguro?
Não, não por omissão. O código gerado por IA é tão seguro quanto os controlos à volta dele, e a maioria das montagens não tem controlo nenhum antes de o código aterrar. Os benchmarks independentes concordam na forma da falha: o código corre, passa nos testes e leva uma vulnerabilidade na mesma. A segurança é uma propriedade da tua pipeline, não do modelo.
A medição mais antiga continua a ser a mais clara. Em Asleep at the Keyboard, submetido em agosto de 2021 por uma equipa da New York University com um co-autor na University of Calgary, os investigadores puseram o GitHub Copilot a completar 89 cenários do Top 25 de fraquezas da MITRE e recolheram 1 689 programas. A conclusão, nas palavras deles: «Of these, we found approximately 40% to be vulnerable.» O número tem cinco anos e fala de um único assistente, por isso trata-o como linha de base e não como o veredito de hoje.
O veredito de hoje vem do SusVibes, um benchmark do Language Technologies Institute da Carnegie Mellon com a Columbia, a Johns Hopkins e a HydroX AI, aceite na ICML 2026 e revisto a 21 de agosto de 2026. Parte de 186 pedidos de funcionalidade reais, tirados de projetos open source onde a própria implementação humana era vulnerável, cobre 79 categorias CWE e põe 12 configurações de agente a resolvê-los. A melhor, o SWE-Agent com o Claude 4 Sonnet, ficou funcionalmente correta em 57% das tarefas e segura em 11,8%. E acrescenta a linha que te devia tirar o sono: 79,3% das soluções funcionalmente corretas levam uma vulnerabilidade.
das soluções do melhor agente eram seguras, face a 57% funcionalmente corretas (SusVibes, 186 pedidos de funcionalidade reais, revisto em agosto de 2026)
das soluções funcionalmente corretas desse mesmo agente levavam, ainda assim, uma vulnerabilidade (mesmo benchmark)
das aplicações testadas pela OWASP apresentavam alguma forma de controlo de acesso quebrado, o seu risco número um para 2025
A escala é o que transforma uma taxa por tarefa num problema de negócio. No relatório DORA de 2025 sobre desenvolvimento assistido por IA, publicado a 23 de setembro de 2025, «90% of survey respondents report using AI at work» e «30% report little or no trust in the code generated by AI». O mesmo relatório regista que «AI adoption does continue to have a negative relationship with software delivery stability». Nove em cada dez já entregam código escrito com IA, três em cada dez não confiam nele, e é na estabilidade da entrega que a tensão aparece. Nota, para o equívoco fácil por cá: este DORA é o DevOps Research and Assessment da Google Cloud, não o regulamento europeu homónimo.
Por que razão é que tanto código gerado por IA é inseguro?
Porque um modelo consegue ter o princípio de segurança na cabeça e falhar em aplicá-lo na linha onde ele conta. Uma sistematização de junho de 2026 da University at Buffalo deu nome a isto, a lacuna entre conhecimento e atuação, e mediu-a: os modelos pontuam muito mais alto a saber a regra do que a escrever código que sobrevive ao exploit. Saber não é fazer.
Esse trabalho, o SoK: AI Secure Code Generation, põe números na distância. «The benchmark-level gap is 47.9 points for CWEval and 72.9 points for BaxBench», e a lacuna alarga-se à medida que a tarefa se aproxima do mundo real: o CWEval avalia ao nível da função, o BaxBench pede aplicações web inteiras, onde a guarda tem de aterrar no middleware certo, na rota certa, no ficheiro certo. A décima terceira conclusão do artigo é a frase a reter: a lacuna é um problema de entrega, os modelos têm o conhecimento de segurança certo e falham em aplicá-lo na fronteira de implementação correta. O que resulta é ligar um princípio conhecido ao sítio certo do código, não ensinar mais segurança ao modelo.
Duas forças mais antigas agravam o quadro. O corpus: o modelo aprendeu com código público cheio de SQL concatenado, autorização em falta, criptografia fraca e segredos escritos à mão no ficheiro, por isso inseguro por omissão é o seu prior estatístico. E a ausência: a segurança é quase sempre uma guarda que está presente, e um modelo a quem se pede um resultado positivo ("acrescenta um endpoint de checkout") não acrescenta a guarda negativa que ninguém pediu. A funcionalidade funciona precisamente porque a verificação que falta não toca no caminho feliz.
Depois há o leitor, e é o fator decisivo. Quem escreve o prompt consegue dizer se a funcionalidade funciona, raramente se é segura. Essa distância, entre a intenção de quem escreve e a capacidade de quem revê, é todo o problema de segurança, e alarga-se quando alguém sem especialidade faz vibe coding a partir de um parágrafo de intenção. Aprofundamos isto em segurança do vibe coding.
Que tipos de vulnerabilidades introduz o código de IA?
As mesmas que os humanos introduzem, reproduzidas mais depressa do que a revisão consegue acompanhar. Injeção, autorização quebrada, segredos embutidos, validação de input em falta, desserialização insegura e erros de lógica de negócio. Quase todas estão no CWE Top 25 de 2025, e o ponto é esse: não são falhas exóticas de modelo, são as fraquezas mais antigas da indústria.
- Injeção (CWE-89, CWE-78). SQL e comandos de shell concatenados a partir de input do utilizador, aprendidos de um corpus cheio deles. A injeção de SQL é a segunda e a injeção de comandos do sistema operativo a nona no CWE Top 25 de 2025. Vê por que razão a maioria das descobertas de SAST é ruído para perceber porque é que só as alcançáveis contam.
- Autorização quebrada e IDOR (CWE-862, CWE-639). O agente constrói o endpoint que devolve o registo, raramente a verificação de que quem chama é o dono. A autorização em falta é a quarta da mesma lista, e a OWASP põe a categoria-mãe à frente de tudo: sobre a A01:2025 Broken Access Control escreve que está «maintaining its position at #1 in the Top Ten» e que «100% of the applications tested» apresentavam alguma forma dela.
- Segredos embutidos no código (CWE-798). Pede-lhe uma integração que funcione e ele embute uma chave de API ou uma palavra-passe para o código correr à primeira, e ela passa a viver no repositório e em cada fork. Esta classe não consta do CWE Top 25 de 2025, por isso não é nesse ranking que a vais encontrar.
- Validação de input em falta (CWE-20). Os endpoints gerados confiam nos seus inputs, o facilitador silencioso da injeção e da desserialização a jusante. É a décima oitava da lista de 2025.
- Desserialização insegura (CWE-502). "Carrega o objeto guardado" torna-se
pickleouyaml.loadsobre bytes não confiáveis, e transforma um blob armazenado em execução remota de código. É a décima quinta de 2025. - Falhas de lógica de negócio. A classe mais perigosa, porque nenhum scanner está talhado para a apanhar: um carrinho com quantidade negativa, um cupão que se acumula, um reembolso que salta a verificação de propriedade. Sintaticamente perfeito, semanticamente errado, e fora de qualquer ranking CWE porque é específico do teu domínio. Este é o nosso aprofundamento sobre falhas de lógica de negócio no código gerado por IA.
O que escapa aos scanners, e aos próprios modelos?
Duas coisas. A lógica de negócio, que não oferece sink perigoso a que casar um padrão, e os pontos cegos do modelo, que ele não consegue auditar enquanto continuarem lá. O SusVibes mediu o segundo diretamente: acrescentar pistas de vulnerabilidade ao pedido de funcionalidade não mitigou os problemas de segurança, logo insistir no prompt não é a correção.
O primeiro ponto cego é a lógica de negócio. Um analisador estático raciocina sobre padrões de código; uma regra de negócio ("só o dono pode editar este documento", "a quantidade tem de ser positiva") vive fora do código, no teu domínio. Não há input contaminado nem sink perigoso a que corresponder, há apenas um if que nunca foi escrito, e o scanner reporta o ficheiro como limpo enquanto ele é totalmente explorável.
O segundo é o modelo a corrigir os seus próprios trabalhos de casa. Pedir ao agente que escreveu o código que o reveja herda os mesmos pontos cegos: não conhece o teu modelo de autorização, não vê as outras descobertas à volta da linha, e está tão confiante na versão insegura como na segura. É outra vez a lacuna entre conhecimento e atuação, vista do lado da revisão. Uma verificação em que possas confiar precisa de sinal de fora: análise consciente da alcançabilidade que segue o fluxo de dados real, e as tuas regras carregadas como verdade de base.
A questão não é se a IA escreve código inseguro, todos os autores o fazem. É se alguma coisa apanha a linha insegura antes de ela ser entregue, e à velocidade da IA o único sítio que resta para a apanhar é onde a linha é escrita.
Podes confiar numa IA para corrigir as suas próprias vulnerabilidades?
Podes confiar num agente para aplicar uma correção muito mais do que para decidir o que é uma vulnerabilidade real e alcançável. Ele reescreve bem uma linha assim que sabe o que mudar, e julga mal a explorabilidade, que é precisamente o que um scanner já calculou. Por isso dá-lhe descobertas confirmadas e ordenadas por alcançabilidade mais as tuas regras, deixa-o corrigir, e aprova cada diff.
Cobrimos esse ciclo em remediação de vulnerabilidades com IA e em encontrar e corrigir vulnerabilidades automaticamente.
O que não funciona é escrever as regras num ficheiro e ficar à espera. A documentação da Anthropic sobre a memória diz que o Claude trata o CLAUDE.md como contexto, não como configuração imposta, sem garantia de cumprimento estrito. Um ficheiro lido uma vez no início da sessão fica muito para trás quando o agente escreve a linha que conta. A regra tem de chegar no momento da edição, e a alteração tem de ser verificada contra ela antes do commit. Mesmo assim, uma regra servida informa o agente sem o obrigar, e é por isso que a verificação existe.
Como é que tornas o código gerado por IA seguro?
Mudando o controlo para o momento em que o código é escrito, e mantendo a análise e a revisão humana atrás dele. Três movimentos, por ordem de alavancagem: governar o que o agente escreve antes de ele escrever, devolver-lhe as descobertas confirmadas dos scanners, e guardar um gate no CI mais um humano a aprovar diffs.
- Governar no momento da geração. Carrega as tuas regras de segurança e de negócio no agente antes de cada edição, para que o padrão seguro seja o que ele usa por omissão. A vulnerabilidade que nunca é escrita não precisa de triagem. É esta a ideia central de segurança de agentes de código de IA.
- Analisar continuamente e devolver as descobertas ao agente. Mantém SAST consciente da alcançabilidade, SCA, segredos, IaC e CI/CD a correr, e põe as descobertas confirmadas nas mãos do agente para ele remediar as reais no ciclo.
- Manter o CI e a revisão humana como rede de segurança. Um gate de SAST em cada pull request e um humano a aprovar diffs apanham o que escapa. Necessários, mas à velocidade da IA não podem ser a única linha.
A versão prática está em como acrescentar segurança ao teu fluxo de trabalho com IA e em como proteger uma aplicação inteira em cinco minutos.
O VibeDefend é a camada que faz os dois primeiros. É uma CLI npm gratuita que se instala com um só comando e liga o Claude Code, o Cursor, o Devin Desktop, o OpenAI Codex e o VS Code Copilot a quatro camadas de governação dentro do ciclo do agente.
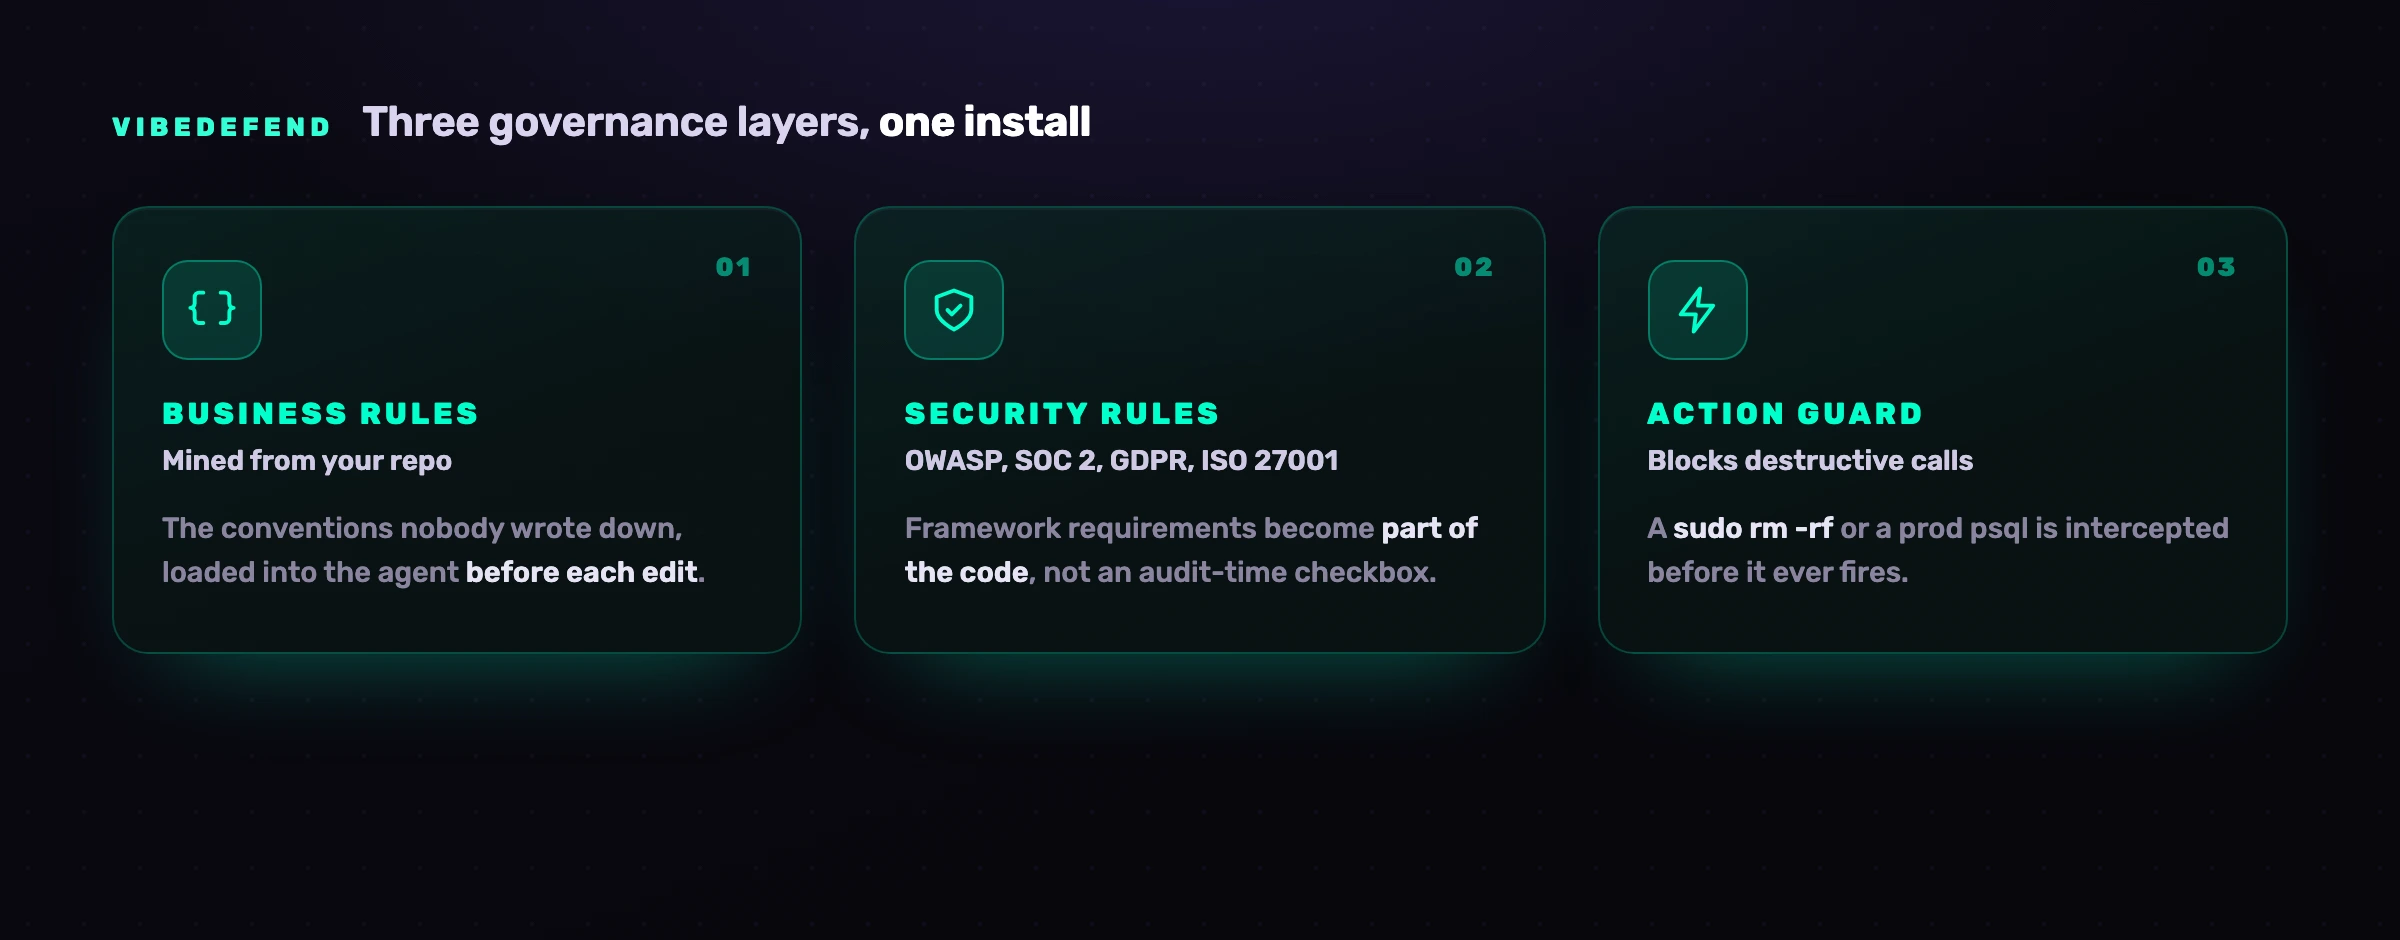
Três camadas governam o que o agente escreve: as Business Rules extraídas do teu repositório, as Security Rules das famílias OWASP, SOC 2, RGPD e ISO 27001, e um Action Guard que bloqueia chamadas destrutivas no Claude Code, no Cursor e no Codex. A quarta, as Live Findings, liga o agente à plataforma de análise da CybeDefend, com SAST, SCA, segredos, IaC e CI/CD a correr continuamente e cada descoberta ao vivo no seu contexto, de modo que não só escreve código mais seguro como corrige as vulnerabilidades que já lá tens. O Action Guard decide no teu portátil; para servir as regras, o VibeDefend envia um excerto curto do código que está a ser escrito, e a análise feita antes do commit envia os ficheiros alterados, ambos para a região da UE ou dos EUA que escolhes na instalação (as duas são fisicamente separadas), e o teu código nunca é usado para treinar um modelo.
Perguntas frequentes
Respostas curtas, assentes nas fontes ligadas acima: o estudo da New York University sobre o Copilot, de 2021, o SusVibes revisto em agosto de 2026, a sistematização da University at Buffalo de junho de 2026 e o OWASP Top 10:2025.
O código gerado por IA é seguro?
Não por omissão. Corre e passa no caminho feliz, mas os testes independentes encontram repetidamente uma grande parte dele insegura: cerca de 40% das sugestões do GitHub Copilot eram vulneráveis no estudo "Asleep at the Keyboard" da New York University, de 2021, e no SusVibes revisto em agosto de 2026 a melhor configuração de agente esteve funcionalmente correta em 57% dos pedidos e apenas 11,8% das suas soluções eram seguras. Torna-se seguro com um controlo que age onde o código é escrito, e revisão humana e análise no CI por trás.
É seguro colocar código gerado por IA em produção?
Só depois de revisto e analisado como qualquer código, e de preferência depois de governado enquanto era escrito. É arriscado entregar a partir do "funciona": as falhas (autorização em falta, injeção, segredos embutidos, erros de lógica de negócio) não tocam no caminho feliz e sobrevivem a um teste funcional. O SusVibes mediu essa distância: 79,3% das soluções funcionalmente corretas do melhor agente levavam na mesma uma vulnerabilidade. Fecha-o com SAST consciente da alcançabilidade no CI, revisão humana dos caminhos sensíveis, e um controlo no momento do prompt.
Por que razão é que o código gerado por IA é inseguro, se o modelo é tão capaz?
Porque produzir código que funciona não é o mesmo que produzir código seguro. A sistematização da University at Buffalo de junho de 2026 chama a isto a lacuna entre conhecimento e atuação, e mediu-a em 47,9 pontos no CWEval e 72,9 pontos no BaxBench: o modelo sabe o princípio e falha em aplicá-lo na fronteira de implementação certa. Junta-lhe o corpus (código público cheio de padrões inseguros), a ausência (uma guarda que ninguém pediu) e o leitor (quem escreve o prompt raramente avalia se o resultado é seguro). Nada disto se resolve com um modelo mais inteligente.
Posso simplesmente pedir à IA que verifique o seu próprio código?
Ajuda um pouco e não chega. O modelo que escreveu o código partilha os seus pontos cegos: não conhece o teu modelo de autorização nem a fronteira entre tenants, não vê as outras descobertas à volta da linha, e está igualmente confiante nas duas versões. O SusVibes testou o atalho óbvio: acrescentar pistas de vulnerabilidade ao pedido de funcionalidade não mitigou os problemas de segurança. Uma verificação fiável precisa de sinal de fora, análise da alcançabilidade e as tuas regras como verdade de base.
Quais são as vulnerabilidades mais comuns no código gerado por IA?
Injeção (CWE-89, CWE-78), autorização quebrada e IDOR (CWE-862, CWE-639), segredos embutidos no código (CWE-798), validação de input em falta (CWE-20), desserialização insegura (CWE-502) e falhas de lógica de negócio. Quatro destas seis classes estão no CWE Top 25 de 2025, e a OWASP põe o controlo de acesso quebrado em primeiro lugar para 2025, reportando 100% das aplicações que testou com alguma forma dele. As primeiras cinco são detetáveis por bons scanners quando filtras por alcançabilidade; a última é a perigosa, porque nenhum scanner apanha uma regra sintaticamente perfeita e semanticamente errada.
Como é que torno o código gerado por IA seguro?
Muda o controlo para o momento da geração: carrega as tuas regras de segurança e de negócio no agente para ele escrever primeiro o padrão seguro, analisa continuamente e devolve-lhe as descobertas confirmadas, e mantém um gate de SAST no CI mais revisão humana como rede de segurança. Escrever as regras num ficheiro não chega: a Anthropic diz que o Claude o trata como contexto, não como configuração imposta.