

Nesta página
- O que é uma falha de lógica de negócio?
- Porque é que o SAST não consegue encontrar falhas de lógica de negócio?
- Porque é que os agentes de código de IA produzem mais falhas destas?
- Que aspeto têm as falhas de lógica de negócio no código de IA?
- Como apanhar as falhas de lógica de negócio no agent-time?
- Em que é que isto difere do SAST e do SCA?
- Perguntas frequentes
- O que é, em termos simples, uma falha de lógica de negócio?
- Porque é que o SAST e o SCA não conseguem apanhar vulnerabilidades de lógica de negócio?
- Porque é que os agentes de código de IA produzem mais falhas de lógica de negócio?
- Quais são as falhas de lógica de negócio mais comuns no código gerado por IA?
- Como prevenir as falhas de lógica de negócio em vez de apenas as detetar?
- Isto substitui o meu scanner SAST e SCA?
- Como é que o VibeDefend conhece as minhas regras de negócio?
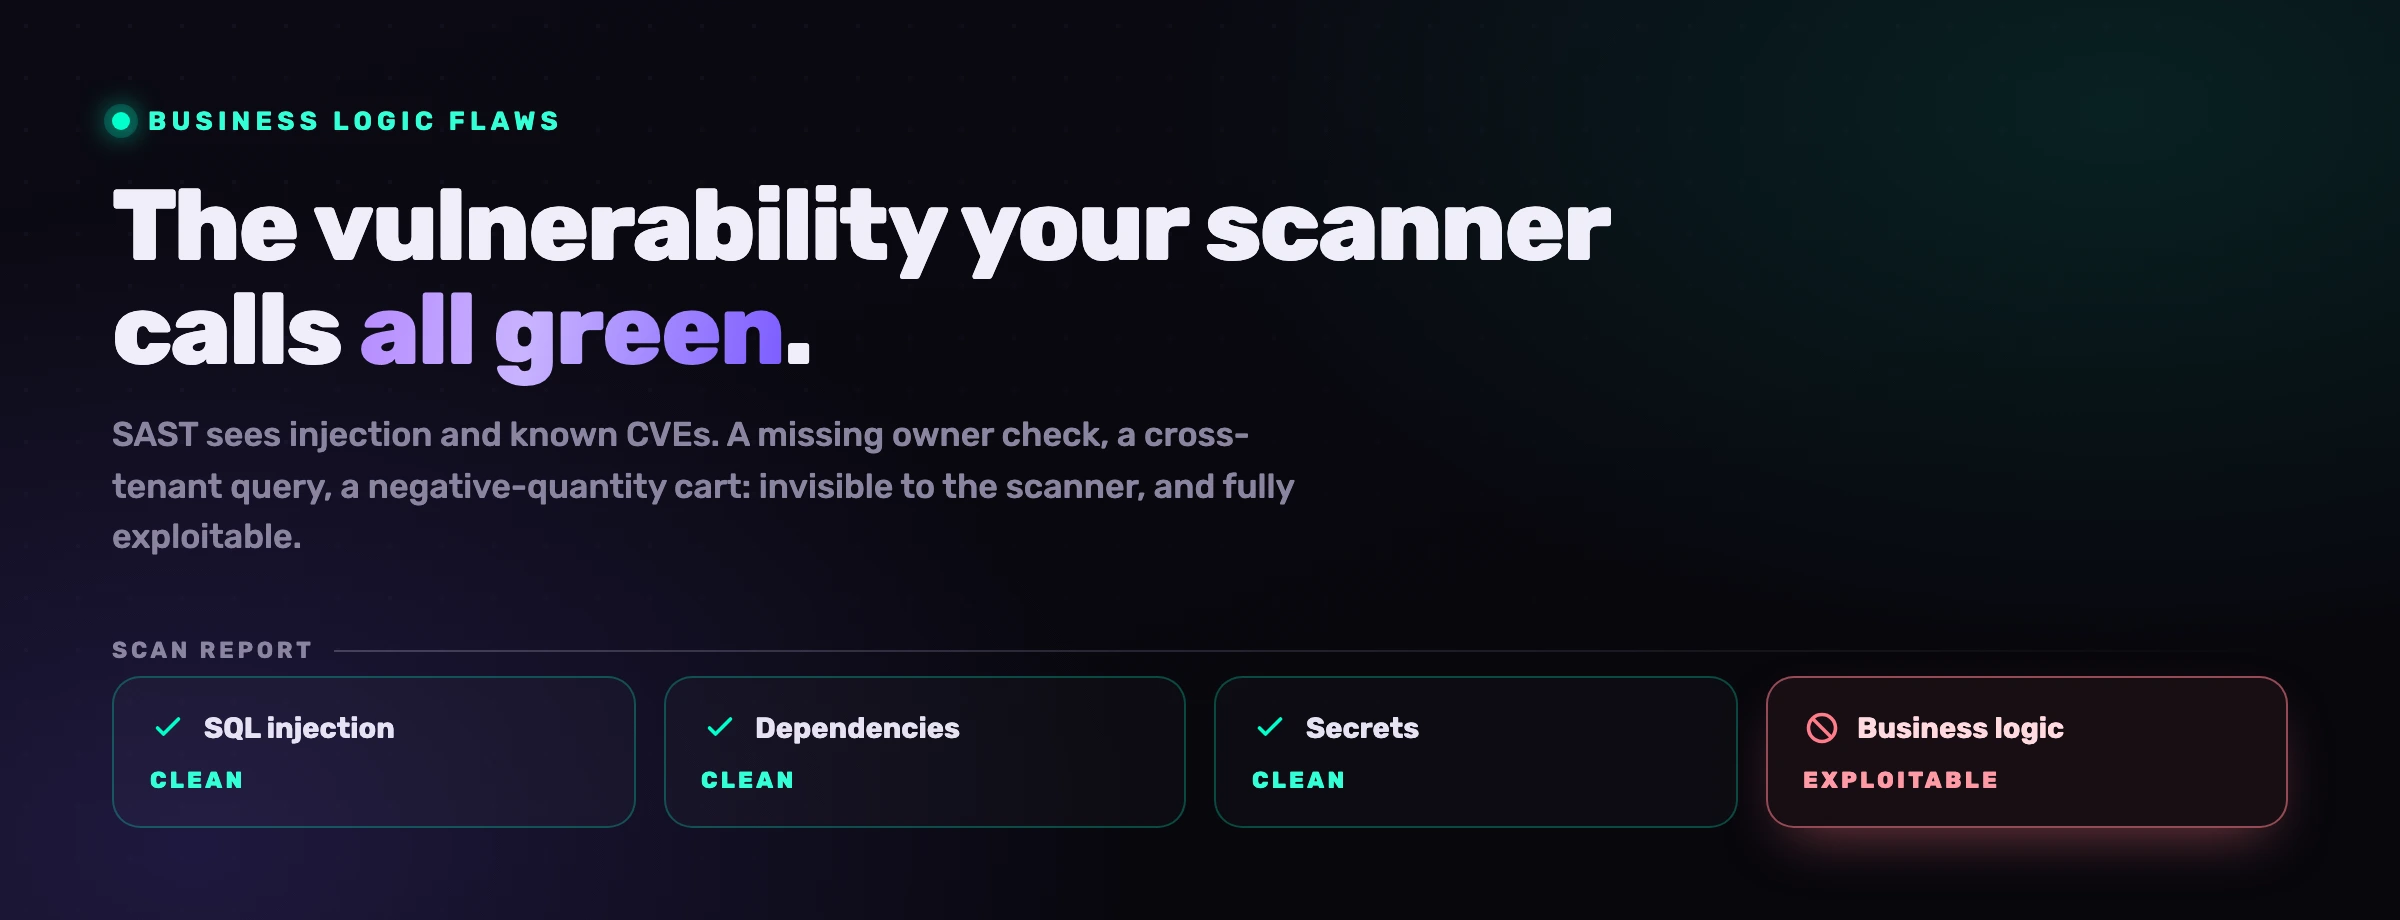
O teu scanner SAST consegue encontrar uma injeção de SQL numa string que nunca viu. Não consegue dizer-te que o teu novo endpoint de checkout deixa um cliente definir uma quantidade negativa e sair com dinheiro no bolso. A primeira é um padrão de sintaxe. A segunda é uma regra de negócio, e ninguém disse ao teu scanner quais são as tuas regras de negócio. Os agentes de código de IA alargam esta lacuna, porque geram código plausível, que encaixa na perfeição nos padrões do framework, enquanto quebram em silêncio a regra que importa.
O que é uma falha de lógica de negócio?
Uma falha de lógica de negócio é uma vulnerabilidade em que o código está sintaticamente correto, não tem injeção e assenta em bibliotecas com os patches em dia, mas viola uma regra que a tua aplicação devia impor. Os exemplos clássicos são a autorização quebrada, o scoping de tenant em falta, o abuso de inteiros ou de quantidades, as referências diretas inseguras a objetos (IDOR) e as race conditions na ordem das operações. Nada está malformado. A lógica simplesmente engana-se sobre o que é permitido.
É a categoria que a OWASP regista como Vulnerabilidades de Lógica de Negócio e, na parte da autorização, como Controlo de Acesso Quebrado, o risco número um do OWASP Top 10. Estas falhas são perigosas precisamente porque se confundem com tráfego normal. Não há payload malformado, não há stack trace, não há assinatura que um sistema de deteção de intrusões possa reconhecer. O pedido está bem formado; só não devia ter sido aceite. Seguimos um caso do princípio ao fim no carrinho de 0 EUR: uma pipeline CI/CD perfeita, todos os dashboards a verde e um inventário inteiro levado a custo zero.
Porque é que o SAST não consegue encontrar falhas de lógica de negócio?
Porque o SAST raciocina sobre o código, e uma regra de negócio vive fora dele. Um analisador estático consegue seguir dados contaminados de uma fonte até um sink e provar que uma injeção é alcançável. Mas não tem nenhuma fonte que lhe diga que "só o proprietário de um documento o pode editar" ou que "a quantidade tem de ser um inteiro positivo". Essas regras estão na tua cabeça, nos teus tickets e no teu domínio, não num padrão que o scanner traga de origem.
É um limite estrutural, não uma imaturidade que o próximo scanner vá resolver. O SAST brilha na análise de contaminação (taint): input não confiável, sink perigoso, nenhum sanitizador pelo meio. Uma verificação de autorização em falta tem a forma oposta. Não há input contaminado nem sink perigoso, só uma instrução if que nunca foi escrita. Nenhum padrão deteta a ausência de uma regra que nunca foi dada ao scanner. É também por isso que a maioria das equipas se afoga em resultados de scanners que passam ao lado do risco real, o tema de porque é que a maioria das descobertas de SAST é ruído. A imagem certa é a de um icebergue.
O que os scanners já veem
- Injeção: SQL, comando, XSS, SSRF, com um caminho claro da fonte ao sink
- CVEs conhecidos em dependências de terceiros (SCA)
- Segredos hardcoded e más configurações óbvias
A camada invisível de lógica de negócio
Abuso de quantidade e de dinheiro
Quantidade negativa ou nula, arredondamentos de float, um preço recalculado para zero no checkout.
Autorização quebrada
Uma rota de update ou de delete que nunca verifica se quem chama é mesmo o dono do registo.
IDOR
Trocar um id no URL para ler ou alterar um objeto que pertence a outra pessoa.
Scope de tenant em falta
Uma query filtrada por id mas não por tenant, que devolve as linhas de outro cliente.
Tudo o que está abaixo da linha de água passa numa execução limpa de SAST e SCA. O código compila, as bibliotecas estão atualizadas, nenhuma injeção é alcançável. O relatório está todo verde, e a aplicação é explorável.
Porque é que os agentes de código de IA produzem mais falhas destas?
Porque um agente de IA reconhece e reproduz padrões, aprendidos na forma do código que funciona, e uma regra de negócio não é uma forma. Quando pedes a um agente que "acrescente um endpoint para atualizar um projeto", ele produz um handler que faz parse do id, carrega a linha e grava a alteração, porque é isso que fazem milhões de handlers com ar de corretos. Não tem nenhuma razão para acrescentar uma verificação do proprietário ou um filtro de tenant, porque isso é específico do teu domínio e não faz parte do padrão genérico.
Por isso, a falha não é um bug que o modelo introduz por acaso; é o resultado previsível de gerar a média de todo o código parecido. O endpoint de update médio da internet não impõe o teu modelo de autorização. Pior: o resultado é fluente e seguro de si, e é exatamente isso que o faz passar na revisão. Um revisor passa os olhos por um handler igual a todos os outros e aprova-o. Ao ritmo da máquina, os agentes geram hoje milhares de linhas por dia, muito mais do que qualquer humano lê do princípio ao fim, e é no intervalo entre "parece certo" e "está certo" que as falhas de segurança se acumulam. Tratamos a superfície de risco mais ampla no nosso guia sobre segurança de agentes de código de IA.
Um scanner pergunta "esta linha é perigosa?". Uma falha de lógica de negócio responde "não", e é explorada na mesma. A pergunta certa é "este código segue as regras desta base de código?", e nenhuma ferramenta de sintaxe foi alguma vez feita para lhe responder.
Que aspeto têm as falhas de lógica de negócio no código de IA?
Têm o aspeto de código limpo e idiomático a que falta uma proteção. Eis três classes que um agente entrega a toda a hora. Todas compilam, todas passam no SAST, e todas são descobertas críticas.
Carrinho com quantidade negativa. Pede um endpoint de "adicionar ao carrinho" e recebes aritmética sem nenhuma restrição de domínio. Uma quantidade de -1 faz baixar o total.
// Vulnerable: no constraint on quantity
function addToCart(cart, item, quantity) {
  cart.total += item.price * quantity; // quantity = -1 lowers the total
  return cart;
}
// Fixed: enforce the business rule
function addToCart(cart, item, quantity) {
  if (!Number.isInteger(quantity) || quantity < 1) {
    throw new ValidationError("quantity must be a positive integer");
  }
  cart.total += item.price * quantity;
  return cart;
}
Autorização em falta / IDOR. Pede uma rota para "atualizar um projeto" e recebes um handler que carrega por id e grava. Qualquer utilizador autenticado pode passar qualquer id.
# Vulnerable: loads by id, never checks ownership (IDOR)
@app.put("/projects/{project_id}")
def update_project(project_id, body, user):
    project = db.get(Project, project_id)
    project.name = body.name
    db.commit()
    return project
# Fixed: require the caller to own the record
@app.put("/projects/{project_id}")
def update_project(project_id, body, user):
    project = db.get(Project, project_id)
    require_owner(project, user)  # 403 if user.id != project.owner_id
    project.name = body.name
    db.commit()
    return project
Scope de tenant em falta. Numa aplicação multi-tenant, uma query filtrada só por id deixa passar dados entre tenants.
# Vulnerable: filtered by id only, crosses tenant boundary
invoice = db.query(Invoice).filter(Invoice.id == invoice_id).first()
# Fixed: scope every query to the caller's tenant
invoice = db.query(Invoice).filter(
    Invoice.id == invoice_id,
    Invoice.tenant_id == user.tenant_id,
).first()
Nos três casos, o que separa o seguro do explorável é uma linha que codifica uma regra que o agente não tinha como conhecer. O caso da quantidade negativa é também, por si só, uma cadeia de exploração completa.
Como apanhar as falhas de lógica de negócio no agent-time?
Apanhas-as quando dás as tuas regras ao agente antes de ele escrever, não quando analisas o que ele já entregou. Se, no momento em que gera o handler, o agente sabe que "o dinheiro usa Decimal, todas as escritas passam por requireOwner, todas as queries ficam limitadas a tenant_id", escreve logo à primeira a versão protegida. A falha nunca chega a existir, por isso não há nada para encontrar, triar ou corrigir mais tarde.
É esta a mudança de fundo: a verificação passa para antes da escrita. Um scanner que chega depois só consegue assinalar o que já está no diff, o que obriga ainda um humano a ler, perceber e rejeitar, à pressa, código com ar fluente. Carregar as regras no contexto do agente faz da regra o comportamento por defeito. O agente deixa de produzir o endpoint médio e passa a produzir o teu endpoint. Nos domínios onde estas falhas custam mais caro, a banca e a fintech, impor as regras no agent-time é a diferença entre uma proteção que existe por conceção e uma que depende de um revisor reparar que ela falta.
Em que é que isto difere do SAST e do SCA?
Ataca outra camada do problema. O SAST e o SCA respondem a "este código é perigoso ou está desatualizado?". A imposição de regras no agent-time responde a "este código segue as regras desta base de código?". Precisas das duas coisas: mantém o SAST para a injeção e a contaminação, mantém o SCA para as dependências vulneráveis, e acrescenta uma camada que leva as tuas regras de negócio até ao momento da geração.
A stack legada é necessária, mas não chega. Foi construída para um problema de sintaxe e continua a ser a ferramenta certa para esse problema. As falhas de lógica de negócio são um problema de intenção, e pedem uma camada que conheça a tua intenção.
O VibeDefend é essa camada. Extrai as regras de negócio que já estão no teu repositório e carrega-as no teu agente de código de IA antes de cada edição, para que o agente escreva código que respeita as tuas regras de autorização, de dinheiro e de tenant logo desde a primeira tecla. É uma CLI npm gratuita e instala-se com um só comando.
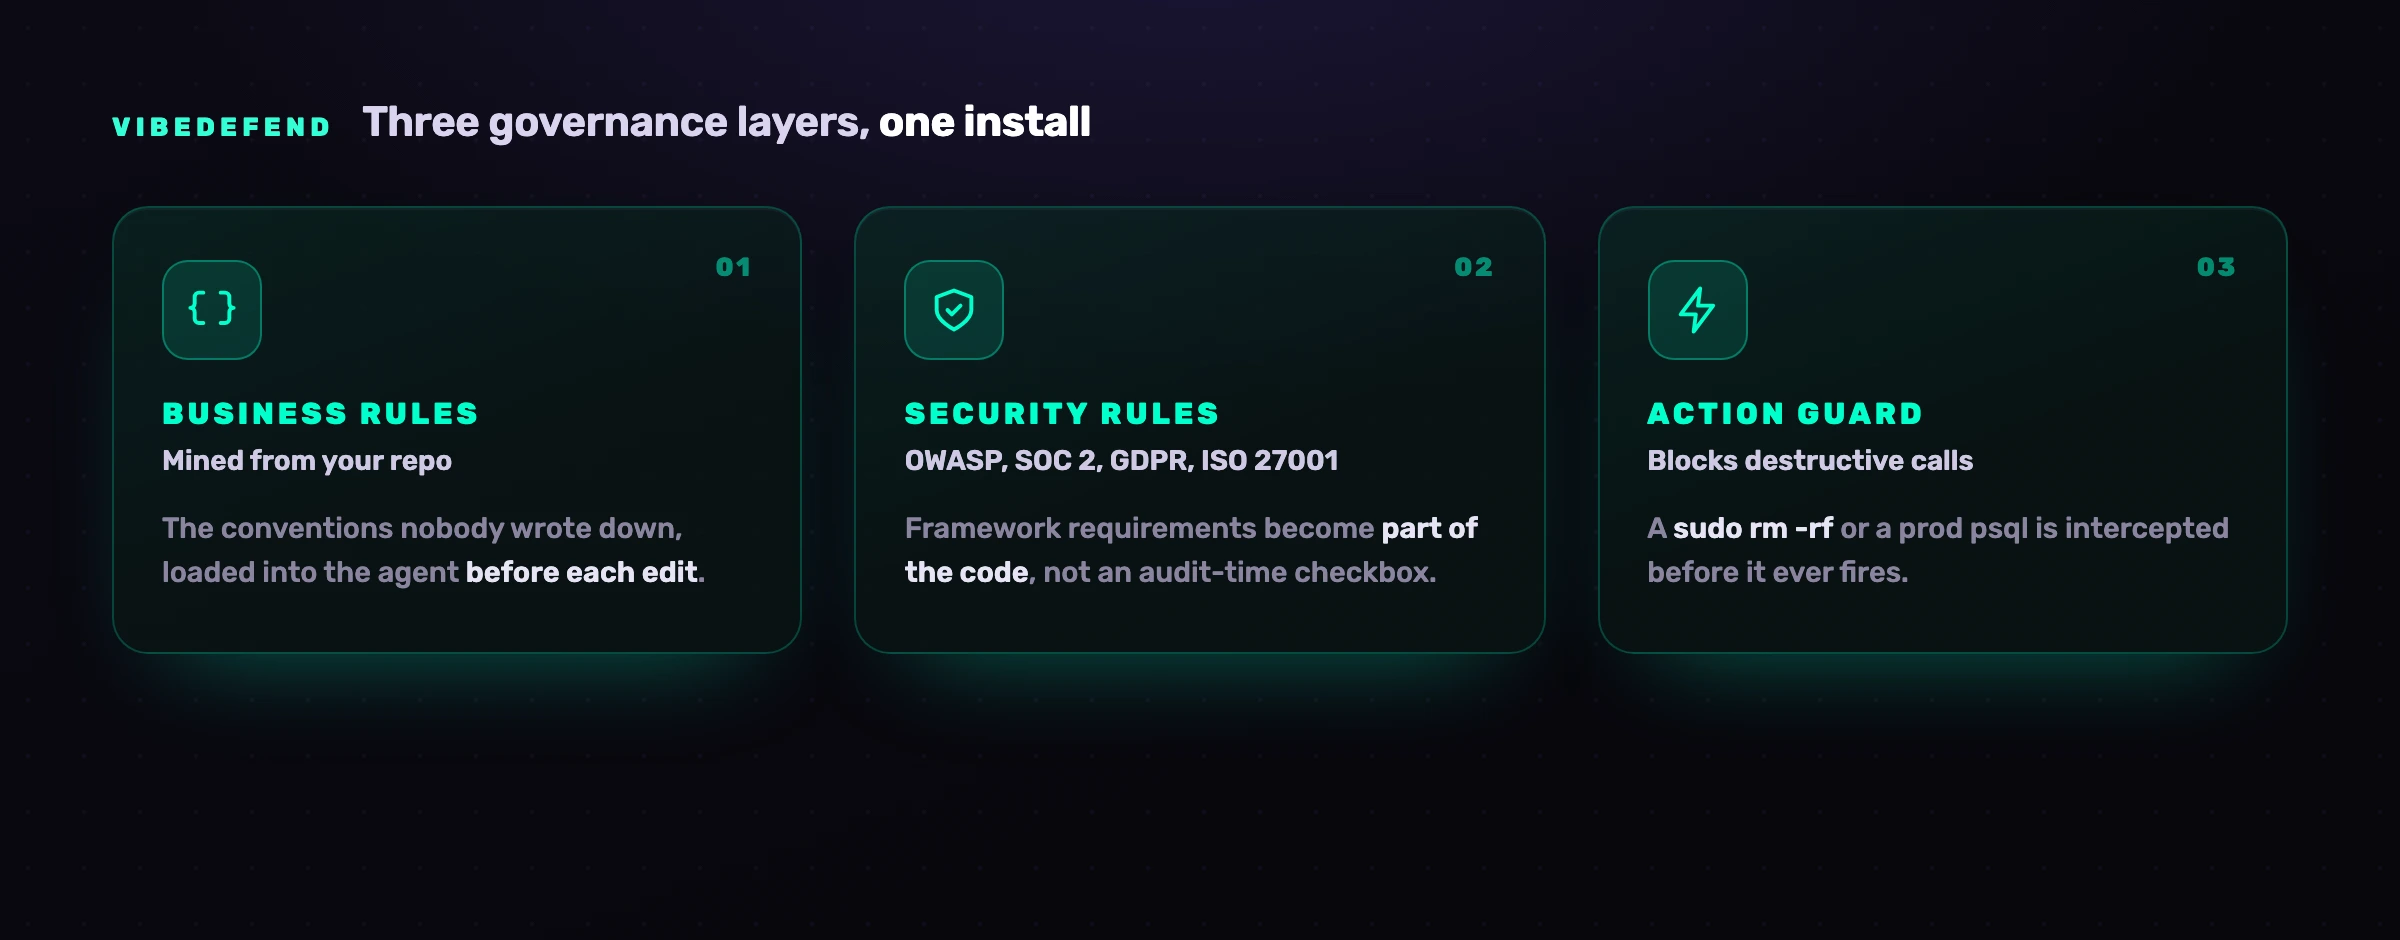
A camada de Regras de Negócio é extraída do teu próprio repositório (usar Decimal para dinheiro, fazer passar todas as escritas por requireOwner, limitar todas as queries ao tenant) e é carregada no agente antes de cada edição. Uma quarta camada, Live Findings, liga o agente à plataforma de segurança do código da CybeDefend, para que cada resultado dos seus scanners (SAST com alcançabilidade, SCA, segredos, IaC e CI/CD) esteja ao vivo no contexto do agente para triar e corrigir, e não só as regras de lógica de negócio que guiam a escrita. Quanto ao teu código: o VibeDefend envia um excerto curto da linha que está a ser escrita para servir as regras e os ficheiros alterados para a análise antes do commit, ambos para a região da UE ou dos EUA que escolheres na instalação (as duas são fisicamente separadas), e o teu código nunca é usado para treinar um modelo.
Perguntas frequentes
O que é, em termos simples, uma falha de lógica de negócio?
É código que funciona exatamente como foi escrito, mas faz algo que não devia permitir. A sintaxe é válida, não há injeção e as bibliotecas têm os patches em dia, mas a aplicação quebra uma das suas próprias regras: um carrinho que aceita uma quantidade negativa, um endpoint que devolve os dados de outro cliente, uma rota de update sem verificação de propriedade. Como o pedido está bem formado, confunde-se com tráfego normal e escapa tanto aos scanners como à deteção de intrusões.
Porque é que o SAST e o SCA não conseguem apanhar vulnerabilidades de lógica de negócio?
Porque as duas ferramentas raciocinam sobre o código, e uma regra de negócio vive fora dele. O SAST segue dados não confiáveis até um sink perigoso, o que é um problema de sintaxe. Uma verificação de autorização em falta não tem input contaminado nem sink, só uma proteção que nunca foi escrita, e nenhum padrão deteta a ausência de uma regra que nunca foi dada ao scanner. O SCA limita-se a comparar as tuas dependências com uma base de dados de CVEs. Nenhuma das duas foi feita para conhecer o teu modelo de autorização ou a tua fronteira de tenant.
Porque é que os agentes de código de IA produzem mais falhas de lógica de negócio?
Porque geram a média estatística do código parecido, e o endpoint médio da internet não impõe as tuas regras específicas. Quando lhe pedem um handler de update, o agente produz um que carrega uma linha e a grava, porque esse é o padrão mais comum, sem a verificação do proprietário nem o filtro de tenant que o teu domínio exige. O resultado é fluente e parece correto, o que o faz passar na revisão, e os agentes geram por dia muito mais código do que alguém consegue ler com atenção.
Quais são as falhas de lógica de negócio mais comuns no código gerado por IA?
As que se repetem são a autorização quebrada (um caminho de escrita sem verificação de propriedade), as referências diretas inseguras a objetos ou IDOR (mudar um id no URL para aceder ao objeto de outra pessoa), o scoping de tenant em falta (uma query filtrada por id mas não por tenant) e o abuso de quantidades ou de dinheiro (quantidades negativas ou nulas, arredondamentos de float, um preço recalculado para zero no checkout). As race conditions em fluxos de vários passos são uma quinta classe. Todas passam numa execução limpa de SAST e SCA.
Como prevenir as falhas de lógica de negócio em vez de apenas as detetar?
Passando a verificação para antes de o código ser escrito. Se, no momento em que gera o handler, o agente conhece as tuas regras (usar um tipo para dinheiro, fazer passar as escritas por uma verificação de propriedade, limitar todas as queries ao tenant), escreve logo à primeira a versão protegida e a falha nunca existe. Um scanner que chega depois só consegue assinalar o que já está no diff, e continua a depender de um humano para rejeitar código com ar fluente. Carregar as regras no agente faz do padrão seguro o comportamento por defeito.
Isto substitui o meu scanner SAST e SCA?
Não, complementa-os. O SAST continua a ser a ferramenta certa para a injeção e a análise de contaminação, e o SCA continua a ser a ferramenta certa para as dependências vulneráveis; ambos resolvem bem os problemas de sintaxe e de dependências. As falhas de lógica de negócio são um problema de intenção que essas ferramentas, por conceção, não conseguem ver. O quadro completo junta os scanners que já tens, para a sintaxe e os CVEs, a uma camada agent-time que leva as tuas regras de negócio até ao momento da geração.
Como é que o VibeDefend conhece as minhas regras de negócio?
A plataforma CybeDefend extrai-as do repositório que ligares: o tipo que usas para dinheiro, o helper de autorização que os teus caminhos de escrita chamam, a coluna de tenant nas tuas queries, cada uma transformada numa regra explícita. Para servir as que se aplicam à linha que está a ser escrita, o VibeDefend envia um excerto curto desse código para a região da UE ou dos EUA que escolheres na instalação, e o teu código nunca é usado para treinar um modelo. O resultado é um agente que aplica as tuas convenções por defeito antes de cada edição, em vez de um scanner a inspecionar o teu código depois de o mal estar feito.