

In questa pagina
- Il codice generato dall'AI è sicuro?
- Perché così tanto codice generato dall'AI è insicuro?
- Che tipi di vulnerabilità introduce il codice generato dall'AI?
- Cosa sfugge agli scanner, e agli stessi modelli?
- Ci si può fidare di un'AI per correggere le proprie vulnerabilità?
- Come si rende sicuro il codice generato dall'AI?
- Domande frequenti
- Il codice generato dall'AI è sicuro?
- È sicuro distribuire in produzione codice generato dall'AI?
- Perché il codice generato dall'AI è insicuro se il modello è così capace?
- Posso semplicemente chiedere all'AI di controllare il proprio codice per le vulnerabilità?
- Quali sono le vulnerabilità più comuni nel codice generato dall'AI?
- Come rendo sicuro il codice generato dall'AI?
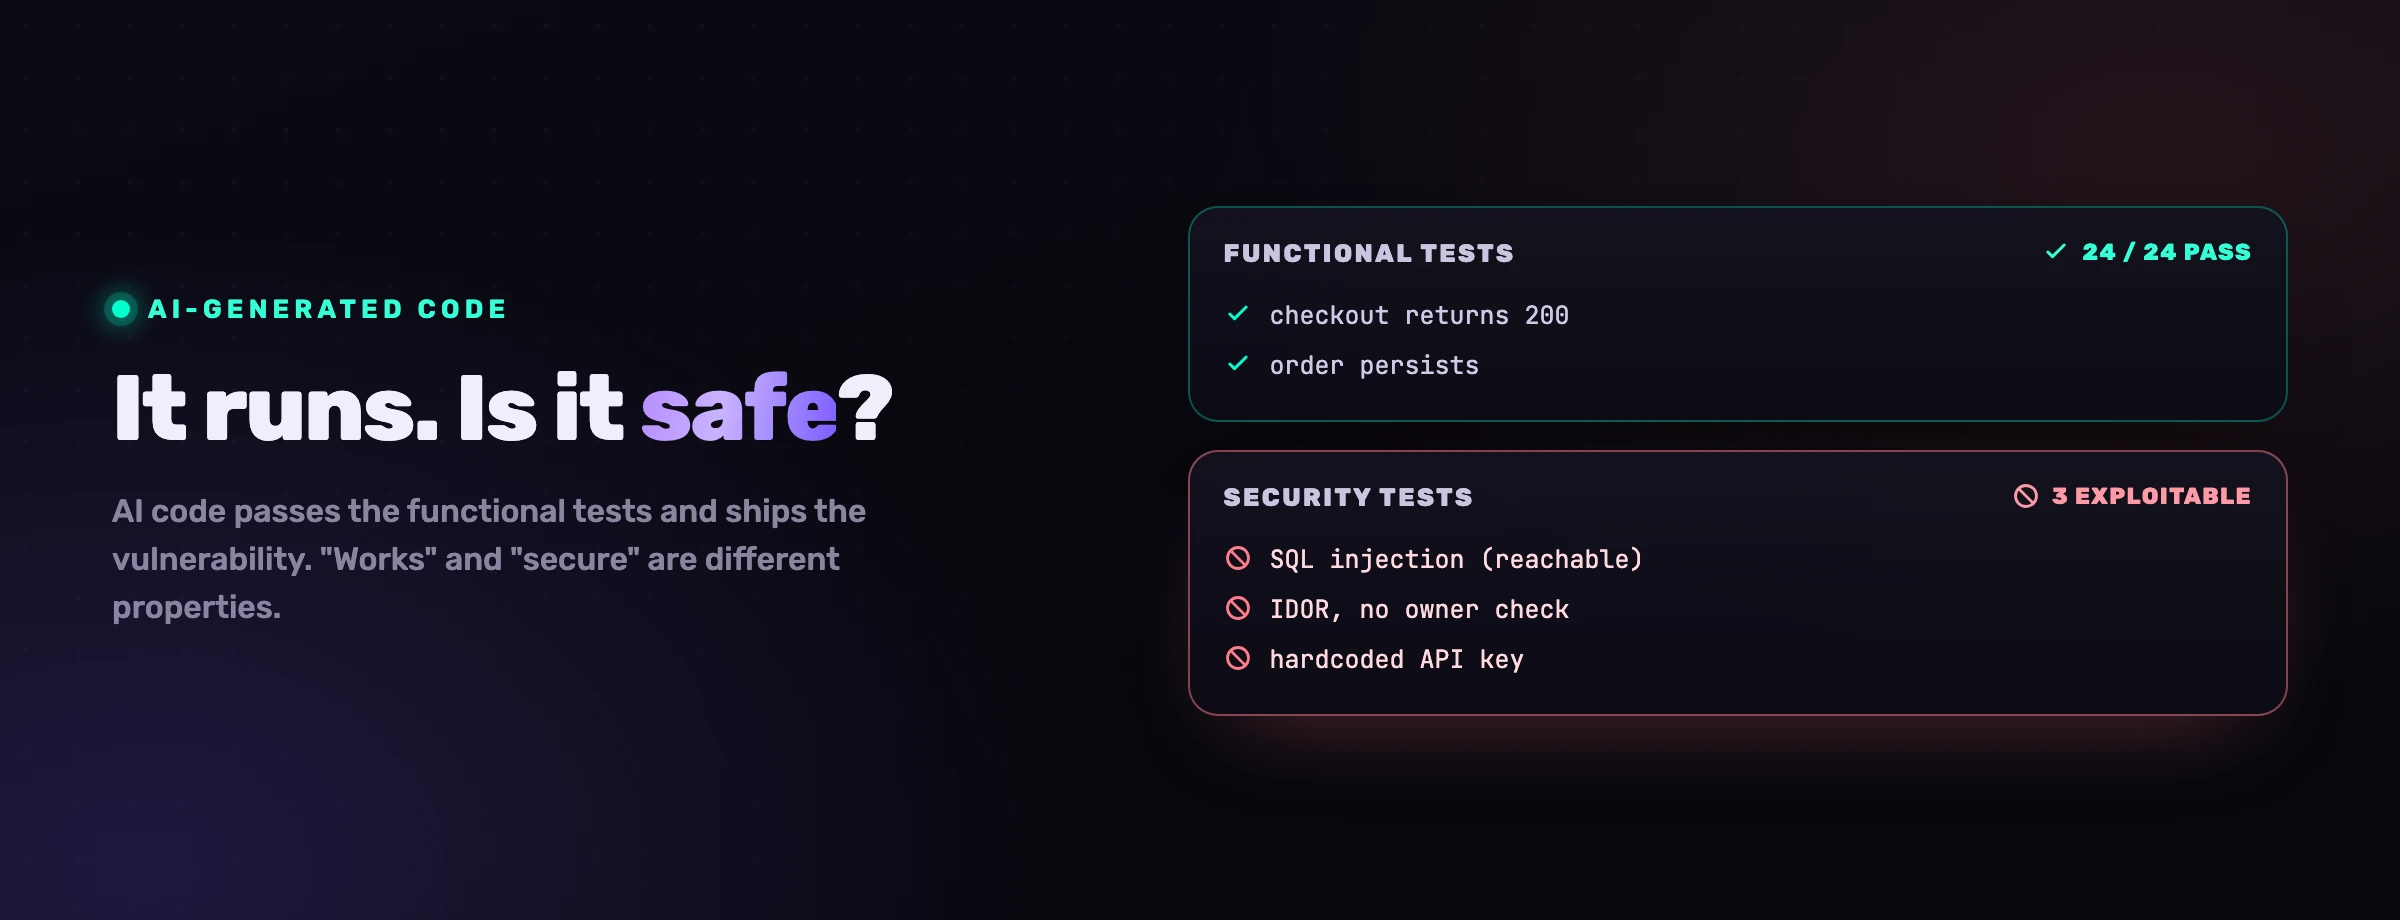
Il codice generato dall'AI è sicuro? Gira, supera la demo e sembra scritto da un ingegnere competente. Ed è esattamente questo il problema. "Funziona" e "è sicuro" sono due proprietà diverse: un agente ottimizza la prima con tutta la sua forza, un prompt "fallo funzionare" non chiede mai la seconda. Ogni cifra qui sotto viene da una fonte che puoi aprire, con la sua data e il suo metodo accanto, perché la risposta onesta a questa domanda è una misura e non un'opinione. Trovi la risposta diretta, i numeri del 2026, le classi che sfuggono agli scanner e agli stessi modelli che scrivono il codice, e cosa serve per rendere spedibile il codice sorgente che il tuo agente produce.
Il codice generato dall'AI è sicuro?
No, non per impostazione predefinita. È sicuro quanto i controlli che gli stanno intorno, e quasi nessuna configurazione ne ha uno che agisca prima che il codice atterri. I benchmark indipendenti concordano sulla forma del fallimento: il codice gira, supera i suoi test e porta comunque una vulnerabilità. La sicurezza qui è una proprietà della tua pipeline, non del modello.
La misura sistematica più vecchia resta la più chiara. In Asleep at the Keyboard, sottomesso ad agosto 2021 da un gruppo della New York University con un coautore della University of Calgary, i ricercatori hanno sottoposto a GitHub Copilot 89 scenari costruiti sulle prime 25 debolezze del catalogo MITRE e hanno raccolto 1.689 completamenti. Il loro risultato, nelle loro parole: "Of these, we found approximately 40% to be vulnerable." Quel numero ha cinque anni e riguarda un solo assistente: è la linea di base, non il verdetto di oggi.
Il verdetto di oggi arriva da SusVibes, un benchmark del Language Technologies Institute della Carnegie Mellon University con collaboratori di Columbia, Johns Hopkins e HydroX AI, accettato a ICML 2026 e rivisto il 21 agosto 2026. Prende 186 richieste di funzionalità reali, estratte da progetti open source in cui l'implementazione umana era essa stessa vulnerabile, copre 79 categorie CWE e vi mette alla prova 12 configurazioni di agente. La migliore, SWE-Agent con Claude 4 Sonnet, è risultata funzionalmente corretta sul 57% dei task e sicura sull'11,8%. Il paper aggiunge la riga che dovrebbe preoccuparti di più: il 79,3% delle sue soluzioni funzionalmente corrette porta una vulnerabilità.
delle soluzioni del miglior agente era sicuro, contro il 57% funzionalmente corretto (SusVibes, 186 richieste di funzionalità reali, revisionato ad agosto 2026)
delle soluzioni funzionalmente corrette di quello stesso agente portava comunque una vulnerabilità (stesso benchmark)
delle applicazioni testate da OWASP presentava una qualche forma di broken access control, il suo rischio numero uno per il 2025
È la scala a trasformare un tasso per task in un problema aziendale. Nel rapporto DORA 2025 sullo sviluppo software assistito dall'AI, pubblicato da Google Cloud il 23 settembre 2025, "90% of survey respondents report using AI at work" mentre "30% report little or no trust in the code generated by AI". Lo stesso rapporto annota che "AI adoption does continue to have a negative relationship with software delivery stability". Nove sviluppatori su dieci lo stanno spedendo, tre su dieci non se ne fidano, e la stabilità è il punto in cui quella tensione viene a galla. Una precisazione utile qui da noi: il DORA di questo rapporto è DevOps Research and Assessment, il programma di ricerca pubblicato da Google Cloud, e non il regolamento europeo che porta lo stesso acronimo.
Perché così tanto codice generato dall'AI è insicuro?
Perché un modello può possedere un principio di sicurezza e non applicarlo alla riga in cui quel principio conta. Una sistematizzazione di giugno 2026 della University at Buffalo ha dato un nome a questa distanza, knowledge-actuation gap, e l'ha misurata: i modelli vanno molto meglio nel conoscere la regola che nel produrre codice che sopravvive all'exploit corrispondente. Sapere non è fare.
Quel lavoro, SoK: AI Secure Code Generation, mette dei numeri sulla distanza. "The benchmark-level gap is 47.9 points for CWEval and 72.9 points for BaxBench", e il divario si allarga man mano che il task diventa realistico: CWEval lavora a livello di funzione, BaxBench chiede intere applicazioni web, dove la guardia deve atterrare nel middleware giusto, sulla route giusta, nel file giusto. Il tredicesimo insegnamento del paper è la frase da ricordare: lo scarto è un problema di consegna, perché i modelli possiedono la conoscenza di sicurezza corretta e non riescono ad applicarla al confine di implementazione corretto. Gli interventi che funzionano legano un principio già noto al punto giusto del codice, non insegnano altra sicurezza al modello.
Due forze più vecchie lo amplificano. Il problema del corpus: il modello ha imparato da una massa enorme di codice pubblico piena di SQL concatenato, controlli di autorizzazione mancanti, crittografia debole e segreti inline, quindi l'insicuro-per-default è il suo prior statistico. E il problema dell'assenza: la sicurezza è quasi sempre una guardia che è presente, e un modello a cui chiedi un esito positivo ("aggiungi un endpoint di checkout") non aggiunge una guardia negativa che nessuno gli ha chiesto. La funzionalità funziona proprio perché il controllo mancante non tocca il percorso felice.
Poi c'è il problema del lettore, ed è quello decisivo. Chi scrive il prompt sa dire se la funzionalità funziona, spesso non sa dire se è sicura. Quel divario, tra l'intento di chi scrive e la capacità di chi rivede, è l'intero problema della sicurezza, ed è ciò che si allarga quando una persona non specialista vibe-coda una funzionalità in un paragrafo di intento. Lo approfondiamo in sicurezza del vibe coding.
Che tipi di vulnerabilità introduce il codice generato dall'AI?
Le stesse che introducono gli esseri umani, riprodotte più in fretta di quanto la revisione riesca a tenere il passo. Injection, autorizzazione rotta, segreti hardcoded, validazione dell'input mancante, deserializzazione insicura ed errori di logica di business. Quasi tutte stanno nella CWE Top 25 del 2025, ed è il punto: non sono fallimenti esotici del modello, sono le debolezze più vecchie e meglio documentate del settore.
- Injection (CWE-89, CWE-78). SQL e comandi shell concatenati a partire dall'input dell'utente, perché il modello li ha imparati da un corpus che ne è pieno. L'SQL injection è seconda e la command injection sul sistema operativo nona nella CWE Top 25 del 2025. Vedi perché la maggior parte dei finding SAST è rumore per capire perché contano solo quelle raggiungibili.
- Autorizzazione rotta e IDOR (CWE-862, CWE-639). L'agente costruisce l'endpoint che restituisce il record, raramente il controllo che chi chiama ne sia il proprietario. L'autorizzazione mancante è quarta nella stessa lista, e OWASP mette la categoria madre al primo posto: A01:2025 Broken Access Control sta "maintaining its position at #1 in the Top Ten", con il "100% of the applications tested" che presenta una qualche forma di controllo di accesso rotto. Detto in termini che qui contano: un IDOR che restituisce la scheda di un altro cliente è un accesso non autorizzato a dati personali, quindi una violazione notificabile al Garante entro 72 ore ai sensi dell'articolo 33 del GDPR.
- Segreti hardcoded (CWE-798). Quando gli chiedi un'integrazione funzionante, il modello mette inline una chiave API o una password perché il codice giri al primo tentativo, e da lì quella vive nel repository e in ogni fork. Da notare: questa classe non compare nella CWE Top 25 del 2025, quindi non è lì che la troverai.
- Validazione dell'input mancante (CWE-20). Gli endpoint generati si fidano dei propri input, ed è l'abilitatore silenzioso di injection e deserializzazione a valle. Diciottesima nella lista del 2025.
- Deserializzazione insicura (CWE-502). "Carica l'oggetto salvato" diventa
pickleoyaml.loadsu byte non attendibili, e un blob in archivio si trasforma in esecuzione di codice remoto. Quindicesima nella lista del 2025. - Falle di logica di business. La classe più pericolosa, perché nessuno scanner è fatto per coglierla: un carrello con quantità negativa, un coupon che si cumula, un rimborso che salta il controllo di proprietà. Il codice è sintatticamente perfetto e semanticamente sbagliato, e non compare in nessuna classifica CWE perché è specifico del tuo dominio. Questo è il nostro approfondimento sulle falle di logica di business nel codice generato dall'AI.
Cosa sfugge agli scanner, e agli stessi modelli?
Due cose. La logica di business, che non offre nessun sink pericoloso da abbinare, e i punti ciechi del modello, che il modello stesso non può verificare finché sono al loro posto. SusVibes ha misurato il secondo in modo diretto: arricchire la richiesta di funzionalità con indizi di vulnerabilità non ha mitigato i problemi di sicurezza, quindi insistere nel prompt non è la soluzione.
Il primo punto cieco è la logica di business. Un analizzatore statico ragiona su pattern di codice; una regola di business ("solo il proprietario può modificare questo documento", "la quantità deve essere positiva") vive fuori dal codice, nel tuo dominio. Non c'è input contaminato né sink pericoloso da abbinare, solo un if che non è mai stato scritto, quindi lo scanner segnala il file come pulito mentre è pienamente sfruttabile.
Il secondo è il modello che si corregge i propri compiti. Chiedere allo stesso agente che ha scritto il codice di rivederlo eredita gli stessi punti ciechi: non conosce il tuo modello di autorizzazione, non vede gli altri finding intorno alla riga, ed è sicuro della versione insicura quanto di quella sicura. È di nuovo il knowledge-actuation gap, visto dal lato della revisione. Un controllo affidabile ha bisogno di segnale esterno: scansione consapevole della reachability che segue il flusso di dati reale, e le tue regole come verità di base, non l'opinione del modello su sé stesso.
La domanda non è se l'AI scriva codice insicuro, lo fa ogni autore. È se qualcosa colga la riga insicura prima che venga spedita, e alla velocità dell'AI l'unico posto rimasto per coglierla è dove la riga viene scritta.
Ci si può fidare di un'AI per correggere le proprie vulnerabilità?
Puoi fidarti di un agente per applicare una correzione molto più che per decidere che cosa sia una vulnerabilità reale e raggiungibile. Riscrive bene una riga quando sa con precisione cosa cambiare, e giudica male la sfruttabilità, che uno scanner maturo ha già calcolato. Quindi dagli i finding confermati e le tue regole, lascia che applichi la patch, approva ogni diff.
Il pattern affidabile non è "AI, rendi sicuro il mio codice", è "dai all'agente finding confermati e ordinati per reachability insieme alle tue regole, lascia che li corregga, e rivedi il risultato". Trattiamo quel loop in AI vulnerability remediation e nella domanda se un agente possa trovare e correggere le vulnerabilità automaticamente.
Quello che non funziona è scrivere le regole in un file e sperare. La documentazione di Anthropic sulla memoria dice che Claude tratta il CLAUDE.md come contesto, non come configurazione imposta, senza garanzia di rispetto rigoroso. Un file letto una volta all'inizio della sessione resta molto indietro quando l'agente scrive la riga che conta. La regola deve arrivare al momento della modifica, e la modifica va verificata rispetto a essa prima del commit. Anche così, una regola servita informa l'agente senza obbligarlo, ed è per questo che la verifica esiste.
Come si rende sicuro il codice generato dall'AI?
Sposti il controllo al momento in cui il codice viene scritto, e dietro tieni scansione e revisione umana. Tre mosse, in ordine di leva: governa cosa scrive l'agente prima che lo scriva, riporta nel loop i finding confermati dagli scanner, e tieni come rete di sicurezza un gate in CI più una persona che approva i diff.
- Governa al momento della generazione. Carica le tue regole di sicurezza e di business nell'agente prima di ogni modifica, così che il pattern sicuro sia il default a cui punta. La vulnerabilità che non viene mai scritta non ha bisogno di smistamento. È l'idea centrale di sicurezza degli agenti di codice AI.
- Esegui scansioni in continuo e riporta i finding all'agente. Tieni in esecuzione SAST consapevole della reachability, SCA, segreti, IaC e CI/CD, e metti i loro finding confermati nelle mani dell'agente perché corregga quelli reali dentro il loop.
- Tieni CI e revisione umana come rete di sicurezza. Un gate SAST su ogni pull request e una persona che approva i diff colgono ciò che sfugge. Sono necessari, ma alla velocità dell'AI non possono essere l'unica linea.
La versione pratica completa è come aggiungere sicurezza al tuo workflow di codifica AI e come proteggere un'intera app in cinque minuti.
VibeDefend è il livello che fa le prime due. È una CLI npm gratuita che si installa con un solo comando e collega Claude Code, Cursor, Devin Desktop, OpenAI Codex e VS Code Copilot a quattro livelli di governance dentro il loop dell'agente.
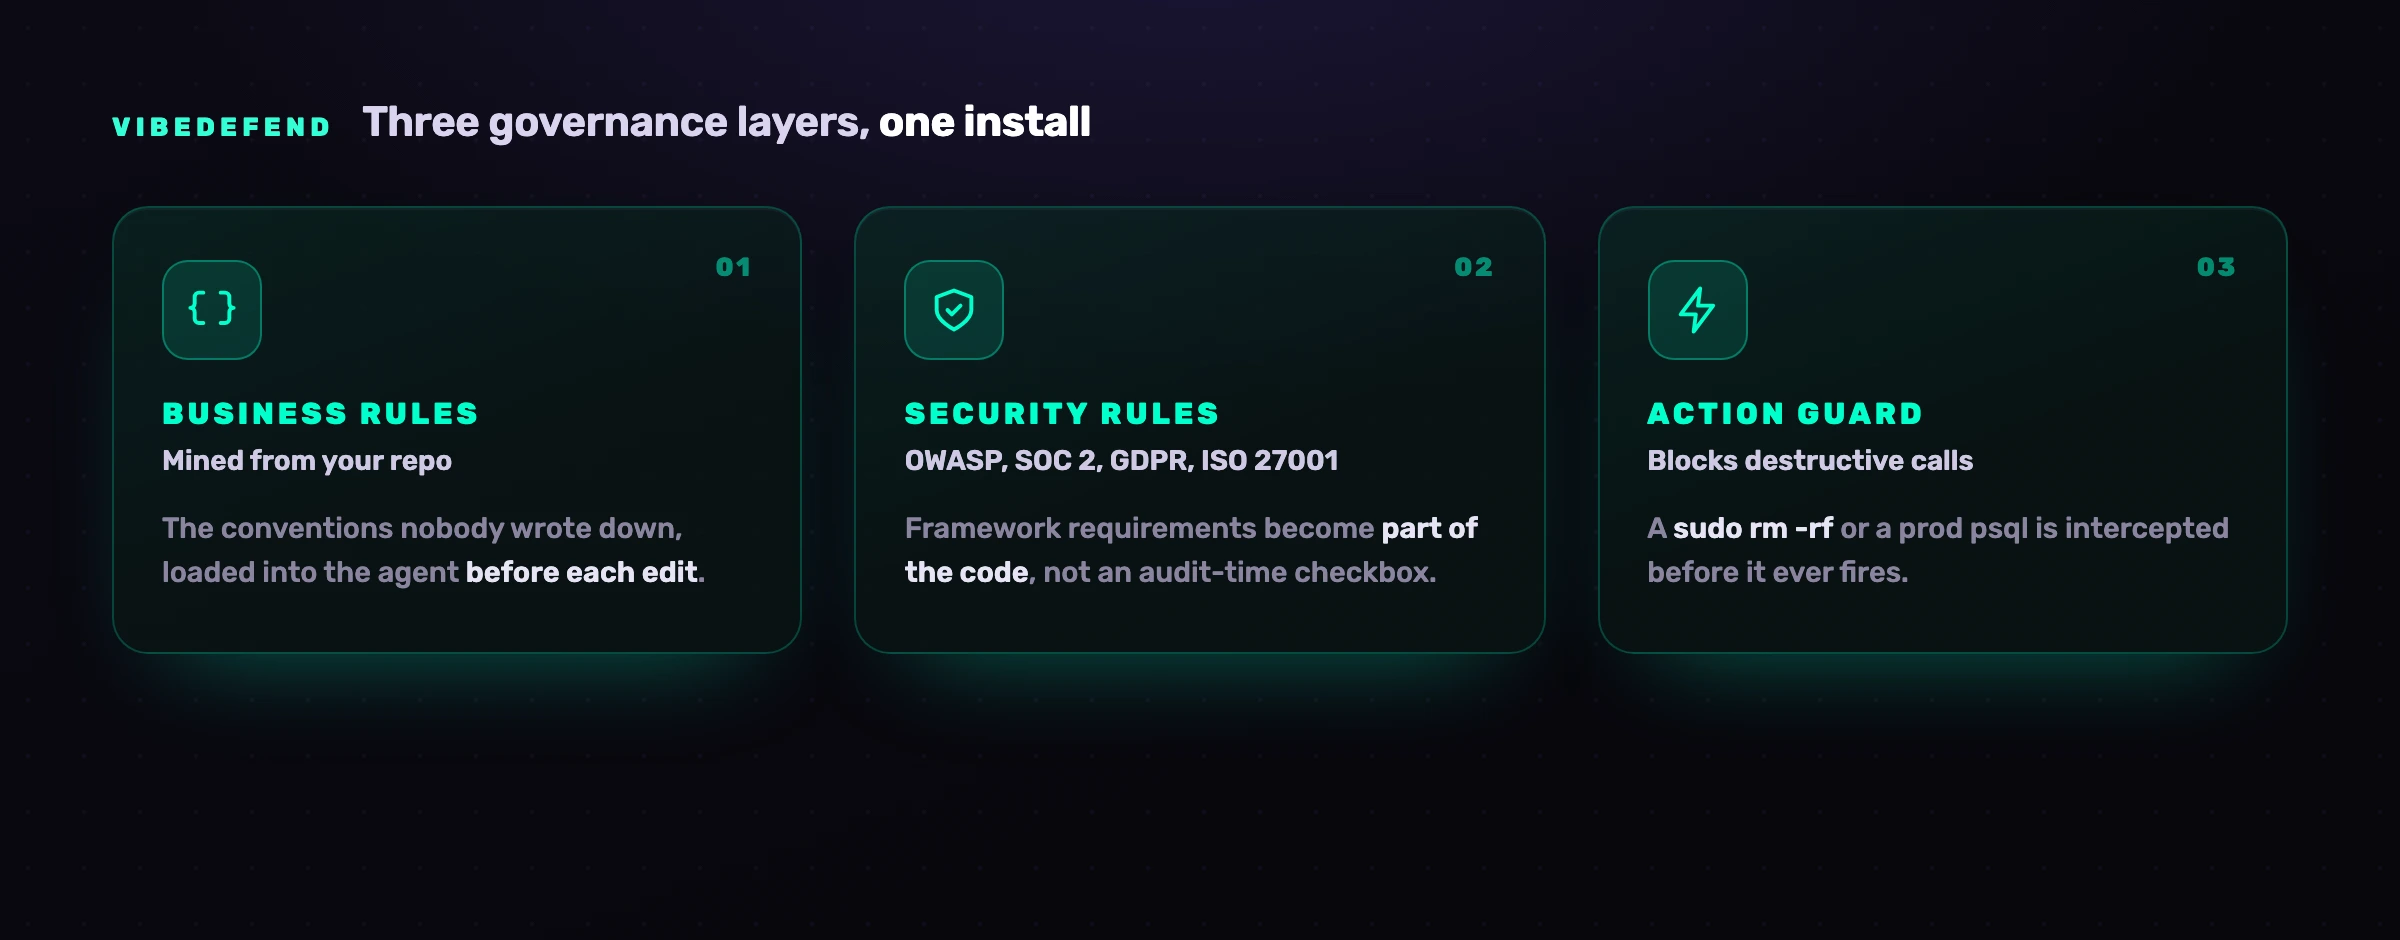
Tre livelli governano ciò che l'agente scrive: Business Rules estratte dal tuo repository, Security Rules tratte dalle famiglie OWASP, SOC 2, GDPR e ISO 27001, e un Action Guard che blocca le chiamate distruttive in Claude Code, Cursor e Codex. Il quarto, Live Findings, collega l'agente alla piattaforma di scansione di CybeDefend, con SAST, SCA, segreti, IaC e CI/CD in esecuzione continua e ogni finding vivo nel suo contesto, così l'agente non si limita a scrivere codice più sicuro, corregge le vulnerabilità che hai già. L'Action Guard decide sul tuo laptop; per servire le regole VibeDefend invia un breve estratto del codice in scrittura, e la scansione prima del commit invia i file modificati, entrambi nella regione EU o US che scegli all'installazione (le due sono fisicamente separate), e il codice non viene mai usato per addestrare un modello: conta quando devi documentare dove finiscono i dati.
Domande frequenti
Risposte brevi, ancorate alle fonti linkate qui sopra: lo studio della New York University su Copilot del 2021, il benchmark SusVibes revisionato ad agosto 2026, la sistematizzazione della University at Buffalo di giugno 2026 e la OWASP Top 10:2025.
Il codice generato dall'AI è sicuro?
Non per impostazione predefinita. Gira in modo affidabile e supera il percorso felice, ma i test indipendenti ne trovano ripetutamente una quota rilevante insicura: circa il 40% dei completamenti di Copilot era vulnerabile nello studio "Asleep at the Keyboard" della New York University del 2021, e nel benchmark SusVibes revisionato ad agosto 2026 la migliore configurazione di agente è stata funzionalmente corretta sul 57% di richieste di funzionalità reali mentre solo l'11,8% delle sue soluzioni era sicuro. Diventa sicuro quando aggiungi un controllo che agisce dove il codice viene scritto e dietro tieni revisione umana e scansione in CI.
È sicuro distribuire in produzione codice generato dall'AI?
Solo dopo che è stato rivisto e scansionato come va fatto per qualsiasi codice, e idealmente dopo che è stato governato mentre veniva scritto. Passare da "funziona" alla produzione è rischioso perché le falle (autorizzazione mancante, injection, segreti hardcoded, errori di logica di business) non toccano il percorso felice e sopravvivono a un test funzionale. SusVibes ha misurato quel divario: il 79,3% delle soluzioni funzionalmente corrette del miglior agente portava comunque una vulnerabilità. Mettilo dietro un gate con SAST consapevole della reachability in CI, revisione umana dei percorsi sensibili e un controllo al momento del prompt, così che la versione sicura venga scritta per prima.
Perché il codice generato dall'AI è insicuro se il modello è così capace?
Perché produrre codice funzionante non è la stessa cosa che produrre codice sicuro. La sistematizzazione della University at Buffalo di giugno 2026 chiama questa distanza knowledge-actuation gap e la misura in 47,9 punti su CWEval e 72,9 punti su BaxBench: il modello conosce il principio e non riesce ad applicarlo al confine di implementazione giusto. Aggiungi il corpus (il codice pubblico è pieno di pattern insicuri), l'assenza (la sicurezza è una guardia che nessuno ha chiesto) e il lettore (chi scrive il prompt spesso non sa valutarla). Nessuno di questi si risolve con un modello più intelligente.
Posso semplicemente chiedere all'AI di controllare il proprio codice per le vulnerabilità?
Aiuta un po' e non basta. Lo stesso modello che ha scritto il codice ne condivide i punti ciechi: non conosce il tuo modello di autorizzazione né il confine di tenant, non vede gli altri finding intorno alla riga, ed è ugualmente sicuro della versione insicura e di quella sicura. SusVibes ha testato la scorciatoia ovvia: arricchire la richiesta di funzionalità con indizi di vulnerabilità non ha mitigato i problemi di sicurezza. Un controllo affidabile ha bisogno di segnale esterno, scansione consapevole della reachability e le tue regole come verità di base.
Quali sono le vulnerabilità più comuni nel codice generato dall'AI?
Injection (CWE-89, CWE-78), autorizzazione rotta e IDOR (CWE-862, CWE-639), segreti hardcoded (CWE-798), validazione dell'input mancante (CWE-20), deserializzazione insicura (CWE-502) e falle di logica di business. Quattro di queste sei classi corrispondono a voci della CWE Top 25 del 2025, e OWASP mette il broken access control al primo posto per il 2025, riportando che il 100% delle applicazioni testate ne presentava una qualche forma. Le prime cinque sono rilevabili da buoni scanner quando filtri per reachability; l'ultima, la logica di business, è quella pericolosa perché nessuno scanner è fatto per cogliere una regola sintatticamente perfetta e semanticamente sbagliata.
Come rendo sicuro il codice generato dall'AI?
Sposta il controllo al momento della generazione: carica le tue regole di sicurezza e di business nell'agente così che scriva per primo il pattern sicuro, esegui scansioni in continuo e riporta i finding confermati all'agente perché li corregga, e tieni un gate SAST in CI più la revisione umana come rete di sicurezza. Scrivere le regole in un file del repository non basta: Anthropic dice che Claude lo tratta come contesto, non come configurazione imposta.