


Nesta página
- O que envia o Codex à OpenAI, ao certo?
- A OpenAI treina os modelos com o teu código?
- O que guarda o Codex no teu computador?
- O Codex rouba código?
- Como manter segredos e código regulado fora do alcance do Codex?
- O que nenhuma definição de privacidade resolve
- Perguntas frequentes
- A OpenAI vê o meu código quando uso o Codex?
- A OpenAI usa o meu código para treinar os modelos?
- Como impedir que a OpenAI treine com o meu código?
- O Codex armazena dados no meu computador?
- O Codex consegue ler o meu .env?
- Os dados do Codex podem ficar na Europa?
- O Codex é seguro para o código da minha empresa?
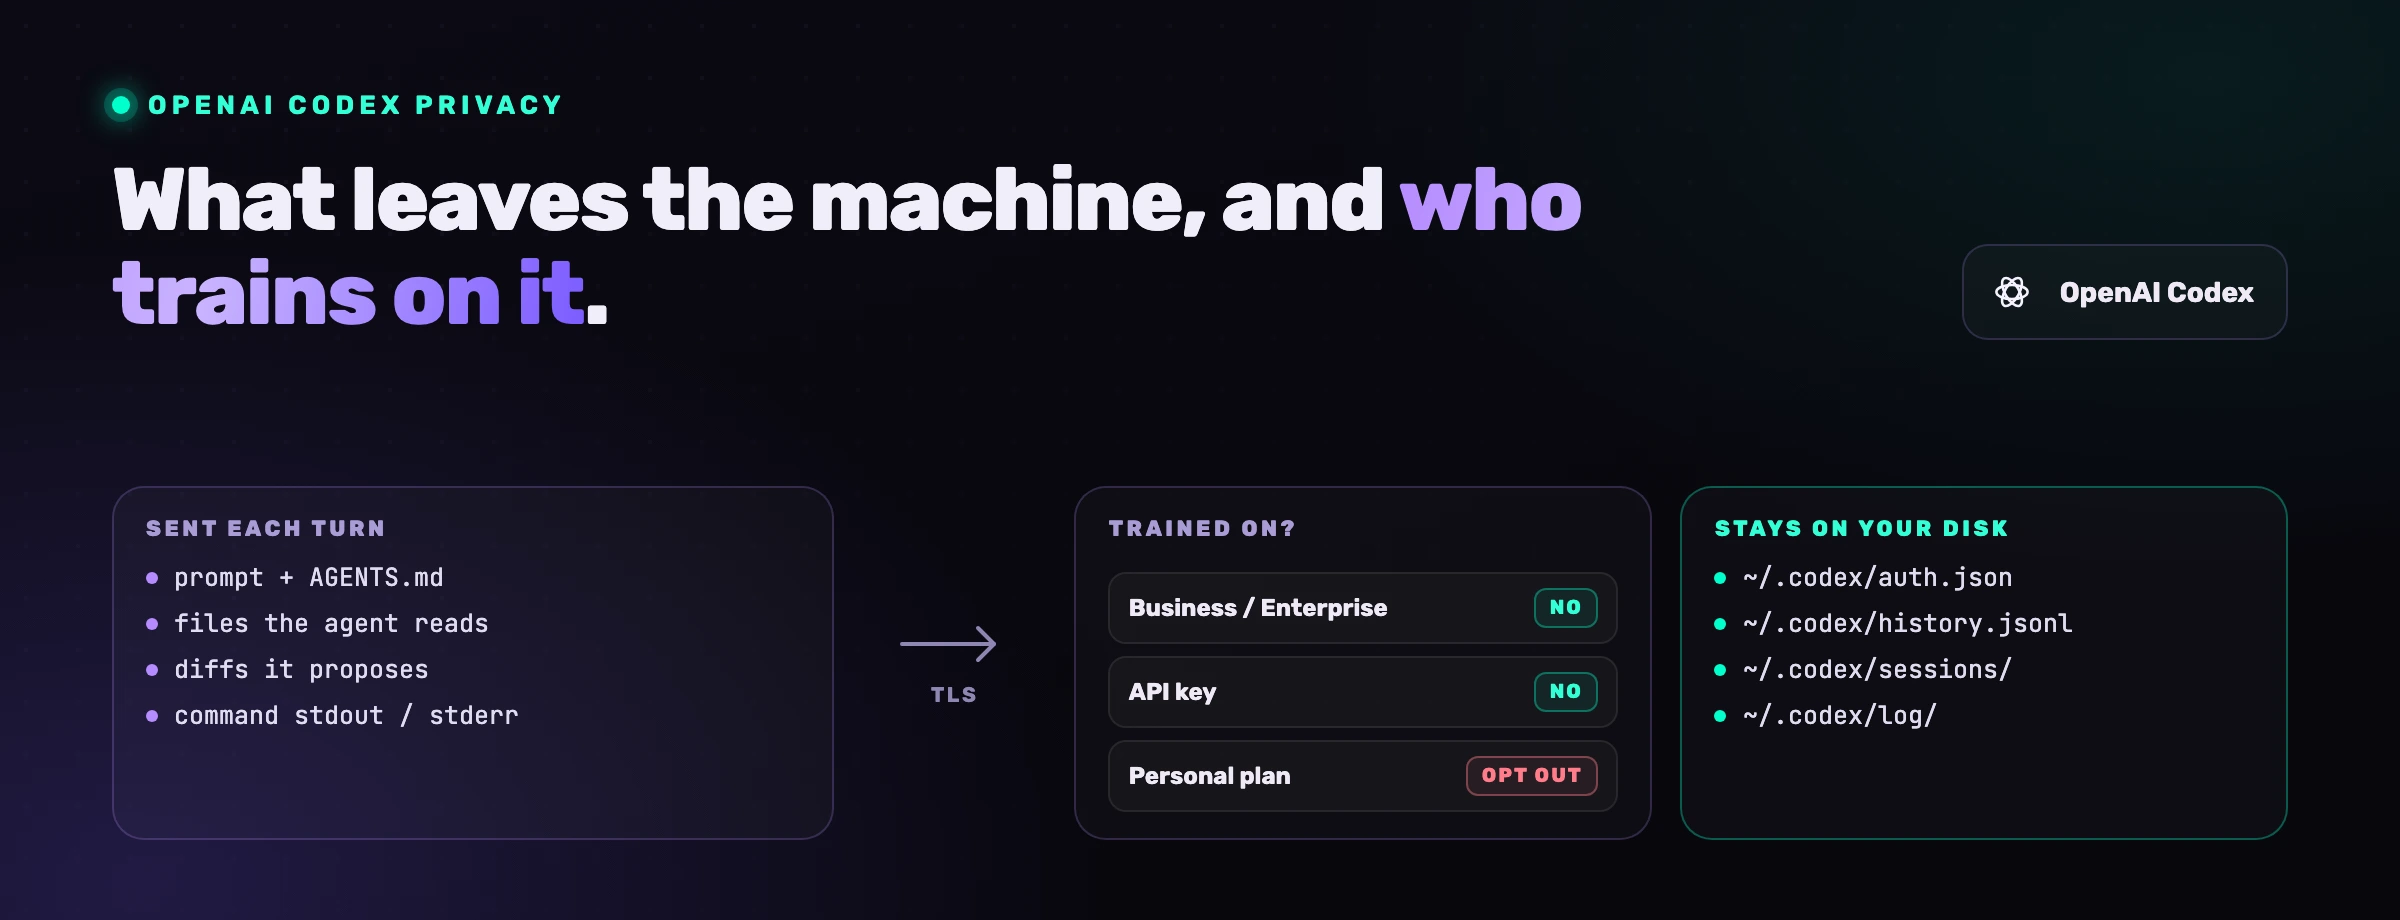
Sim, o OpenAI Codex envia código para a OpenAI, e não podia ser de outra maneira: o agente só funciona porque o prompt, os ficheiros que decide ler, os diffs que propõe e a saída dos comandos que executa chegam aos modelos da OpenAI. Assente isto, as perguntas que valem a pena são mais finas. O que sai exatamente da máquina e o que fica no teu disco, em ~/.codex. Se a OpenAI treina com esse conteúdo, e aí tudo depende da conta com que iniciaste sessão. O que é retido, e durante quanto tempo. E que interruptores deixam os segredos e o código regulado fora do alcance do agente. Este guia responde a cada uma delas e aponta, de cada vez, a definição que manda.
O que envia o Codex à OpenAI, ao certo?
O Codex envia à OpenAI tudo aquilo de que precisa para raciocinar sobre a tarefa, e nada do que nunca abriu. É a própria OpenAI que o mostra, no artigo de engenharia sobre o ciclo do agente do Codex: em cada turno, a CLI envia à API Responses o prompt que escreveste, os ficheiros de instruções como o AGENTS.md, uma breve descrição do ambiente (diretório de trabalho e shell) e a saída de todas as chamadas a ferramentas feitas até ali. É por esta última via que seguem o conteúdo dos ficheiros que o agente escolheu ler, os diffs que propõe, o stdout e o stderr dos comandos que correu e aquilo que esses comandos mostrarem do repositório (caminhos, estado do git, estrutura). No Codex cloud a fronteira é outra: o Codex cria um contentor e faz o checkout do teu repositório do lado da OpenAI, e tudo o que estiver nesse checkout está ao alcance.
Um ficheiro que o agente nunca leu, esse, não segue para lado nenhum. É por isso que, na prática, a privacidade se joga no alcance: aquilo que o agente pode abrir e aquilo que lhe dizes para não abrir.
| Onde usas o Codex | O que sai da máquina | Onde corre o modelo | Que condições valem |
|---|---|---|---|
| CLI ou extensão de IDE, com a conta ChatGPT | Prompt, ficheiros lidos, diffs, saída dos comandos, metadados | Na OpenAI, no âmbito do teu workspace ChatGPT | As do teu plano ChatGPT (pessoal ou Business/Enterprise/Edu) |
| CLI ou SDK, com chave de API | O mesmo, mais a telemetria opcional que configurares | Na API da OpenAI | Os controlos de dados da API (sem treino por predefinição) |
| Codex cloud | A tarefa e o repositório inteiro, descarregado do teu servidor Git para o contentor | Numa sandbox alojada pela OpenAI | As do teu plano ChatGPT |
codex exec local, em CI | O mesmo que na CLI, sem ninguém a assistir | Na OpenAI | As da credencial que o runner usar |
Há dois passageiros com que quase ninguém conta. O primeiro são as variáveis de ambiente: a shell em que o agente corre os comandos vê-as todas, e um DATABASE_URL ou um AWS_SECRET_ACCESS_KEY exportado nessa shell pode aparecer na saída de um comando e seguir viagem com ela. A shell_environment_policy do Codex decide que variáveis chegam a essa shell, e não tira nenhuma enquanto não lho pedires: segundo a referência de configuração da OpenAI, as variáveis cujo nome contém KEY, SECRET ou TOKEN são mantidas por predefinição.
O segundo são as pesquisas. Com web_search em live (a flag --search), as consultas que o modelo compõe também saem. O modo por predefinição, cached, recorre a um índice mantido pela OpenAI e não acede à web externa. A mesma referência avisa, porém, que com --yolo, ou com outra definição de sandbox de acesso total, essa predefinição passa a live.
A OpenAI treina os modelos com o teu código?
A OpenAI treina ou não os modelos com o teu código consoante a conta com que entraste no Codex, e não consoante a superfície que usas. A política de utilização de dados da OpenAI trata o Codex como o resto da gama, serviços para particulares de um lado e serviços para empresas do outro, com uma exceção: um interruptor que só o Codex tem.
| Como usas o Codex | Treina por predefinição? | Como se muda |
|---|---|---|
| Workspace ChatGPT Business, Enterprise ou Edu | Não, segundo a página de privacidade empresarial da OpenAI | Controlos do administrador do workspace; só por opt-in |
| Chave de API (CLI ou SDK do Codex) | Não. Os controlos de dados da API da OpenAI dizem: «Desde 1 de março de 2023, os dados enviados para a API da OpenAI não são usados para treinar nem melhorar os modelos da OpenAI (a menos que optes explicitamente por partilhar dados connosco)» | Só por opt-in |
| Plano pessoal (Free, Go, Plus, Pro) | Pode treinar, a menos que recuses | Nas definições do ChatGPT (Settings), em Controlos de dados (Data Controls), a opção «Melhorar o modelo para todos»; ou no portal de privacidade da OpenAI. Basta uma das duas vias |
| Ambientes completos do Codex (planos pessoais) | Controlo à parte | Nas definições do Codex, o interruptor de treino com ambientes completos |
É na última linha que quase toda a gente tropeça. As perguntas frequentes da OpenAI sobre os controlos de dados dizem duas coisas: que, num plano pessoal, a opção «Melhorar o modelo para todos» também se aplica às tuas tarefas no Codex, e que o Codex tem uma definição separada para o treino com ambientes completos, gerida nas definições do próprio Codex. Mexer na opção do ChatGPT ou no portal de privacidade não lhe toca.
Nenhuma das duas páginas diz qual é o valor por predefinição dessa definição do Codex. Na prática, um programador com plano Plus que desligou «Melhorar o modelo para todos» há anos não tem motivo nenhum para supor que o Codex foi atrás. Verifica os dois.
Há uma exceção que sobrevive à recusa, e a política de utilização de dados referida acima deixa-a por escrito: se enviares feedback sobre uma resposta, um polegar para cima ou para baixo, por exemplo, toda a conversa associada pode ser usada para treinar.
O que guarda o Codex no teu computador?
O Codex guarda no teu disco mais do que a maioria das pessoas imagina, e compensa conhecer os ficheiros pelo nome. O guia de configuração avançada da OpenAI enumera o que está dentro de ~/.codex: o config.toml (as tuas definições), o auth.json (as credenciais em cache, quando se usa o armazenamento em ficheiro; caso contrário, vão para o porta-chaves do sistema), o history.jsonl (aquilo a que o guia chama transcrições das sessões, ligadas por predefinição) e os logs, na pasta log/. Ao lado está a pasta sessions/, onde o Codex guarda cada conversa num ficheiro que consegue reproduzir e retomar.
Para a privacidade, o que conta são o history.jsonl e a pasta sessions/. Entre os dois têm lá dentro os teus prompts, as respostas do agente e a saída dos comandos, com todo o código e todos os segredos que por lá tenham passado, e ficam no disco até os apagares.
O que fica no disco e o que é exportado decide-se nestas chaves do config.toml:
# Não escrever as transcrições das sessões em ~/.codex/history.jsonl
[history]
persistence = "none"

# Nenhuma exportação de logs por OpenTelemetry; os prompts em bruto nunca saem
[otel]
exporter = "none"
log_user_prompt = false

# Tirar as credenciais da shell que o agente usa
[shell_environment_policy]
ignore_default_excludes = false  # tira também os nomes que contêm KEY, SECRET ou TOKEN

[shell_environment_policy.filters]
"AWS_*" = "exclude"
"DATABASE_URL" = "exclude"

# Analítica ao nível da máquina
[analytics]
enabled = false
Três precisões tiradas da documentação da OpenAI acompanham este bloco. history.persistence = "none" faz parar a escrita do history.jsonl, e mais nada: os ficheiros da pasta sessions/ são um mecanismo à parte, a referência de configuração não documenta nenhuma chave para eles, e a única forma documentada de os evitar é codex exec --ephemeral, que corre sem os escrever. A tabela filters é a forma atual da shell_environment_policy; o antigo array exclude continua a funcionar, mas a referência já o classifica como legado, e o Codex recusa a mistura dos dois. E a exportação de logs por OpenTelemetry vem desligada, ou seja, nada é exportado enquanto não a configurares, e otel.log_user_prompt é um opt-in explícito: só com ele é que os prompts em bruto entram nessa exportação.
Sobram dois canais, ambos ligados por predefinição: as métricas anónimas de utilização e de estado, que segundo a OpenAI não contêm dados que te identifiquem e que se desligam com analytics.enabled = false, e o comando /feedback (feedback.enabled).
Repara que nenhuma destas definições altera o que o modelo recebe. Alteram o que a tua máquina escreve e o que reencaminha.
O Codex rouba código?
Não, o Codex não rouba código, e a pergunta merece uma resposta exata em vez de uma resposta que sossega. O Codex transmite o teu código à OpenAI nas condições do plano com que iniciaste sessão, e essas condições são públicas: é um fluxo de dados que aceitaste, não um roubo.
Os dois incidentes que puseram tanta gente a pesquisar isto também não foram o Codex a levar código a ninguém. O primeiro envolve o codexui-android, uma interface web remota para o Codex publicada no npm, que funcionava a sério, com desenvolvimento ativo e alguns milhares de transferências por semana. Como o The Hacker News noticiou a 1 de junho de 2026, as versões publicadas andavam há perto de um mês a ler o ~/.codex/auth.json em cada arranque e a enviá-lo para o servidor de um atacante, com código que nunca esteve no repositório do GitHub. O segundo foi uma falha de injeção de comandos no ambiente cloud do Codex, descoberta pela BeyondTrust Phantom Labs e noticiada pelo The Hacker News em março de 2026: um nome de branch forjado bastava para roubar o token do GitHub que o Codex usa, e a BeyondTrust aponta como afetados o site do ChatGPT, a CLI do Codex, o SDK e a extensão de IDE. A OpenAI já a corrigiu.
O padrão repete-se nos dois casos. O alvo eram as credenciais à volta do Codex, e quem atacava era um terceiro. É para aí que deves olhar. O guia de autenticação da OpenAI manda tratar o ~/.codex/auth.json como uma palavra-passe, e com cli_auth_credentials_store = "keyring" os tokens passam para o porta-chaves do sistema, pelo que o ficheiro deixa de lá estar para ser lido. Verifica o que instalas, sabendo que um repositório limpo não prova nada sobre o pacote que o registry realmente serve, e perante qualquer extra para o Codex desconfia tanto como desconfiarias de uma extensão do browser que te pede a palavra-passe.
Há uma terceira maneira de perder código, e para essa ninguém escreve relatório de incidente. É a prompt injection escondida num repositório que clonaste, a mandar o agente despachar os teus ficheiros com curl para um sítio qualquer, numa sessão em que a rede estava aberta. É exatamente por isto que a sandbox workspace-write do Codex mantém a rede fechada por predefinição, e o guia da OpenAI sobre a sandbox e as aprovações di-lo sem rodeios: por predefinição, o agente corre com o acesso à rede desligado. Que flags a abrem, e em que casos isso se aceita, está explicado no nosso guia sobre as flags de sandbox e de aprovação do Codex.
Como manter segredos e código regulado fora do alcance do Codex?
Para manter segredos e código regulado fora do alcance do Codex, encolhe o que o agente pode abrir e faz com que aquilo que abre não tenha interesse nenhum. Por ordem de impacto:
- Nada de segredos em ficheiros que o agente consiga ler. Um
.envcom chaves verdadeiras, umconfig/production.ymlcom a palavra-passe da base de dados, umcredentials.jsonperdido na árvore: estando no workspace, o agente pode lê-lo, e daí a ir parar a uma transcrição é um passo. Usa um gestor de segredos e injeta-os em tempo de execução. - Limpa a shell. Uma
shell_environment_policycomignore_default_excludes = falsee entradasfiltersemexcludepara chaves, tokens e strings de ligação impede que a saída dos comandos os deixe escapar. - Rede fechada. Deixa
sandbox_workspace_write.network_accessemfalse. No dia em que uma tarefa precisar mesmo do registry, abre-a só para essa execução, com-c. - Marca como não confiável o repositório em que não confias. Com
projects."<path>".trust_level = "untrusted", a referência de configuração da OpenAI indica que o Codex salta as camadas.codex/que o próprio repositório traz, com a configuração local, os hooks e as regras, e um projeto clonado deixa de poder reconfigurar o agente contra ti. - Sem transcrições locais em máquinas partilhadas ou reguladas.
history.persistence = "none", mais uma limpeza agendada de~/.codex/sessions/, que essa chave não cobre. Em CI, usacodex exec --ephemeral. - Escolhe a superfície em função dos dados. Código sob NDA, uma base de código regulada, fixtures com dados de clientes: para tudo isso, um workspace Business ou Enterprise, ou uma chave de API. Para quem usa a API com obrigações mais apertadas, os controlos de dados da API da OpenAI documentam três coisas. Os logs de monitorização de abusos ficam retidos «até 30 dias» por predefinição, ou mais se a lei o exigir. A opção Zero Data Retention exclui o conteúdo do cliente desses logs nos endpoints elegíveis, entre os quais
/v1/responses, e a OpenAI só a concede mediante aprovação prévia, não a simples pedido. A residência de dados também depende de elegibilidade: a região da Europa (EEE e Suíça) exige Zero Data Retention ou outro dos controlos de retenção reduzida da OpenAI, e não abrange os dados de sistema, como os metadados de conta e de utilização. - Procura os segredos antes que o agente os veja. Uma chave em commit que um scanner assinala hoje é uma chave que a próxima sessão já não carrega para o contexto.
O que nenhuma definição de privacidade resolve
Todos os controlos que viste até aqui tratam do que o Codex lê e transmite. Nenhum trata do que o Codex escreve de volta, e o código que ele escreve é, por si só, uma superfície de privacidade.
Pensa num agente que escreve diretamente no código um token que viu numa fixture, que manda para os logs o corpo inteiro de um pedido com um número de cartão lá dentro, ou que devolve um registo de utilizador com campos que quem chamou nunca teve autorização para ver. Esse agente criou um problema de proteção de dados que nenhuma política de retenção resolve, porque a fuga passou a morar no teu repositório e nos teus logs de produção.
É essa a camada que o VibeDefend acrescenta em agent-time. Fica dentro do ciclo do Codex e confronta com as tuas regras o diff que o agente está prestes a escrever. O segredo escrito no código, a linha de log que diz demasiado e a verificação de autorização que falta são reescritos antes de aterrarem. A guarda do VibeDefend decide localmente, na tua máquina, a telemetria resume-se a metadados estruturados, e a análise corre em modelos alojados por nós, na região UE ou EUA que escolheres na instalação, sem nenhuma API de LLM de terceiros e sem que o teu código sirva para treinar um modelo. No nosso estudo controlado, o agente com esta camada aplicou a regra exata em 89 % dos casos (57 de 64 regras avaliadas), contra 12 % sem ferramenta nenhuma e 13 % com um ficheiro de regras mantido à mão no repositório.
Para o quadro completo, com os riscos de sandbox, de supply chain e de autonomia, lê o guia completo de segurança do OpenAI Codex. E se a tua equipa está a adotar o Codex em código que tem de ficar dentro de portas, fala connosco: já fizemos esta configuração muitas vezes.
Perguntas frequentes
A OpenAI vê o meu código quando uso o Codex?
Sim. Em cada turno seguem para os modelos da OpenAI o prompt, os ficheiros que o agente lê, os diffs que propõe, a saída dos comandos e os metadados do repositório, e no Codex cloud o repositório inteiro é descarregado para um contentor alojado pela OpenAI. Um ficheiro que o agente nunca abre nunca é enviado, e é por isso que limitar o alcance do agente é a principal alavanca de privacidade.
A OpenAI usa o meu código para treinar os modelos?
Por predefinição não, se usares o Codex através de um workspace ChatGPT Business, Enterprise ou Edu, ou com uma chave de API. Num plano pessoal pode usar, enquanto não recusares: a opção «Melhorar o modelo para todos» do ChatGPT aplica-se ao Codex, e o Codex tem nas suas próprias definições um interruptor separado, o do treino com ambientes completos, que também tens de verificar.
Como impedir que a OpenAI treine com o meu código?
Num plano pessoal são dois passos. Primeiro desliga «Melhorar o modelo para todos» nos Controlos de dados do ChatGPT, os Data Controls (ou usa o portal de privacidade da OpenAI). Depois abre as definições do Codex e desliga o controlo de treino com ambientes completos, porque o primeiro passo não mexe no segundo. A alternativa é entrar com um workspace Business ou Enterprise, ou com uma chave de API, onde o treino já vem desligado.
O Codex armazena dados no meu computador?
Sim. Por predefinição guarda as transcrições das sessões em ~/.codex/history.jsonl, e além delas as credenciais em ~/.codex/auth.json (a não ser que uses o porta-chaves do sistema), um ficheiro reproduzível por sessão em ~/.codex/sessions/ e os logs em ~/.codex/log/. Definir history.persistence = "none" no config.toml só trava o history.jsonl: os ficheiros de sessão pedem a sua própria limpeza, ou codex exec --ephemeral nas execuções por script.
O Codex consegue ler o meu .env?
Consegue, se o ficheiro estiver no workspace e o modo de sandbox permitir leituras. E tanto read-only como workspace-write permitem: só as escritas é que ficam confinadas. Mantém os segredos verdadeiros fora da árvore e usa a shell_environment_policy para os tirar da shell em que o agente corre comandos.
Os dados do Codex podem ficar na Europa?
No uso pela API, a OpenAI documenta regiões de residência de dados que incluem a Europa (EEE e Suíça), a par de uma opção Zero Data Retention nos endpoints elegíveis e de uma retenção por predefinição de até 30 dias para a monitorização de abusos. As duas opções dependem de elegibilidade e da aprovação da OpenAI, a região da Europa exige um controlo de retenção reduzida como a Zero Data Retention, e a residência não abrange os dados de sistema. Já o local onde são tratados os dados do teu workspace ChatGPT depende do contrato do workspace. Se trabalhas com cargas reguladas, RGPD incluído, confirma-o junto da OpenAI.
O Codex é seguro para o código da minha empresa?
Pode ser, com a identidade e a configuração certas: uma superfície sem treino (Business, Enterprise ou chave de API), os segredos fora do workspace, a rede fechada, os repositórios não confiáveis marcados como tal e as transcrições locais desligadas quando a máquina é partilhada. Fica a faltar o código que o próprio agente escreve, e esse precisa de uma camada de revisão só para ele.


