

Nesta página
- O que é o OpenAI Codex e porque é que muda o modelo de segurança?
- Como funciona o modelo de segurança do Codex
- Os 6 principais riscos de segurança no OpenAI Codex
- 1. Injeção de comandos e execução remota de código
- 2. Cadeia de abastecimento e dependências maliciosas
- 3. Injeção de prompt e escrita de exploits orientada
- 4. Modos de sandbox e de aprovação demasiado permissivos
- 5. Retenção de dados e privacidade
- 6. Autonomia em escala
- O que a segurança nativa do Codex cobre, e o que não cobre
- Boas práticas para proteger o OpenAI Codex
- Onde os controlos nativos param: proteger o agente no momento do prompt
- Perguntas frequentes
- O OpenAI Codex é seguro?
- Qual é a diferença entre Codex e "Codex Security"?
- O Codex corre código num ambiente isolado (sandbox)?
- O Codex pode vazar o meu token GitHub ou credenciais?
- O Codex envia o meu código para a OpenAI?
- Que modo de sandbox/aprovação do Codex devo usar?
- Em que é que a segurança do Codex difere da do Claude Code, Cursor ou GitHub Copilot?
O OpenAI Codex não é um autocompletar. Lê o teu repositório, edita ficheiros por toda a árvore, corre comandos de shell e abre pull requests em teu nome, a partir do terminal, do IDE, da cloud e através de um SDK. É isso que o torna útil, e é também isso que faz dele uma superfície de ataque que nenhum assistente de IDE alguma vez foi. O ambiente isolado (sandbox), os modos de aprovação e as predefinições de rede do Codex reduzem o risco de forma significativa. Não o eliminam. Este guia cobre os riscos reais, aquilo de que os controlos nativos protegem de facto, as boas práticas que fecham a lacuna e a única camada que o modelo nativo parte do princípio de que já tens.
O que é o OpenAI Codex e porque é que muda o modelo de segurança?
O OpenAI Codex é a ferramenta de código agêntica da OpenAI. Está onde o programador já trabalha: uma CLI Codex no terminal, uma extensão de IDE, um modo de cloud e multi-agente que corre tarefas de forma assíncrona e um SDK para ligar o Codex à tua própria automação. Age a partir de instruções em linguagem natural: analisar uma base de código, gerar uma funcionalidade, correr os testes, corrigir as falhas, abrir um pull request. Liga-se ao GitHub, corre ao lado dos sistemas de build e pode ser apontado a um repositório e deixado a trabalhar sozinho.
Antes de mais, um esclarecimento sobre os nomes, porque quase toda a gente que pesquisa este tema tropeça aqui. Neste artigo, "Codex" quer dizer o agente de código (CLI, extensão de IDE, cloud e SDK). À parte, a OpenAI lançou uma funcionalidade chamada literalmente Codex Security: um agente que se liga a um repositório, constrói um modelo de ameaças específico dessa base de código, analisa o histórico de commits, valida as vulnerabilidades candidatas num ambiente isolado e propõe correções para revisão humana. É fácil confundir os dois. Este guia trata de proteger o agente de código Codex. O Codex Security, a capacidade da própria OpenAI para encontrar vulnerabilidades, é abordado brevemente mais abaixo como um apoio, não como um programa de segurança completo.
É essa natureza agêntica que parte o velho modelo de segurança. Um assistente de IDE tradicional sugere código; um humano aceita ou rejeita cada sugestão. O raio de impacto de uma má sugestão é um bloco de código que um programador ainda tem de colar. O Codex, pelo contrário, executa ações. Lê ficheiros que não indicaste, executa comandos que não escreveste, edita código por toda a árvore e, em modo de cloud, pode correr durante muito tempo sem ninguém a vigiar. A superfície de ataque já não é "que código sugeriu o modelo". É "o que pode este agente fazer com o acesso que tem, e quem consegue influenciar as instruções que recebe".
Uma sugestão é um rascunho que um humano escolhe aceitar. Uma ação é algo que já aconteceu. O modelo de segurança tem de deixar de rever rascunhos e passar a restringir ações.
Há uma segunda mudança que pesa ainda mais, e tem que ver com a velocidade. O pull request tornou-se a casa da segurança de aplicações porque funcionava à cadência humana: uma pessoa abrandava, lia o diff e só depois fazia o merge. O Codex, sobretudo em modo de cloud e multi-agente, não trabalha à cadência humana. Uma única sessão pode entregar mais código numa tarde do que um revisor lê numa semana. A partir daí, o diff deixa de ser um ponto de controlo e passa a ser a ata de decisões já tomadas. Qualquer controlo que só atue no pull request está a rever o passado, não a evitá-lo.
Para a maioria das equipas, a pergunta prática não é se o Codex tem proteções nativas. Tem, e estão bem pensadas. A pergunta é se essas proteções chegam para o dia a dia. A resposta honesta é não. As próprias orientações "Running Codex safely" da OpenAI apresentam o ambiente isolado (sandbox) e as aprovações como defesa em profundidade, e não como uma fronteira completa, e no instante em que passas para o modo full-access ou ativas o acesso de rede no sandbox, essas proteções caem, e é de propósito. Adotar o Codex em segurança continua a depender de permissões, disciplina de sandbox, supervisão humana e validação independente do código, das dependências e das pipelines.
Como funciona o modelo de segurança do Codex
O modelo do Codex assenta em três ideias: correr o trabalho dentro de um ambiente isolado (sandbox), perguntar antes de fazer o que quer que saia dele e manter a rede fechada, a menos que a abras. Na prática, isso traduz-se num punhado de controlos.
Ambiente isolado (sandbox) ao nível do SO
O Codex corre os comandos dentro de um sandbox do sistema operativo imposto pela plataforma (Seatbelt no macOS, Landlock e seccomp no Linux, um sandbox próprio no Windows). As predefinições limitam as escritas ao workspace ativo e, na cloud, desativam por completo o acesso de rede. É o sandbox que impede um comando descontrolado de mexer no resto da máquina.
Modos de aprovação e de sandbox
O Codex oferece uma pequena escada de presets. read-only só corre automaticamente leituras reconhecidamente seguras. auto (o sandbox workspace-write com aprovação a pedido) deixa-o ler, editar e correr comandos de rotina dentro do workspace, e pergunta antes de tudo o que for mais arriscado. full-access (danger-full-access) elimina a fronteira por completo. --ask-for-approval regula a frequência com que ele para, até never.
Rede desligada por omissão
No ambiente de cloud, o acesso de rede de saída está desativado a menos que o atives explicitamente. Dentro do sandbox local workspace-write, o acesso de rede é uma opção configurável que vem desligada. É a predefinição mais importante de todas, porque a maioria dos caminhos de exfiltração precisa da rede para sair da caixa.
Codex Security (assistivo)
O agente Codex Security, um produto separado da OpenAI, constrói um modelo de ameaças a partir do teu repositório, analisa o histórico, valida as descobertas em isolamento e propõe correções para revisão. É um par de olhos extra útil sobre o código que o Codex (ou qualquer outro) escreve, e não um controlo em tempo de execução sobre o que o agente de código faz.
É uma base realmente bem pensada, e a maior parte desta lista não existia nos assistentes de IDE de há uma geração. A armadilha é tomá-la por uma fronteira de segurança acabada. A OpenAI diz com todas as letras que o modo auto é um meio-termo e não uma garantia, que full-access e a flag --dangerously-bypass-approvals-and-sandbox retiram o sandbox de propósito e que ativar o acesso de rede dentro do sandbox é trocar deliberadamente segurança por capacidade. Cada controlo desta lista tem uma forma documentada de ser desligado, e a próxima secção mostra o que acontece quando o desligas, ou quando um atacante o desliga por ti.
Os 6 principais riscos de segurança no OpenAI Codex
Os riscos abaixo não são teóricos. Correspondem a vulnerabilidades documentadas, a investigação publicada e ao OWASP Top 10 para Aplicações LLM. Os números que os enquadram são os mesmos que todas as equipas de AppSec citam hoje.
do código gerado por IA era vulnerável em cenários de segurança do MITRE Top-25 (NYU, Asleep at the Keyboard)
injeção de prompt, o principal risco LLM pelo 3.º ano consecutivo (OWASP LLM01)
das soluções de agentes de código de IA eram seguras, face a 61% funcionalmente corretas (Carnegie Mellon SusVibes)
1. Injeção de comandos e execução remota de código
O Codex escreve e corre código ao nível do sistema, por isso uma falha na forma como trata os seus próprios inputs transforma-se num caminho para a execução de código. Não é uma hipótese. A BeyondTrust Phantom Labs divulgou uma vulnerabilidade crítica de injeção de comandos no OpenAI Codex que permitia roubar GitHub User Access Tokens, com o payload metido às escondidas num nome de branch do GitHub e escondido da interface com caracteres Unicode invisíveis. Como estava no pedido de criação de tarefas, afetava ao mesmo tempo o site do ChatGPT, a CLI Codex, o SDK Codex e a extensão de IDE Codex.
A OpenAI corrigiu-a (um primeiro hotfix menos de uma semana depois do relatório de dezembro de 2025, proteções de shell reforçadas e âmbito dos tokens reduzido até ao início de 2026, com a classificação final de Critical Priority 1), por isso este bug em concreto está fechado. Continua a ser o exemplo mais claro da superfície: um agente que executa comandos de shell em teu nome transforma qualquer input não sanitizado que lê, um nome de branch, um nome de ficheiro, uma resposta de ferramenta, num potencial ponto de injeção. O perigo cresce quando o agente corre com acesso amplo à shell e num modo permissivo, porque uma sequência de comandos inofensivos um a um pode instalar uma dependência, alterar uma configuração de CI ou abrir um mecanismo de persistência.
2. Cadeia de abastecimento e dependências maliciosas
O Codex instala pacotes, clona repositórios e corre scripts de configuração no decorrer do trabalho normal, e a sua própria popularidade fez dele um alvo. O TechRadar e outros meios noticiaram o caso de um pacote npm, codexui-android, que se fazia passar por uma UI remota para o Codex, chegou a cerca de 29 000 downloads e, depois de uma primeira versão limpa, publicou uma atualização que enviava em silêncio o conteúdo do ficheiro de credenciais do Codex (~/.codex/auth.json), tokens de acesso, de refresh e de ID, para um servidor controlado pelo atacante. Como o token de refresh não expira, uma única instalação comprometida pode dar acesso persistente e silencioso.
Esse incidente faz parte de um padrão mais amplo. Ao longo de 2025 e já em 2026, as campanhas de typosquatting e de imitação no npm visaram cada vez mais as ferramentas de código de IA e os seus ecossistemas. O próprio fluxo de desenvolvimento torna-se o vetor de ataque: um package.json envenenado, um hook de post-install malicioso ou um helper com typosquatting podem transformar um banal prompt "configura este repositório" num roubo de credenciais. A alucinação de pacotes agrava o problema: um agente que inventa com toda a confiança um nome de pacote plausível mas inexistente deixa a um atacante um nome livre para registar e transformar em arma.
3. Injeção de prompt e escrita de exploits orientada
A injeção de prompt é o risco que define as ferramentas de código agênticas, e é o risco LLM número um da OWASP pelo terceiro ano consecutivo (LLM01). Um atacante esconde instruções em algo que o agente lê, um ficheiro, uma página web, uma issue, o README de uma dependência, a saída de uma ferramenta, e o agente segue-as, por cima do comportamento previsto.
O contexto agêntico agrava as consequências, porque o Codex não se limita a responder: age e escreve código ao nível do sistema. Um agente manipulado pode ser levado a escrever um exploit, enfraquecer uma verificação de autorização, acrescentar um caminho de desserialização insegura ou montar uma backdoor que um revisor cansado lê como código correto. A forma perigosa é a indireta: não precisas de colar um prompt malicioso, basta apontares o Codex a um repositório envenenado ou deixá-lo consumir a saída de ferramentas hostis. Como um modelo de linguagem não consegue distinguir com fiabilidade uma instrução de confiança de uma instrução maliciosa embutida nos dados, a injeção pode levar à execução de comandos, à exfiltração de dados ou à manipulação silenciosa do código.
4. Modos de sandbox e de aprovação demasiado permissivos
A segurança do Codex assenta no sandbox e nos pedidos de aprovação, e ambos se podem afrouxar com uma única flag. Escolher full-access (danger-full-access), ou ativar o acesso de rede de saída dentro do sandbox workspace-write, troca a proteção por capacidade, e a OpenAI di-lo claramente. Com o sandbox aberto e a rede acessível, o mesmo agente que há pouco estava contido passa a poder escrever fora do workspace e enviar dados para qualquer lado.
Na prática, o que desgasta isto é a fadiga de aprovações. Quando o agente para vezes sem conta, as pessoas recorrem a --ask-for-approval never, ou ao preset full-auto, para que os pedidos desapareçam. Numa semana, a predefinição cuidadosa transformou-se, sem ninguém dar por isso, numa autorização geral, e ninguém decidiu que assim fosse. Ao nível da equipa é pior: um programador trabalha em read-only, outro em full-access porque numa sexta-feira dava mais jeito, e no momento em que partilham um repositório ou um fluxo automatizado, é a configuração mais fraca que define a verdadeira postura de todos.
5. Retenção de dados e privacidade
O Codex é útil porque tem contexto, e esse contexto inclui muitas vezes mais do que o ficheiro que tens à frente: código vizinho, configuração, variáveis de ambiente e, por vezes, credenciais. Os agentes geram e transmitem grandes quantidades de código privado em série, prompt após prompt, tarefa após tarefa. Para bases de código sensíveis ou reguladas, a pergunta certa não é apenas "a ligação está cifrada?", mas "o que fica guardado, durante quanto tempo, onde e quem lhe consegue chegar?".
A exposição é muitas vezes mais indireta do que espetacular. Ao resumir um repositório ou ao depurar um erro, o agente pode deixar escapar um token ou um endpoint interno numa saída que acaba depois num pull request, num ticket ou num chat, onde fica muito depois de a sessão terminar. As organizações que adotam o Codex em grande escala devem rever os termos de tratamento e de retenção de dados da OpenAI para a superfície que usam (a API e os tiers Business e Enterprise não são iguais), manter os segredos e os dados regulados fora do alcance do agente e partir do princípio de que tudo o que o agente emite pode ficar registado.
6. Autonomia em escala
A capacidade que torna o Codex apelativo, lançar uma tarefa e voltar para encontrar um pull request pronto, é também a que alarga a lacuna de revisão. Em modo de cloud e multi-agente, o Codex pode fazer alterações grandes e abrangentes em muitos ficheiros com pouca atenção humana pelo meio. Quanto mais autónoma e longa for a tarefa, maior o diff, e menor a parte dele que um humano lê de facto antes de aprovar.
Isso pesa na segurança porque a janela para uma alteração insegura ou maliciosa entrar cresce com o tamanho do diff que ninguém leu. Uma regressão subtil de autorização, uma dependência injetada ou uma validação enfraquecida em silêncio passam despercebidas com muito mais facilidade numa alteração autónoma de 2 000 linhas do que numa de 20 linhas que um programador escreveu deliberadamente. A autonomia não cria tanto novas classes de vulnerabilidade como elimina o atrito natural que costumava apanhá-las, e é precisamente por isso que os controlos abaixo se apoiam tanto na revisão, na delimitação e na governação no momento do prompt.
O que a segurança nativa do Codex cobre, e o que não cobre
Os controlos nativos são reais, e convém ser preciso sobre a fronteira entre o que resolvem e o que deixam a teu cargo.
O verdadeiro trabalho está na coluna da direita. Os controlos nativos são a base mínima: o sandbox e a predefinição de rede impedem que um erro honesto, ou um único comando manipulado, se transforme num desastre à escala da máquina. Não foram pensados para travar um adversário determinado que controla os inputs do agente, e a OpenAI não diz que foram. Tudo o que faz passar de "o Codex está instalado" a "o Codex está governado" está nas práticas que se seguem.
Boas práticas para proteger o OpenAI Codex
Estas nove práticas fecham a lacuna entre a base nativa e uma postura de segurança a sério. Nenhuma é exótica; a disciplina está em aplicá-las com consistência numa equipa que avança depressa.
-
Mantém o sandbox ligado e o full-access desligado. Usa por omissão
read-onlypara explorar eauto(workspace-write) para o trabalho a sério, e reservafull-access(danger-full-access) e--dangerously-bypass-approvals-and-sandboxpara contentores descartáveis. Confirma que o sandbox do SO está mesmo ativo em cada plataforma onde corres o Codex, e nunca o desatives numa máquina que consiga chegar a credenciais reais ou a hosts de produção. -
Deixa a rede fechada, a menos que uma tarefa precise mesmo dela. A predefinição da cloud, sem acesso de saída, é a proteção mais valiosa que o Codex traz, porque a exfiltração precisa normalmente da rede. Ativa o acesso de rede no sandbox
workspace-writesó para a tarefa concreta que o exige, limita-o a destinos conhecidos sempre que puderes e volta a desligá-lo no fim, em vez de o deixares aberto por hábito. -
Aplica o privilégio mínimo aos repositórios e aos tokens. Dá ao Codex acesso apenas aos repositórios de que uma tarefa precisa, prefere tokens GitHub efémeros e de âmbito estreito a tokens amplos e persistentes, e roda-os com regularidade em vez de esperares por um incidente. A divulgação da BeyondTrust lembra que um único token GitHub roubado pode chegar a todos os repositórios a que tem acesso: o âmbito do token é o âmbito da brecha.
-
Controla as dependências e os pacotes. Limita as instalações a registos de confiança ou a mirrors internos, exige aprovação para pacotes novos e analisa tudo com análise de composição de software. Não deixes o agente instalar sozinho pacotes obscuros ou não verificados, por mais confiança com que os sugira, verifica que um pacote sugerido existe de facto antes de o adicionares e desconfia em especial das ferramentas helper que envolvem o próprio Codex, que é exatamente onde se escondia o ladrão de tokens
codexui-android. -
Mantém um humano no circuito do código gerado. Trata a saída do Codex como um rascunho, não como uma implementação final, e ajusta a revisão ao tamanho da alteração. Faz passar o código gerado e alterado por revisão de pull request e testes automáticos, com atenção redobrada à autenticação, à validação de input e aos caminhos privilegiados. A questão não é desconfiar do modelo; é que um agente que produz milhares de linhas por dia, sobretudo em modo de cloud, produz falhas subtis mais depressa do que elas vêm à superfície por si.
-
Corre o trabalho não confiável em isolamento. Quando apontas o Codex a um repositório desconhecido, a uma issue de terceiros ou a qualquer coisa que não escreveste, corre-o num contentor ou numa VM sem segredos do host montados e sem caminho para a produção. A injeção de prompt indireta chega precisamente por este tipo de conteúdo, por isso a defesa mais barata é garantir que um agente manipulado não tem nada de valor ao alcance.
-
Mantém os segredos fora de alcance. Deixa os segredos em texto simples totalmente fora do contexto do agente: usa um cofre e injeta-os em tempo de execução, oculta os valores sensíveis nos logs e não deixes o agente ler ficheiros de credenciais ou conteúdos
.envde que não precisa. Protege o próprio ficheiro de credenciais do Codex (~/.codex/auth.json) como o alvo valioso que é e, se um segredo aparecer alguma vez numa transcrição ou numa saída, roda-o de imediato e investiga como lá foi parar. -
Restringe a autonomia em modo de cloud e multi-agente. Delimita bem as tarefas longas e assíncronas, prefere várias alterações fáceis de rever a uma única gigante e exige aprovação humana antes de uma branch escrita pelo Codex entrar em algo protegido. Quanto maior o diff autónomo, mais cuidada tem de ser a revisão, por isso define expectativas (e regras de proteção de branches) à medida do volume que o Codex consegue produzir.
-
Define a política por repositório e pela sensibilidade do ambiente. Classifica os repositórios (público, interno, regulado, produção) e aplica controlos mais apertados aos sensíveis: modos read-only ou bem delimitados, rede fechada, acesso a segredos negado, revisão mais exigente. Corre o Codex sobre sistemas críticos só em ambientes sem caminho direto para as credenciais de produção, e documenta a política para que os programadores saibam onde a ajuda da IA é permitida e com que restrições. Usa o Codex Security e o SAST tradicional como apoio a essa revisão, e não como substitutos dela.
Onde os controlos nativos param: proteger o agente no momento do prompt
Volta a percorrer os riscos e surge um padrão. O sandbox, os modos de aprovação e a etapa de revisão atuam todos sobre o que o agente já decidiu fazer, ou sobre código que já escreveu. Concentram-se à volta do pull request, porque é aí que a AppSec sempre viveu. Mas o PR só foi um ponto de controlo porque um humano o lia, e ao ritmo do agente, sobretudo em modo de cloud, já ninguém o lê do princípio ao fim.
O sítio para impor uma regra já não é o diff; é o prompt, antes de a linha insegura ser escrita. Qualquer regra que queiras que o agente siga tem de estar nas mãos dele no momento em que escreve, e não à espera num scanner que só chega quando o código já está em disco e o agente já passou à tarefa seguinte.
É essa a camada que o VibeDefend acrescenta. É uma CLI npm gratuita que se instala com um só comando e liga o OpenAI Codex (e também o Claude Code, o Cursor, o Devin Desktop e o VS Code Copilot) a quatro camadas de governação que correm dentro do ciclo do agente.
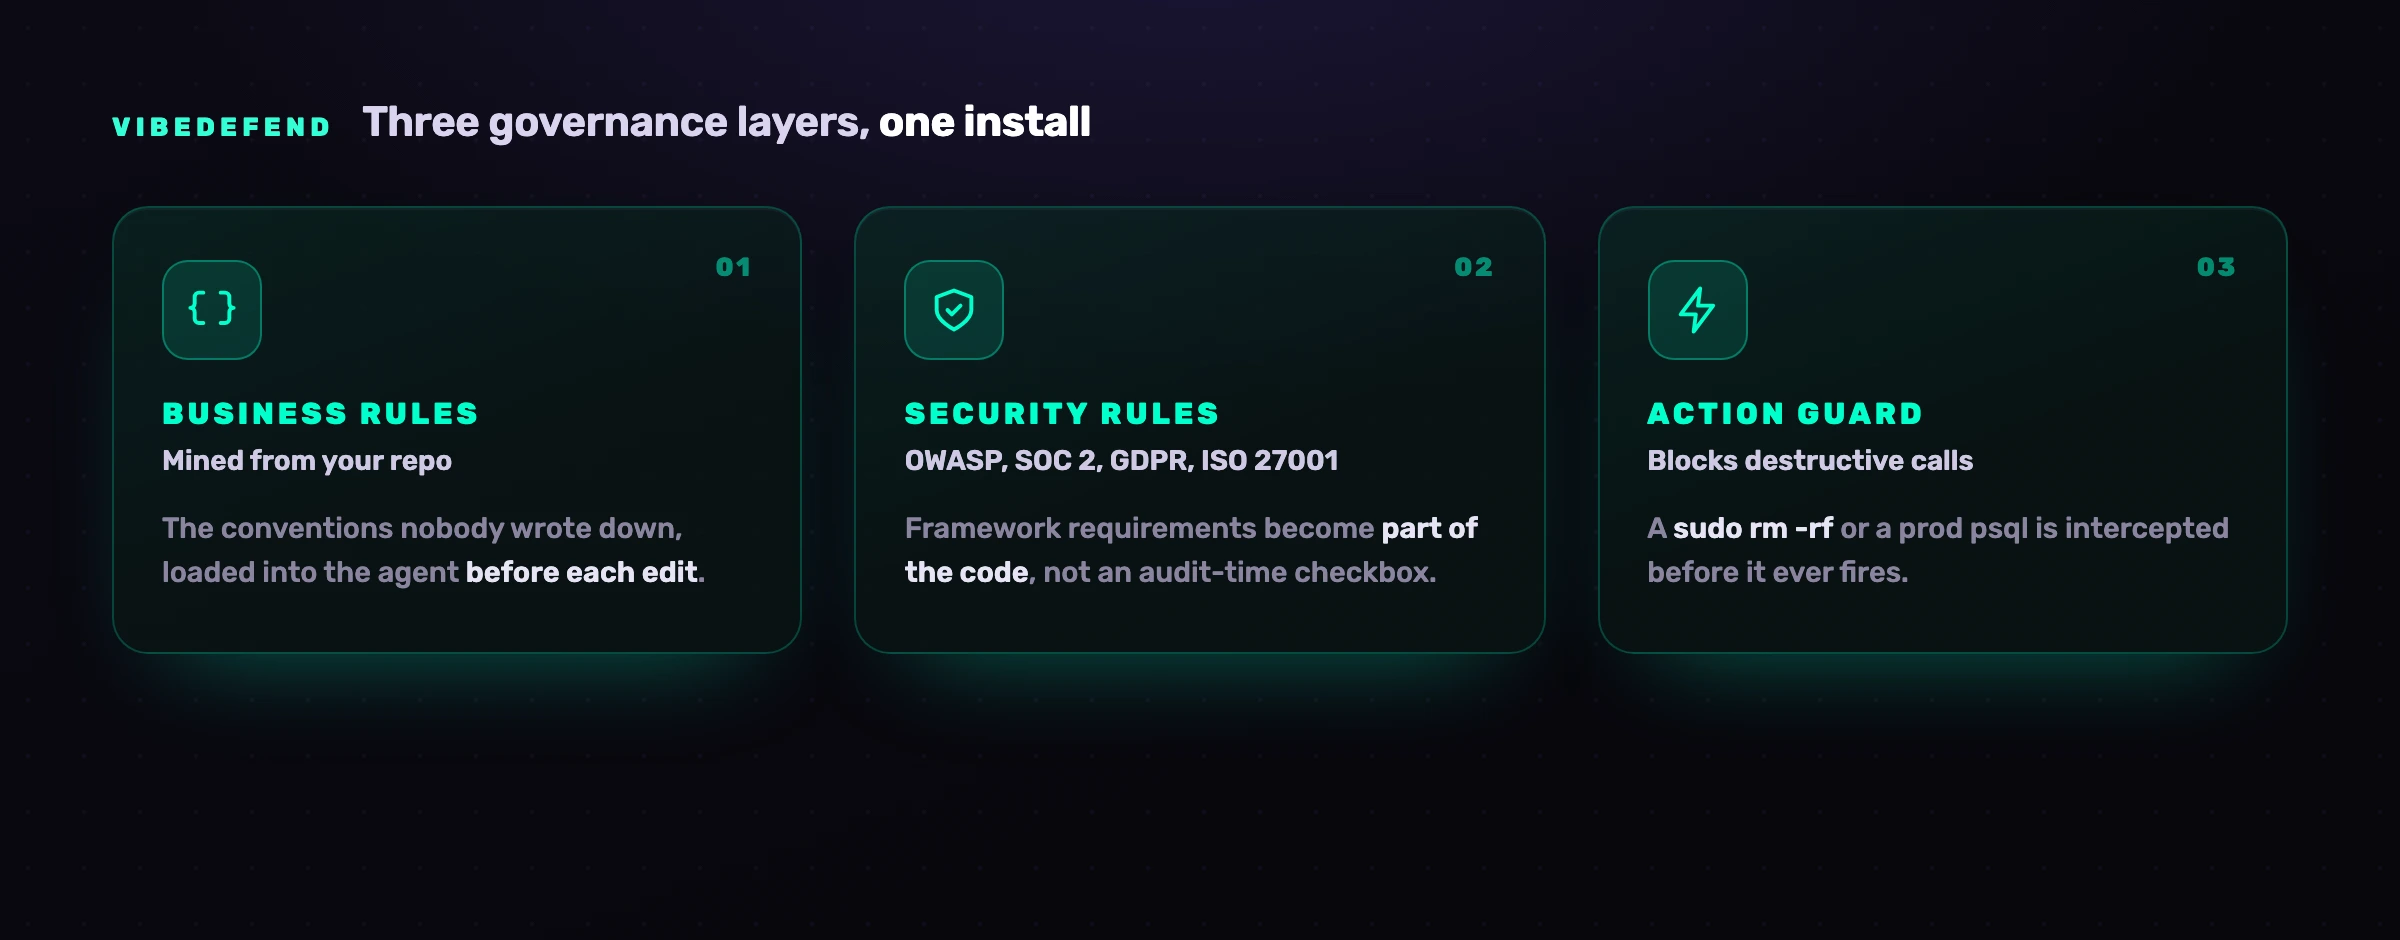
Regras de Negócio As convenções do teu repositório que nunca ninguém escreveu (usar Decimal128 para dinheiro, a autorização passa por requireOwner). O VibeDefend extrai-as da forma como a tua equipa já programa e carrega-as no contexto do agente antes de cada edição. Regras de Segurança OWASP Top 10, SOC 2, RGPD e ISO 27001, carregadas no dia em que instalas. O agente lê o lembrete aplicável antes de escrever, e o requisito do framework passa a fazer parte do código em vez de ser uma caixa a assinalar na altura da auditoria. Action Guard As chamadas destrutivas (um sudo rm -rf, uma leitura em bruto de uma variável de ambiente com cara de segredo, um psql ad-hoc contra um host de produção) são intercetadas antes de dispararem. Avisa ou bloqueia conforme a regra, e cada interceção fica no registo de auditoria. Live Findings Cada resultado dos scanners da CybeDefend (SAST com alcançabilidade, SCA, segredos, IaC e CI/CD) está ao vivo no contexto do agente, e por isso ele não só escreve código seguro como faz a triagem e corrige as vulnerabilidades que já existem.
Num controlo tão perto do código, importa saber para onde vai o código, por isso fica dito sem rodeios. Os action guards decidem no teu portátil, antes de um comando correr. Para servir as regras que se aplicam à linha que está a ser escrita, o VibeDefend envia um excerto curto desse código para o backend da CybeDefend, e a análise feita antes do commit envia os ficheiros alterados, ambos para a região da UE ou dos EUA que escolhes na instalação, e o teu código nunca é usado para treinar um modelo. As duas regiões são fisicamente separadas. Saber exatamente o que sai do portátil conta ainda mais com um agente cujo próprio ficheiro de credenciais já foi alvo de roubo.
Isto não substitui as práticas acima. É a camada em falta que elas dão como existente: a que põe as tuas regras nas mãos do agente no momento do prompt, para que a linha insegura seja reescrita antes sequer de ser sugerida, em vez de apanhada três fases depois por um scanner a ler um diff que ninguém teve tempo de ler. O sandbox impede o agente de fazer o que não deve; o VibeDefend molda, logo à partida, o que ele escreve.
Perguntas frequentes
O OpenAI Codex é seguro?
O OpenAI Codex é seguro de usar quando corre em sandbox e com um âmbito bem delimitado, e arriscado quando não é o caso. O sandbox ao nível do SO, os modos de aprovação escalonados e a rede desligada por omissão na cloud evitam uma grande classe de acidentes e contêm a maioria dos comandos descontrolados. O risco que sobra vem da configuração (modo full-access, rede ativada, aprovações desligadas), dos inputs (injeção de prompt, repositórios e pacotes maliciosos) e da autonomia em escala (grandes alterações na cloud que passam com pouca revisão). Trata-o como um agente poderoso que precisa de privilégio mínimo, isolamento e revisão humana, e não como uma ferramenta segura logo à partida.
Qual é a diferença entre Codex e "Codex Security"?
São dois produtos diferentes da OpenAI com o mesmo nome. O Codex é a ferramenta de código agêntica: a CLI, a extensão de IDE, o modo de cloud e o SDK que leem o teu repositório, editam ficheiros, correm comandos e abrem pull requests. O Codex Security é um agente à parte, dedicado a encontrar vulnerabilidades, que se liga a um repositório, constrói um modelo de ameaças, analisa o histórico de commits, valida os problemas candidatos em isolamento e propõe correções para revisão humana. Este guia trata de proteger o agente de código Codex. O Codex Security é um apoio à revisão de código, útil como par de olhos extra, e não um programa de segurança completo.
O Codex corre código num ambiente isolado (sandbox)?
Sim. O Codex executa os comandos dentro de um sandbox do sistema operativo: Seatbelt no macOS, Landlock e seccomp no Linux e um sandbox próprio no Windows. Por omissão, as escritas ficam limitadas ao workspace ativo e, no ambiente de cloud, o acesso de rede de saída está desativado. Estas predefinições são o núcleo do modelo de segurança do Codex. Podem ser afrouxadas deliberadamente com full-access (danger-full-access) ou ativando o acesso de rede dentro do sandbox workspace-write, e a OpenAI diz claramente que, ao fazê-lo, a proteção é retirada de propósito.
O Codex pode vazar o meu token GitHub ou credenciais?
Pode, se não tiveres cuidado, e já aconteceu. A BeyondTrust Phantom Labs divulgou uma vulnerabilidade de injeção de comandos que permitia aos atacantes roubar GitHub User Access Tokens através de um nome de branch forjado, no site do ChatGPT, na CLI Codex, no SDK e na extensão de IDE; a OpenAI já a corrigiu. À parte disso, um pacote npm malicioso que se fazia passar por um helper do Codex roubou o ficheiro de credenciais do Codex (~/.codex/auth.json) de cerca de 29 000 instalações. Defende o token dando-lhe um âmbito estreito, rodando-o, validando todas as ferramentas helper e protegendo o ficheiro de credenciais como um segredo valioso.
O Codex envia o meu código para a OpenAI?
O Codex envia aos modelos da OpenAI o contexto de que precisa para gerar respostas, o que pode incluir código, conteúdo de ficheiros e o contexto à volta da tua tarefa. O que fica guardado, e durante quanto tempo, depende da superfície que usas e do teu tier (os termos da API, do Business e do Enterprise não são iguais quanto à retenção e ao treino). Para código sensível, escolhe um tier e uma configuração à medida dos teus requisitos de tratamento de dados, mantém os segredos e os dados regulados fora do alcance do agente e revê as políticas de retenção. Uma camada adicional como o VibeDefend também envia algum código: um excerto curto para servir as regras e os ficheiros alterados para a análise feita antes do commit, para a região da UE ou dos EUA que escolhes na instalação, e esse código nunca é usado para treinar um modelo.
Que modo de sandbox/aprovação do Codex devo usar?
Para a maior parte do trabalho, read-only para explorar e auto (o sandbox workspace-write com aprovação a pedido) para fazer alterações, com a rede fechada. Reserva full-access (danger-full-access) e --dangerously-bypass-approvals-and-sandbox para contentores descartáveis sem credenciais reais, e evita --ask-for-approval never em qualquer máquina que consiga chegar à produção ou a segredos. Ajusta o modo à sensibilidade do repositório: quanto mais crítico o sistema, mais apertado o sandbox, mais aprovações e menos rede o agente deve ter. O que cada flag desativa, ao certo, está explicado em Codex danger-full-access, --yolo e o "modo unsafe".
Em que é que a segurança do Codex difere da do Claude Code, Cursor ou GitHub Copilot?
Os fundamentos são os mesmos (privilégio mínimo, gestão de segredos, revisão humana, análise de dependências), mas as superfícies mudam. As do Codex são o sandbox do SO e a sua saída de emergência em full-access, os incidentes de injeção de comandos e de cadeia de abastecimento no npm e a lacuna de revisão do modo de cloud autónomo. O Claude Code apoia-se numa integração profunda com MCP e com a shell; o Cursor teve o Workspace Trust desativado por omissão; o GitHub Copilot teve de lidar com sugestões inseguras e com a fuga de segredos em grande escala. Tratamos cada agente no seu próprio guia.