

Nesta página
- O que faz realmente o danger-full-access no Codex?
- O que remove o --dangerously-bypass-approvals-and-sandbox?
- -a never, --full-auto e "modo unsafe" são a mesma coisa?
- O que é o modo "Approve for me" do Codex?
- O acesso total do Codex é seguro?
- Como funciona a sandbox do Codex em macOS, Linux e Windows?
- Quando é que o acesso total é a decisão certa?
- O que usar em vez de --yolo?
- A brecha que nenhuma flag fecha
- Perguntas frequentes
- danger-full-access e --yolo são a mesma coisa?
- O que faz ao certo o codex --yolo?
- O -a never é perigoso por si só?
- O que é o "modo unsafe" do Codex?
- Para que serve o --dangerously-bypass-hook-trust?
- Como deixo o Codex usar a rede sem acesso total?
- A sandbox do Codex funciona em Windows?
- A sandbox trava a prompt injection?
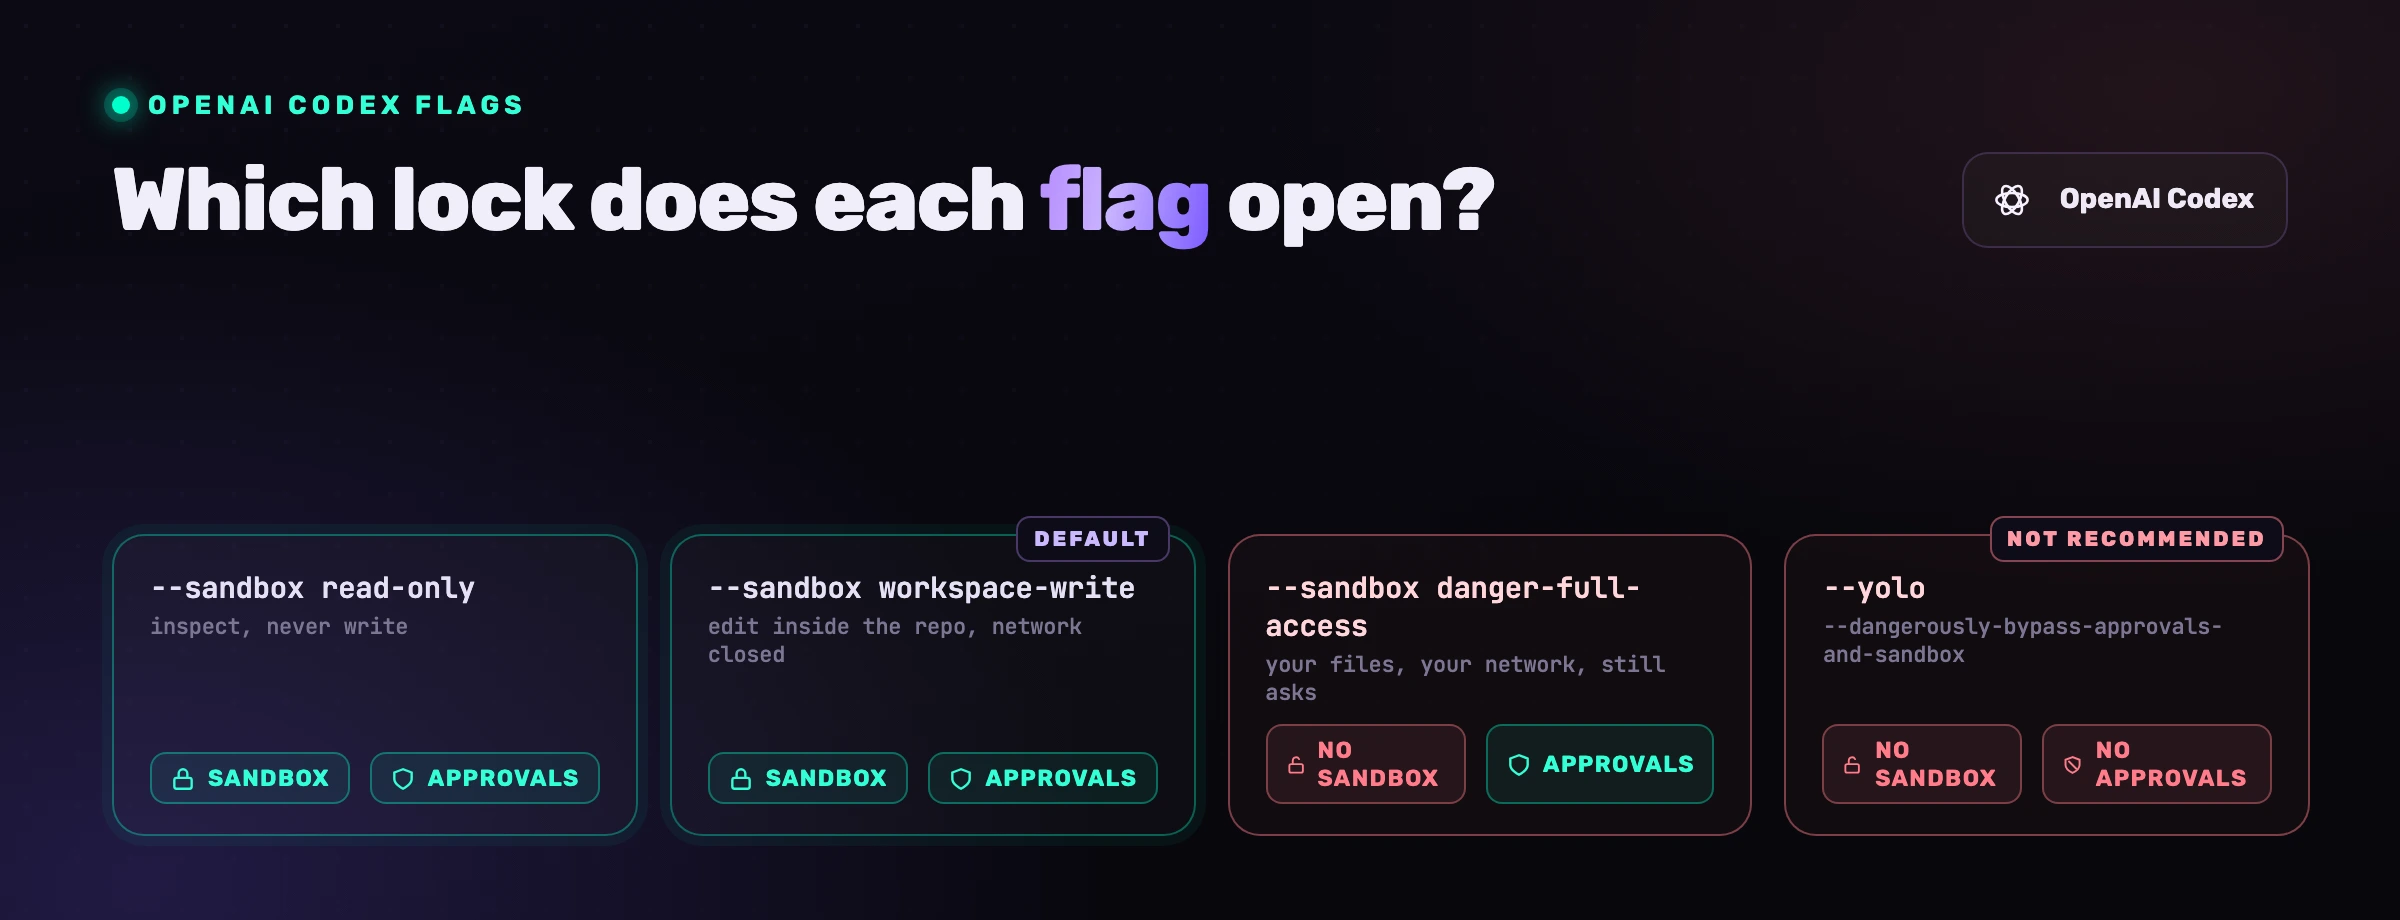
danger-full-access, --dangerously-bypass-approvals-and-sandbox, --yolo, -a never e "Approve for me": o OpenAI Codex tem várias maneiras de afrouxar as suas próprias barreiras, e os nomes não são intercambiáveis. O --full-auto, que muitos guias ainda referem, foi removido na versão 0.147.0. Alguns retiram a sandbox do sistema operativo, outros retiram os pedidos de aprovação, um retira ambos. Este guia explica exatamente o que cada flag desativa, como a sandbox é aplicada em macOS, Linux e Windows, quando o acesso total é uma escolha razoável, e a configuração que te dá um agente rápido sem lhe entregar a tua máquina.
O que faz realmente o danger-full-access no Codex?
danger-full-access é um dos três valores da flag --sandbox do Codex, e desliga a sandbox por completo. A documentação de sandboxing da OpenAI descreve-o numa frase: o agente corre sem restrições de sandbox, o que remove as fronteiras de sistema de ficheiros e de rede. Cada comando de shell que o modelo gera passa então a correr como o teu utilizador, com as tuas permissões, no teu sistema de ficheiros real e com a tua rede real.
Os outros dois valores são os que interessam no dia a dia:
Valor de --sandbox | Leitura de ficheiros | Escrita de ficheiros | Rede | Aplicado por |
|---|---|---|---|---|
read-only | Sim | Não | Não | Sandbox do SO |
workspace-write (predefinição) | Sim | O workspace, /tmp e $TMPDIR | Fechada salvo ativação | Sandbox do SO |
danger-full-access | Tudo o que o teu utilizador pode ler | Tudo o que o teu utilizador pode escrever | Sem restrição | Nada |
Dois pormenores do workspace-write merecem atenção antes de o considerares demasiado restritivo. Primeiro, o conjunto gravável não é apenas a pasta atual: /tmp e $TMPDIR são graváveis por predefinição, e podes acrescentar caminhos com sandbox no config.toml (a referência de configuração expõe também exclude_slash_tmp e exclude se os quiseres fora). Segundo, o acesso à rede tem o seu próprio interruptor, sandbox, por isso "preciso que o npm install funcione" é um argumento a favor de um booleano, não do acesso total.
Dentro de cada raiz gravável há pastas que continuam só de leitura: .git, .agents, .codex e, desde o Codex 0.159.0 (29 de setembro de 2026), também .aws. A pull request que fez a alteração explica porquê: um perfil AWS pode indicar um credential helper que a aplicação executa, pelo que um agente capaz de editar .aws/config poderia deixar lá um comando à espera da próxima chamada à AWS. A proteção impede a escrita, não a leitura.
O que o danger-full-access não faz é calar o Codex. Os pedidos de aprovação dependem de uma flag separada, e é daí que vem a maior parte da confusão da secção seguinte.
O que remove o --dangerously-bypass-approvals-and-sandbox?
--dangerously-bypass-approvals-and-sandbox, com o alias --yolo, remove as duas proteções de uma vez: a sandbox do SO e os pedidos de aprovação. A referência da CLI da OpenAI descreve-o assim: correr todos os comandos sem aprovações nem sandbox, e usar apenas dentro de um ambiente endurecido a partir do exterior. Essa segunda frase é toda a política. A flag existe para um contentor ou uma máquina virtual que sejam eles próprios a fronteira, não para um portátil com as tuas chaves SSH, as tuas credenciais cloud e o .env de produção.
A diferença entre os dois mecanismos torna-se simples quando os pões lado a lado:
- A sandbox decide o que um comando pode tocar: que caminhos são graváveis, se pode abrir sockets. É aplicada pelo sistema operativo, por isso um comando que o modelo não tencionava correr fica tão contido como um que tencionava.
- As aprovações decidem quando o Codex para para te perguntar. São um ponto de controlo humano, e só funcionam se houver um humano a lê-las.
danger-full-access sozinho ainda te deixa o ponto de controlo. --yolo não te deixa nada além do critério do modelo, e o critério do modelo é precisamente o que uma prompt injection escondida num README, numa fixture de testes ou na mensagem de erro de uma dependência foi desenhada para torcer. Não é teoria: o nosso guia sobre fugas à sandbox em agentes de código mostra como o conteúdo de um repositório se transforma em comandos, e o padrão aplica-se ao Codex sem alterações.
-a never, --full-auto e "modo unsafe" são a mesma coisa?
Não. Afrouxam camadas diferentes, um deles nem sequer é uma flag e o --full-auto já não existe. Eis o mapa completo, já com as flags novas:
| O que as pessoas escrevem | O que é na realidade | Sandbox | Aprovações |
|---|---|---|---|
--sandbox danger-full-access, "full access" | Um modo de sandbox | Desligada | Sem alteração |
--ask-for-approval never, -a never | Uma política de aprovação | Sem alteração | Desligadas |
--dangerously-bypass-approvals-and-sandbox, --yolo | Uma flag de bypass | Desligada | Desligadas |
--approve-for-me, "Approve for me" | Uma definição do revisor (auto-review) | workspace-write | Respondidas por um agente revisor |
--dangerously-bypass-hook-trust | Dispensa a revisão dos hooks novos ou alterados, numa só execução | Sem alteração | Sem alteração |
--full-auto | Removida na 0.147.0; usa --sandbox workspace-write | Ligada | Comportamento herdado |
| "modo unsafe", "modo perigoso", "run dangerously" | Não é uma flag do Codex | Depende do que se queria dizer | Depende do que se queria dizer |
--ask-for-approval já só aceita dois valores: on-request (a predefinição: o modelo pergunta quando quer escalar, chegar à rede ou sair do workspace) e never. O untrusted foi retirado no Codex 0.149.0 (20 de agosto de 2026), e uma configuração que ainda o use pode impedir o Codex de arrancar. As versões mais antigas aceitavam também on-failure, que corria tudo dentro da sandbox e só perguntava quando um comando falhava lá dentro; --full-auto era o atalho para essa combinação. Descontinuada na 0.128.0, desapareceu na 0.147.0 (7 de agosto de 2026).
A predefinição "Full access" que vês no seletor interativo é a combinação de danger-full-access com never, e a OpenAI rotula-a de "not recommended" na sua própria documentação de aprovações. É --yolo com um nome mais simpático.
O que é o modo "Approve for me" do Codex?
"Approve for me" é o modo de permissões do Codex em que um agente revisor, e não tu, responde aos pedidos de aprovação, enquanto a sandbox workspace-write e a política on-request se mantêm. O guia de sandboxing da OpenAI resume-o assim: a mesma sandbox workspace-write do "Ask for approval", mas os pedidos elegíveis passam por uma revisão automática em vez de aparecerem para os aprovares à mão. Escolhes este modo no menu de permissões por baixo da caixa de mensagem, com /permissions na CLI ou no arranque com --approve-for-me, uma flag que chegou com o Codex 0.147.0 (7 de agosto de 2026). No config.toml escreve-se approvals; o valor predefinido, user, és tu.
Não é mais uma política de aprovação: approval_policy decide quando o Codex para, o revisor decide quem responde. A página da OpenAI sobre auto-review chama-lhe "a reviewer swap, not a permission grant", uma troca de revisor e não uma permissão nova: as raízes graváveis, o acesso à rede e os caminhos protegidos não mexem, e o que a sandbox já permite nunca é revisto. Além disso, só funciona se houver pedidos: com -a never não sobra nada para rever, e com danger-full-access ou --yolo uma ação pode correr sem chegar a gerar o pedido que o revisor lê. A OpenAI avisa que o auto-review não é uma garantia de segurança determinista; ainda assim, três recusas seguidas interrompem o turno.
O acesso total do Codex é seguro?
O acesso total do Codex é seguro exatamente enquanto o ambiente à sua volta o for, e inseguro assim que deixa de o ser. Dentro de um contentor acabado de criar, sem credenciais, com um clone descartável e uma regra de saída de rede, danger-full-access é uma troca razoável: o contentor é a sandbox, e a do Codex só o atrasaria. Num posto de desenvolvimento significa que um modelo com a tua identidade pode fazer curl para qualquer lado, escrever em qualquer sítio e ler todos os tokens da tua pasta pessoal, e a única coisa entre uma instrução hostil e esse desfecho é o modelo decidir não obedecer.
Os dados que temos sobre agentes sem guarda não tranquilizam. No nosso estudo anterior, em que os agentes construíam uma plataforma de raiz sobre uma base de dados aplicacional em funcionamento, dois braços sem guarda executaram DROP SCHEMA sobre essa base sete e onze vezes, dezoito no total, e um deles correu rm -rf num caminho absoluto fora do seu próprio projeto. O braço com guarda tentou a mesma eliminação de esquema uma única vez, e foi-lhe recusada. No nosso estudo controlado de 24 de agosto de 2026, o guarda de comandos verificou 1 769 comandos de shell e recusou dezassete. O detalhe conta mais do que o total: uma captura real, um agente que ia ler uma credencial guardada; três aplicações corretas da política, em comandos que ali traziam pouco risco; e treze falsos positivos, que custaram um turno ao agente cada um. Um guarda que procura padrões no texto de um comando é um fio de disparo, não uma fronteira. Sabe recusar o comando que importa, e também dispara com comandos inofensivos. É por isso que a sandbox conta: o sistema operativo confina um comando sem ter de adivinhar o que ele quer dizer.
execuções de DROP SCHEMA contra uma base em funcionamento por agentes sem guarda, no nosso estudo anterior
comandos de shell verificados pelo guarda no nosso estudo controlado de 24 de agosto de 2026
comandos recusados: 1 captura real, 3 aplicações corretas da política, 13 falsos positivos
Repara naquilo de que o acesso total não te protege, mesmo com um ambiente limpo: o código. Uma sandbox contém comandos; não tem opinião sobre se a verificação de autorização que o modelo acabou de escrever está correta. Voltamos a isso no fim.
Como funciona a sandbox do Codex em macOS, Linux e Windows?
O Codex aplica a sandbox com o sistema operativo, não com o modelo, e é por isso que ela aguenta mesmo quando o modelo está a ser manipulado. Em macOS usa o framework Seatbelt da Apple, o mesmo mecanismo de políticas sandbox-exec que confina os daemons do sistema, e funciona sem instalar nada. Em Linux e em WSL2 usa bubblewrap (bwrap) com filtros seccomp; as versões anteriores usavam Landlock e seccomp diretamente. Em Windows usa uma sandbox nativa do Windows, com ou sem elevação, quando é lançado a partir do PowerShell, e o mecanismo de Linux quando corre em WSL2.
Daqui saem duas consequências práticas. Se faltar o bwrap numa máquina Linux, o Codex não consegue construir lá a sandbox: instala-o antes de assumires que estás protegido. E se um comando é recusado sem perceberes porquê, codex sandbox corre um comando sob a política atual para depuração, com --log-denials em macOS para mostrar o que o Seatbelt bloqueou. É a ferramenta certa para "o Codex não consegue escrever aqui", e uma resposta muito melhor do que recorrer ao danger-full-access.
O Seatbelt resolve também uma dúvida muito frequente nas pesquisas: "Codex seatbelt" não é uma funcionalidade que se ative. É aquilo de que read-only e workspace-write são feitos num Mac.
Quando é que o acesso total é a decisão certa?
O acesso total é a decisão certa quando outra coisa já é a fronteira. O padrão que funciona:
Três verificações antes de ligares a flag:
- O que pode o processo ler? Se
~/.ssh,~/.aws,~/.codex/auth.jsonou um.envcom chaves ativas estiverem ao alcance, a resposta não é o acesso total. O ficheiro de credenciais do Codex já foi alvo de um pacote npm malicioso; não lhe facilites a vida. - Para onde pode enviar dados? Rede sem restrição mais prompt injection é um canal de exfiltração. Se não consegues restringir a saída, deixa o
network_accessfechado e deixa o Codex perguntar. - Quem lê a saída? Em pipelines de
codex execninguém está a ver as aprovações de qualquer forma, o que é uma razão para te apoiares mais na sandbox, não para a retirares.
Se alguma das três falhar, usa antes a configuração abaixo.
O que usar em vez de --yolo?
Para quase todas as tarefas, workspace-write com aprovações on-request, a rede fechada e o projeto marcado como de confiança dá-te um agente rápido que continua sem poder sair da sua faixa. No ~:
sandbox_mode = "workspace-write"
approval_policy = "on-request"

[sandbox_workspace_write]
network_access = false
writable_roots = ["/Users/tu/scratch"]

[projects."/Users/tu/work/payments-api"]
trust_level = "trusted"
trust diz ao Codex para aplicar a configuração .codex/ própria do projeto; os projetos não confiáveis saltam essas camadas locais, que é exatamente o que queres para um repositório que acabaste de clonar de um desconhecido. Se o incómodo forem os pedidos, aperta o que os dispara em vez de os desligar: as versões recentes expõem uma approval_policy granular e uma opção approvals que encaminha as aprovações para um revisor automático. Trata o auto-review como uma comodidade, não como uma fronteira: é um modelo a julgar outro modelo.
Para CI e codex exec, mantém a sandbox e retira apenas os pedidos: --sandbox workspace-write -a never num runner sem credenciais de produção é uma postura coerente. --yolo no mesmo runner não é, porque a sandbox não te custava nada.
A brecha que nenhuma flag fecha
Todas as flags deste artigo governam o que o Codex pode executar. Nenhuma governa o que o Codex escreve, e é no código que vive agora a maior parte do risco. Uma sandbox workspace-write deixa alegremente o agente fazer commit de um endpoint sem verificação de autorização, de um handler de reembolsos sem limite ou de uma query construída por concatenação de strings, porque nenhum deles é um comando. São diffs.
É essa a camada que o VibeDefend acrescenta em agent-time. Coloca-se no ciclo do Codex, confronta o diff que o agente está prestes a escrever com as tuas próprias regras, reescreve a versão insegura antes de ela aterrar, e vigia os comandos de shell com a mesma política que produziu as dezassete recusas acima, falsos positivos incluídos. No nosso estudo controlado de 24 de agosto de 2026, o braço com a camada implementou à letra 57 de 64 detalhes de regra avaliados (89 %), contra 7 de 55 (13 %) com um ficheiro de regras mantido à mão no repositório e 8 de 65 (12 %) sem nada. A sandbox mantém o Codex fora da tua máquina; o guarda mantém o código dele fora da tua fila de incidentes.
Se corres o Codex em --yolo de propósito, num contentor, com um guarda sobre o diff, tens uma configuração defensável. Se o corres em --yolo no teu portátil porque os pedidos irritavam, lê o guia completo de segurança do Codex, compara com o YOLO mode do Cursor, hoje Run Everything, e depois fala connosco.
Perguntas frequentes
danger-full-access e --yolo são a mesma coisa?
Não. --sandbox danger-full-access retira a sandbox do SO e mantém os pedidos de aprovação. --dangerously-bypass-approvals-and-sandbox (--yolo) retira a sandbox e os pedidos. A predefinição "Full access" do seletor corresponde ao segundo.
O que faz ao certo o codex --yolo?
Executa de imediato todos os comandos que o modelo gera, com as permissões do teu utilizador, no teu sistema de ficheiros real, com rede sem restrição, e nunca pergunta nada. A referência da OpenAI reserva-o a um ambiente endurecido a partir do exterior, isto é, um contentor ou uma VM que sejam eles próprios a fronteira.
O -a never é perigoso por si só?
Menos do que se costuma pensar, desde que a sandbox continue ativa. --ask-for-approval never retira o ponto de controlo humano, mas workspace-write continua a confinar as escritas e a rede fica fechada salvo se a tiveres aberto. Torna-se perigoso no momento em que o combinas com danger-full-access.
O que é o "modo unsafe" do Codex?
Não existe nenhuma flag com esse nome. "Modo unsafe", "modo perigoso" e "run dangerously" são usados para falar de danger-full-access, de --yolo ou de -a never, que são três coisas diferentes. Confirma a que se refere realmente um tutorial antes de copiares o comando.
Para que serve o --dangerously-bypass-hook-trust?
Corre os teus hooks ativados sem a revisão de confiança, apenas nessa invocação. Desde o Codex 0.129.0 (7 de maio de 2026), um hook novo ou alterado é ignorado até aprovares a sua definição exata em /hooks; esta flag, acrescentada na 0.131.0 (18 de maio de 2026), levanta esse controlo para execuções sem interface, como as de CI. Nada fica guardado no config.toml, os hooks desativados continuam desativados e o Codex mostra um aviso no arranque. A referência da CLI da OpenAI reserva-a para automatização que já verifica a origem dos seus hooks. Um hook é um script que corre na tua máquina: num repositório que não escreveste, mantém a revisão.
Como deixo o Codex usar a rede sem acesso total?
Define network em [sandbox no config.toml, ou passa -c sandbox para uma única execução. As escritas continuam confinadas ao workspace; só a rede se abre.
A sandbox do Codex funciona em Windows?
Sim. A partir do PowerShell usa uma sandbox nativa do Windows, com ou sem elevação; em WSL2 usa o mecanismo de Linux (bubblewrap e seccomp). Os valores de --sandbox e as chaves do config.toml são os mesmos em todas as plataformas.
A sandbox trava a prompt injection?
Contém o que um comando injetado pode tocar; não trava a injeção. Um README malicioso pode continuar a empurrar o modelo para escrever código inseguro, ou para pedir uma escalada que um humano cansado aprova. Mantém a sandbox ativa e acrescenta uma camada que verifica o código e os comandos, não apenas os caminhos de ficheiros.