

Nesta página
- O Claude Code segue o CLAUDE.md?
- O que já diz a investigação publicada?
- O que é que nós medimos e os estudos grandes não mediram?
- O que acontece quando a regra está no ficheiro, com o valor certo?
- As regras eram impossíveis de adivinhar, de propósito?
- Porque é que dois agentes configurados de maneira diferente cometem o mesmo erro?
- Um CLAUDE.md perfeito resolve o problema?
- O que dizem as empresas de segurança sobre os ficheiros de regras?
- O que vale a pena mudar e o que não vale?
- Quanta confiança merecem estes números?
- O que vendemos, sem rodeios
- Perguntas frequentes
- O Claude Code segue mesmo o CLAUDE.md?
- Como se escreve um bom CLAUDE.md?
- O que deve conter um CLAUDE.md?
- Que tamanho deve ter um CLAUDE.md?
- O Claude Code lê o AGENTS.md ou só o CLAUDE.md?
- Porque é que o Claude Code não segue as minhas regras?
- O CLAUDE.md serve mesmo para alguma coisa?
- Deve pôr-se o CLAUDE.md no repositório?
- Andrej Karpathy provou mesmo que um CLAUDE.md faz os erros cair de 40 % para 11 %?
- Como é que se impõe mesmo uma regra no Claude Code?
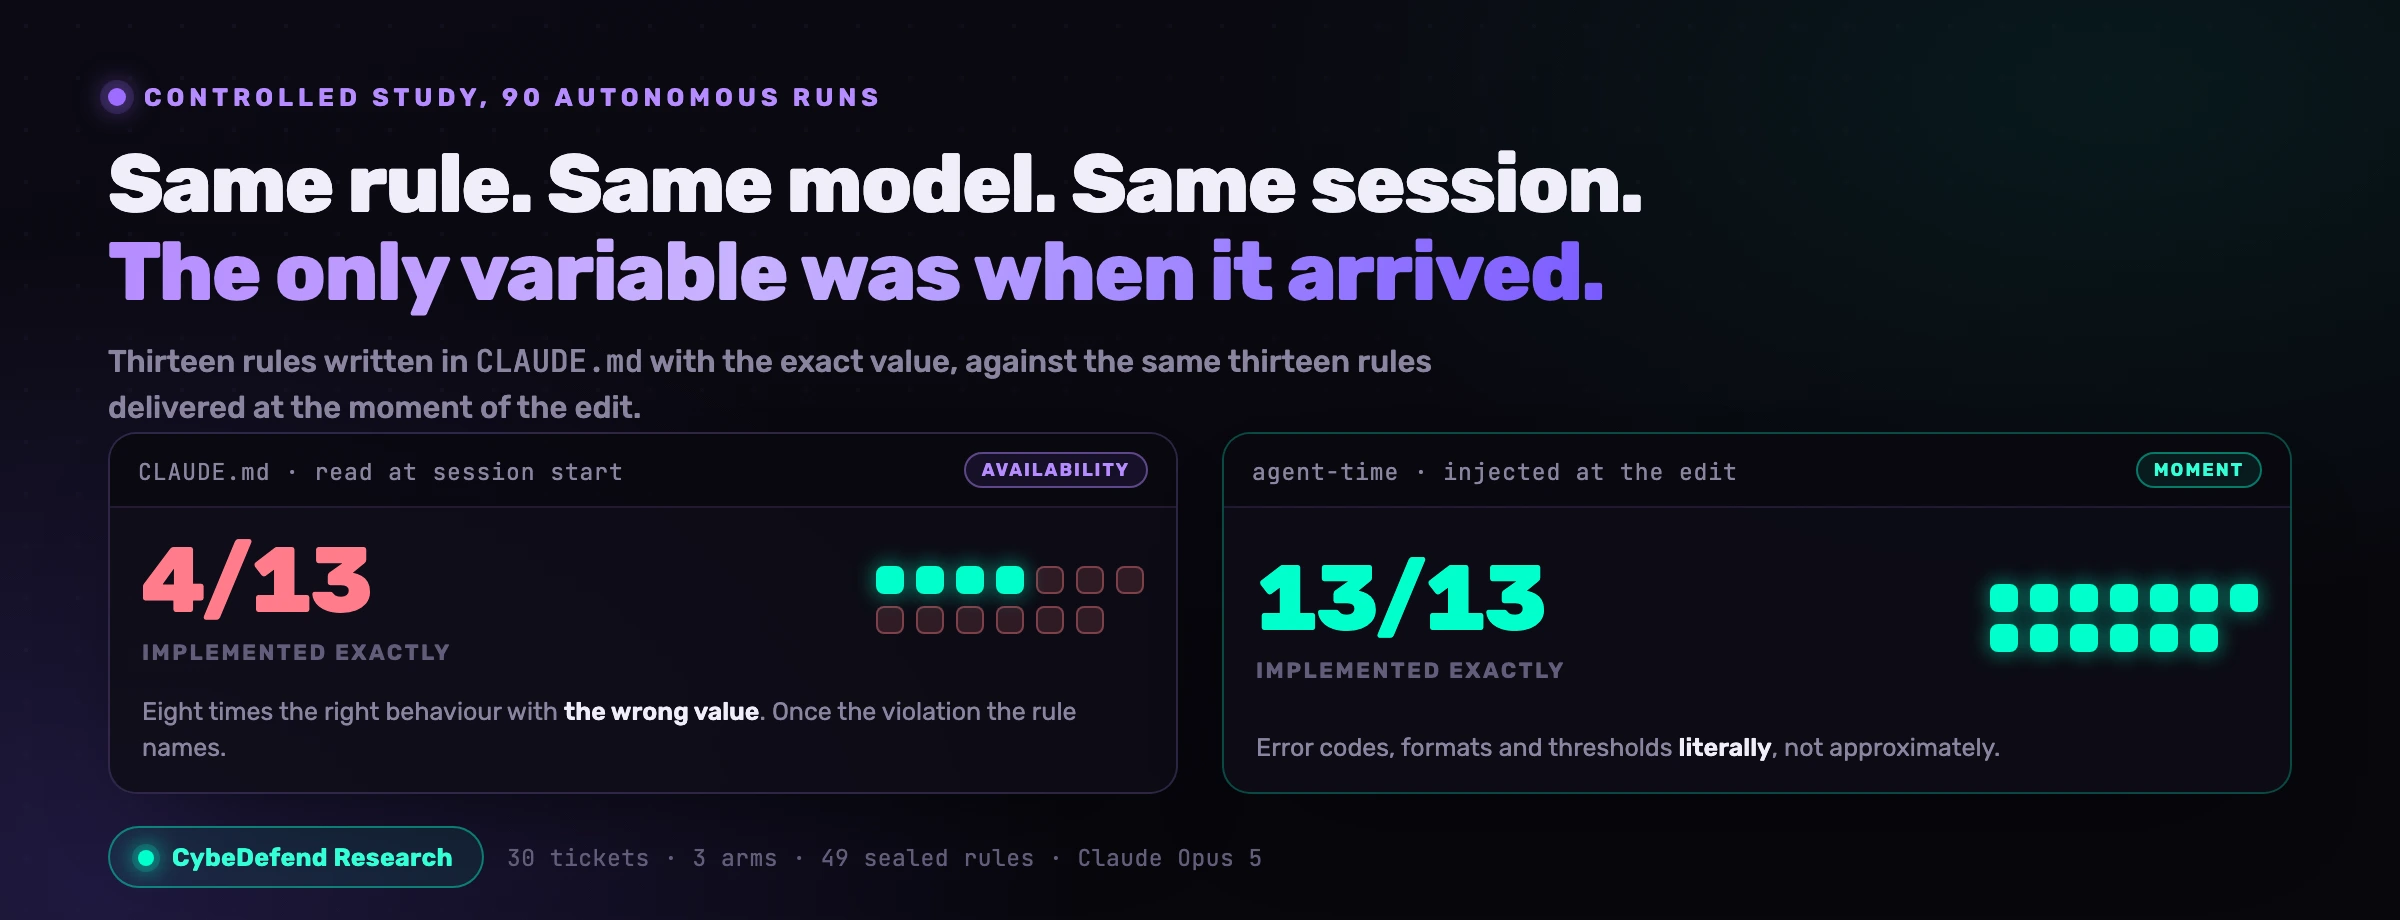
O CLAUDE.md é cumprido justamente naquilo que o agente já ia acertar sozinho, e perde-se naquilo que te levou a escrever o ficheiro. Para o medir, passámos 30 tickets de programação por três agentes autónomos, sobre a mesma base de código e com o mesmo modelo, num total de 90 execuções. Mexemos numa variável e só numa: como é que o agente podia ficar a saber as 49 regras de negócio e de conformidade da plataforma. O braço que tinha uma secção de regras realista, escrita à mão no CLAUDE.md, acertou em cheio em 7 de 55 valores concretos. O braço sem regra nenhuma acertou nos mesmos 7 de 55. Exatamente a mesma nota.
O Claude Code segue o CLAUDE.md?
Em parte, e a parte que deixa cair é exatamente aquela que te interessa. A própria Anthropic não esconde isso. A página sobre memória diz que os ficheiros CLAUDE.md são «carregados no início de cada conversa» e que o Claude «trata-os como contexto, não como configuração imposta». A página de resolução de problemas vai mais longe: «o Claude lê o ficheiro e tenta segui-lo, mas não há garantia de cumprimento estrito, sobretudo quando as instruções são vagas ou contraditórias». O que ela não publica, a 13 de setembro de 2026, é um número: não existe na documentação nenhuma taxa de cumprimento medida. É compreensível da parte de quem vende o produto e não serve de nada a uma equipa que precisa de decidir se aquele ficheiro é um controlo ou uma sugestão.
A falta do número não travou a pergunta. No gestor de issues do anthropics/claude-code, uma pesquisa por títulos que contenham ao mesmo tempo CLAUDE.md e alguma forma de «ignore» devolve 199 resultados, 9 deles ainda abertos a 13 de setembro de 2026.
Nem todos falam de cumprimento de regras, mas há um título que se repete e não deixa margem para dúvidas: CLAUDE.md Mandatory Rules Consistently Ignored Across Multiple Repositories, aberta desde junho de 2025, com 45 reações.
Repara no plural. Ninguém ali está a reportar um bug. Estão a reportar uma propriedade.
O que já diz a investigação publicada?
Que mexer no tamanho do ficheiro, na posição da regra ou na divisão em vários ficheiros não muda nada, e que o cumprimento se degrada à medida que a sessão se alonga. Não é um resultado nosso, e queremos deixar isso claro antes de apresentar o que é.
Em maio de 2026, Damon McMillan publicou Instruction Adherence in Coding Agent Configuration Files: A Factorial Study of Four File-Structure Variables (arXiv 2605.10039, submetido a 11 de maio de 2026). É de longe o trabalho com mais potência estatística sobre o assunto: 1650 sessões do Claude Code CLI, 16 050 observações ao nível da função, duas bases de código TypeScript, cinco tarefas de programação, Sonnet 4.6 com Opus 4.6 como controlo entre modelos. As quatro variáveis manipuladas de forma fatorial foram o tamanho do ficheiro, a posição da instrução, a arquitetura do ficheiro e as contradições com ficheiros vizinhos.
O resultado, nas palavras do artigo: «nenhuma das quatro variáveis estruturais nem nenhuma das três interações de segunda ordem produz um contraste detetável depois da correção para testes múltiplos». Os nulos do tamanho e do conflito vêm acompanhados de fatores de Bayes a favor do nulo (BF10 entre 0,05 e 0,10), o que é bastante mais forte do que uma simples falha em rejeitar.
Só uma coisa se mexeu: «cada função adicional que o agente gera está associada a uma descida de aproximadamente 5,6 % na probabilidade de cumprimento por passo (OR = 0,944)», num efeito que o artigo descreve como não monótono.
É neste segundo ponto que tudo se decide. Uma anotação-alvo trivial é uma marca que o agente não tem razão nenhuma para escrever a não ser que o ficheiro lha peça, portanto o trabalho do ficheiro é levar o cumprimento de quase zero até qualquer coisa, e esse trabalho ele faz. Nós fomos fazer a pergunta que comercialmente nos dava mais jeito não fazer: o que acontece quando o instinto do agente já produz uma resposta plausível e a regra diz que a resposta plausível está errada?
O que é que nós medimos e os estudos grandes não mediram?
O caso em que o agente já tem uma resposta. O nosso estudo controlado, publicado a 24 de agosto de 2026, passou 30 tickets de programação por uma base de código Express e SQLite de dimensão média, em triplicado: três agentes autónomos, os mesmos tickets, o mesmo modelo (Claude Opus 5 com effort high), 90 execuções e 93 análises de segurança independentes. A única variável era a forma como o agente podia ficar a saber as 49 regras da plataforma: nada, uma secção de regras no CLAUDE.md do repositório, ou injeção no momento da edição.
As regras cobrem onze famílias, dos reembolsos e da aritmética do cartão de fidelização até à minimização do RGPD, à obrigação de preço de referência da diretiva Ómnibus, aos tetos de pagamento em numerário e aos registos de auditoria. Cada uma carrega um valor concreto deliberadamente arbitrário: 422 REFUND_EXCEEDS_CAPTURED, um limiar de 150,00 euros para aprovação da chefia, erased-{id}@removed.invalid, ORD-{store}-{YYMMDD}-{seq}.
A secção do braço com ficheiro foi escrita como as equipas reais as escrevem: 41 linhas para cobrir cerca de metade do corpus, tudo parafraseado, dois valores já desatualizados, famílias inteiras em falta. O que ela dizia sobre cada regra ficou selado antes da primeira execução, tal como o corpus. Os tickets foram redigidos como incidentes, em voz de programador, e passados por uma verificação automática para garantir que não deixavam escapar nenhum literal. E três auditores cegos avaliaram todos os diffs sem saber de que braço vinham.
valores concretos exatos com uma secção de regras realista no CLAUDE.md
valores concretos exatos sem qualquer ficheiro de regras
valores concretos exatos com a regra entregue na edição
Sete em 55 nos dois braços de controlo. Não por pouco: igual. Ao longo das dezanove tarefas da fase 1, ter um ficheiro de regras realista no repositório não mudou nada de mensurável no código produzido.
Mudou a forma dos erros, e essa é a única contribuição que conseguimos demonstrar: o braço nu violou mais (18 contra 12), e o braço com ficheiro chegou mais vezes ao comportamento certo com o valor errado (28 contra 20). Um documento parafraseado faz os erros passar de violação a quase-acerto. Não os transforma em acerto.
O que acontece quando a regra está no ficheiro, com o valor certo?
É implementada tal e qual em 31 % dos casos. Como a cobertura de cada regra pelo ficheiro ficou selada antes das execuções, podemos partir a fase 1 pelo que o ficheiro dizia de facto. Em 13 regras o valor certo estava lá, preto no branco, num documento que é lido no arranque de todas as sessões.
| O que o ficheiro dizia da regra | Regras avaliadas | Exatas | Certo, com outro valor | Violadas | Exatas na edição |
|---|---|---|---|---|---|
| Exata, o valor certo, por escrito | 13 | 4 (31 %) | 8 | 1 | 13 (100 %) |
| Vaga, a direção sem o valor | 21 | 2 (10 %) | 13 | 2 | 15 (71 %) |
| Ausente, nunca escrita | 20 | 1 (5 %) | 6 | 9 | 18 (90 %) |
Lê a primeira linha da tabela outra vez, devagar. O que faltava não era a informação. Era o momento em que ela chegava.
O caso mais nítido é a tarefa M06. O ticket pede ao agente que aceite um cartão-presente de valor inferior ao do cesto, com um cartão bancário a cobrir o resto. A regra diz que só se ganha um ponto de fidelização por cada euro inteiro pago com dinheiro real, e que a parte coberta pelo cartão-presente não conta para nada. O braço com ficheiro tinha essa regra, exata. Reescreveu a função de pagamento, calculou a parcela elegível para ordenar os meios de pagamento, e deixou intacta a linha floor(total / 100), que gera os pontos a partir do total. No fluxo que ele próprio acabara de escrever, os euros do cartão-presente dão fidelização.
Trabalho de um engenheiro cuidadoso que nunca viu o documento de regras.
Tinha-o visto, sim, no arranque da sessão, num ficheiro carregado antes do primeiro turno. O braço que recebeu a mesma regra dentro do ciclo, enquanto editava o ficheiro dos pagamentos, escreveu earned = floor(remainderCents / 100) e dois testes só para isso.
As regras eram impossíveis de adivinhar, de propósito?
Algumas eram, e esta é a objeção que se responde em vez de se enterrar. Classificámos regra a regra o quanto cada uma era adivinhável, e selámos essa classificação antes da primeira execução: 35 impossíveis de adivinhar, 13 fracamente adivinháveis, 1 adivinhável. Os valores arbitrários são deliberados, porque são a única maneira de distinguir conhecer uma regra de adivinhar uma regra razoável.
A tarefa M21 é essa separação. Os três braços limitaram os pagamentos em numerário a 1000 euros, porque isso é um facto jurídico público que o modelo conhece e que não precisa que lhe digam. Só o braço que recebeu a regra respondeu com o código de erro da própria plataforma, 422 CASH_LIMIT, testado ao cêntimo no limite, sobre a parcela em numerário de um pagamento misto. Os outros dois devolveram um 422 com uma mensagem em prosa.
Para um cliente de API isso não é a mesma coisa. Um caso está tratado, o outro fica ao critério de quem vier a escrever a integração. O que uma empresa paga não é o que o modelo sabe do mundo, é o contrato arbitrário que faz os seus próprios sistemas falarem uns com os outros. Quem achar o nosso corpus arbitrário de mais tem de responder à pergunta que a M21 levanta: e os teus códigos de erro e os teus formatos, são assim tão menos arbitrários?
Porque é que dois agentes configurados de maneira diferente cometem o mesmo erro?
Porque os erros de um agente são determinísticos: repetem-se, não se dispersam. Foi o resultado que não tínhamos previsto e é o que tem maior consequência operacional. Em 16 das 30 tarefas, os dois braços de controlo, executados de forma independente em árvores separadas, chegaram à mesma implementação errada. Não a uma parecida. À mesma.
- O mesmo SQL de escrita absoluta na contagem anual de stock,
quantity = excluded.quantity, quando a regra exige um movimento tipado num livro de registo. - O mesmo desenho proibido para promoções sobrepostas, «a sobreposição é uma funcionalidade, ganha a mais forte», que é o instinto de qualquer engenheiro e exatamente aquilo que a regra de preços proíbe.
- O mesmo teto de 4000 caracteres nos diagnósticos guardados, e o mesmo campo
ibanesquecido na lista de campos a ocultar.
Se partes do princípio de que um resultado mau de um agente é uma questão de sorte, e que a revisão o apanha à segunda ou à terceira vez, podes deitar esse princípio fora. Uma empresa que não põe o seu contrato à frente do agente não recebe um leque de interpretações entre as quais um revisor possa escolher. Recebe em todo o lado a mesma interpretação razoável e errada, defendida sempre pelos mesmos testes.
É essa última parte que sai cara. Ao fim de 30 tickets, os braços de controlo deixaram para trás 57 e 52 regras não conformes, das quais 21 e 12 eram violações frontais: dados pessoais numa exportação para a transportadora e nos logs, um preço riscado ilegal, pontos de fidelização em cartões-presente, stock sobrescrito sem deixar rasto. Pelo menos um terço ficou trancado por testes verdes que os próprios agentes escreveram.
A dívida não é só silenciosa, tem a CI a defendê-la. Voltamos ao tema em falhas de lógica de negócio no código gerado por IA.
Um CLAUDE.md perfeito resolve o problema?
Leva-te a dois terços do caminho, e testámos isso em vez de o assumir. Depois da tarefa 22, a diferença levantava uma objeção legítima: o braço com ficheiro alguma vez teve uma hipótese a sério? Pré-registámos então uma alteração ao protocolo e substituímos a secção desatualizada pelo corpus completo das 49 regras, verbatim, com os literais de máquina todos lá, apresentado como acabado de sincronizar pela engenharia. Mais forte do que isto, «põe as regras no repositório» não consegue ser.
Sessenta e quatro por cento é uma melhoria real e não vamos fingir que não é. Também é o teto, custa exatamente o mesmo em tokens, e as quatro falhas ensinam alguma coisa. O braço com ficheiro acertou nas regras para onde o ticket apontava e falhou noutras duas espécies.
Primeiro, nos pormenores periféricos de uma regra que de resto tinha acertado. Com 403 ADJUSTMENT_LIMIT para lá de mais ou menos 30 unidades escrito verbatim no seu ficheiro, fixou o limiar exato de 30 e respondeu com um 403 em prosa, sem o literal. A diluição também age dentro de uma única regra, não apenas ao longo do documento.
Segundo, nas regras transversais, aquelas que o ticket não nomeia. A regra que proíbe escritas diretas nas quantidades de stock estava no ficheiro, verbatim, e perdeu três vezes em três contra o hábito do código que tinha à frente. O código que já lá está é uma instrução implícita mais forte do que qualquer documento: mostra ao agente como se fazem as coisas naquela casa, está debaixo dos olhos dele enquanto escreve, e compila. Uma regra que contraria um hábito do código só ganha se chegar ao mesmo tempo que o hábito.
O que dizem as empresas de segurança sobre os ficheiros de regras?
As duas coisas, muitas vezes dentro do mesmo produto, e quase nunca com uma medição por trás.
O argumento otimista foi feito cedo e foi bem feito. Em junho de 2025, Rami McCarthy, da Wiz, publicou Rules Files for Safer Vibe Coding e abriu o código de um conjunto de regras de segurança de base para o Cursor, o Windsurf, o Copilot, o AGENTS.md do Codex e o CLAUDE.md do Claude. A tese é que «os ficheiros de regras são um método ideal para centralizar e uniformizar estas melhorias de prompting orientadas à segurança», com uma ressalva que é do próprio artigo: «o melhor ficheiro de regras de segurança é o que é feito à medida da tua organização». Sobre a classe de regras a que ele aponta, a postura genérica de código seguro, não temos nada que o contrarie.
O argumento cético costuma ser sobre quem pode editar o ficheiro, e não sobre se o modelo o segue. O guia da Kodem para proteger os editores de código com IA, publicado a 31 de outubro de 2025 por Mahesh Babu, defende que as funcionalidades de proteção destas ferramentas «são frequentemente desativadas na prática», o que deixa «um ambiente onde código não confiável ou ficheiros de regras envenenados podem executar sem escrutínio». É um problema real, e é outro problema. Uma regra pode falhar porque alguém a desligou. Também pode falhar porque o modelo a diluiu, com o ficheiro perfeitamente intacto.
Depois há o padrão que diz tudo sem dizer nada: fornecedores que lançam ao mesmo tempo um ficheiro de regras e um produto de injeção de contexto. A Sonar publica um AGENTS.md para o seu workflow de agente, com a indicação de «pôr este ficheiro na raiz do repositório como ficheiro de instruções do agente», e vende o Vortex, que «injeta o contexto e as restrições certas do projeto para que os agentes comecem com clareza». A Endor Labs lê o teu CLAUDE.md como declaração de intenções para o seu scanner, e notava a 7 de setembro de 2026 que «um CLAUDE.md que diz que todas as rotas de API são autenticadas pelo nosso middleware de SSO dá ao scanner uma informação que nenhum pattern matching traria à superfície».
Nenhum deles publicou uma taxa de cumprimento, e a Anthropic também não, tanto quanto conseguimos apurar. Até agora a discussão assentava em afirmações e em tópicos do GitHub. Agora assenta num grande estudo fatorial sobre a estrutura do ficheiro e num estudo pequeno sobre o caso difícil. Continua a ser pouco. Menos pouco do que era.
O que vale a pena mudar e o que não vale?
Começa pelo que a evidência já exclui, porque é aí que a maioria das equipas gasta o esforço. McMillan testou, de forma fatorial e à escala, as quatro coisas que todos os guias para escrever um bom CLAUDE.md recomendam.
| O conselho habitual | O que o estudo fatorial encontrou |
|---|---|
| Encurta o ficheiro | Nenhum efeito detetável do tamanho, com um fator de Bayes a favor do nulo |
| Põe a regra importante no topo | Nenhum efeito detetável da posição da instrução |
| Divide-o em vários ficheiros, ou usa imports | Nenhum efeito detetável da arquitetura do ficheiro |
| Elimina as contradições com ficheiros adjacentes | Nenhum efeito detetável dos conflitos, com um fator de Bayes a favor do nulo |
Duas ressalvas. A documentação da Anthropic recomenda mesmo ficar-se por «menos de 200 linhas por ficheiro CLAUDE.md», por razões de orçamento de contexto, e emagrecer um ficheiro inchado é boa higiene. Mas se estás a apostar um resultado de cumprimento em passar de 300 linhas para 150, a única experiência direta que existe diz que não vais medir diferença nenhuma.
Quanto ao efeito «lost in the middle», citado a toda a hora para justificar subir as regras para o topo: McMillan comparou uma regra na linha 2 com a mesma regra na linha 250. Nenhum efeito.
O que tem apoio é aquilo que nenhum dos dois estudos se propôs medir, a distância à escrita. O decaimento dentro da sessão, do lado dele, e a nossa divisão entre regra servida e não servida são o mesmo fenómeno visto de duas pontas. Das 58 regras avaliadas que a nossa camada serviu no momento da edição, 55 saíram exatas (95 %). Das 6 que não conseguiu servir, 4 não saíram. Mesmo agente, mesma sessão, mesma inteligência, distância diferente. Por isso a arrumação faz-se com uma pergunta só: o agente conseguiria adivinhar esta regra?
Deixa no ficheiro aquilo que o ficheiro faz bem: comandos de build, organização do projeto, convenções que um engenheiro competente adotaria de qualquer maneira, e tudo o que o agente nunca produziria por iniciativa própria. É essa última categoria que o estudo com potência estatística mediu, e aí o ficheiro funciona.
Passa os teus valores arbitrários para o momento da edição. Códigos de erro, formatos de nomes de ficheiro, limiares, a forma da tua linha de auditoria, as colunas que a tua exportação pode conter. São as regras que um ficheiro trata pior, porque o agente já tem uma resposta plausível concorrente e o ficheiro está a discutir com ele a trinta mil tokens de distância. São também, quase sempre, as regras que têm um regulador ou um cliente por trás.
Deixa as regras virarem estrutura. Quando uma regra chegava no momento da edição, o agente construía o mecanismo que ela implica: um livro de movimentos, uma chave de idempotência, um evento de auditoria. As tarefas seguintes reaproveitavam-no, às vezes sem a regra voltar a ser servida. Quando o ticket do registo de auditoria chegou, na tarefa 14, o braço que vinha a emitir eventos de auditoria desde o princípio fechou o assunto em 334 linhas; os dois que nunca tinham escrito nenhum tiveram de o construir de raiz, em 1107 e 1620. A conformidade feita pelo caminho custou cinco vezes menos código do que a conformidade recuperada a posteriori.
Para tudo o que nunca pode acontecer, deixa de usar prosa. A resposta da Anthropic não deixa margem: «para bloquear uma ação independentemente do que o Claude decidir, usa antes um hook PreToolUse», porque «as instruções do CLAUDE.md moldam o comportamento do Claude, mas não são uma camada de imposição rígida». Uma regra que não te podes dar ao luxo de perder é um hook ou uma permissão, não um ponto numa lista. E revê o próprio ficheiro como se fosse código, porque quem puder fazer commit nele está a escrever a política do teu agente: ver injeção por ficheiro de instruções.
Quanta confiança merecem estes números?
Menos do que os de McMillan, e preferimos ser nós a dizê-lo. Fizemos uma execução por braço e por tarefa, sobre uma base de código, com um modelo, em 25 tarefas com regras associadas e cerca de 65 regras avaliadas por braço. Ele fez 1650 sessões e 16 050 observações. As diferenças principais (13 % contra 87 %, 64 % contra 100 %) são grandes de mais para serem acidentes de contagem, mas as distribuições secundárias devem ser lidas com esta amostra em mente. Não publicamos nenhum valor p, e é de propósito.
O corpus também fomos nós que o escrevemos, e vendemos uma ferramenta que entrega regras no momento da edição. Contra esse enviesamento pusemos três salvaguardas: corpus e grelhas de avaliação selados antes de qualquer execução, cada regra classificada à partida conforme fosse ou não adivinhável, tickets verificados por máquina contra literais deixados no enunciado. Os auditores cegos são modelos, não pessoas. Uma replicação com revisores humanos é o passo seguinte óbvio e não o demos. O estudo também conta onde é que o nosso próprio braço perdeu.
Mais quatro, em traços rápidos. Duas sobreaplicações, correções certas feitas no momento errado. Quatro regras que nunca chegaram a ser recuperadas, todas de famílias para onde o ticket não apontava, e que explicam quatro dos sete desvios do nosso braço. Seis tarefas com entrega degradada por uma falha de autenticação e uma paragem de canal, contadas contra nós em vez de excluídas. Treze falsos positivos nas guardas de comandos.
A experiência dele é a melhor, o caso difícil é o nosso. Ele isolou a estrutura de forma limpa, com um alvo que não tinha instinto concorrente nenhum; nós escolhemos alvos que não são outra coisa senão instinto concorrente, e pagámos essa escolha em potência estatística. Juntas, as duas dizem uma coisa simples: não é a estrutura do ficheiro que está a falhar, e as regras em que um ficheiro falha são precisamente aquelas por causa das quais o escreveste.
O que vendemos, sem rodeios
A injeção em agent-time é o nosso produto, este estudo mede-a, e o mesmo estudo diz o que ela não consegue fazer.
O VibeDefend instala-se no ambiente do agente, não no teu repositório. Um hook dispara antes de cada edição de ficheiro e põe no contexto do modelo as regras relevantes para aquele ficheiro e aquela intenção, mesmo antes da escrita. Ao longo das 30 tarefas foram 669 injeções de regras de negócio e 1078 injeções de regras de segurança, por cerca de um dólar por ticket.
O que não faz é impor. A tarefa M24 está neste artigo precisamente por ser a fronteira mais nítida daquilo que vendemos. A parte determinística da camada é a guarda sobre a ação, não a regra no contexto, e preferimos dizer qual das duas é um controlo a deixar subentender que as duas o são. O modelo mais amplo está em segurança dos agentes de código com IA.
Perguntas frequentes
O Claude Code segue mesmo o CLAUDE.md?
Lê o ficheiro no arranque de cada sessão e segue-o de forma inconsistente, com a inconsistência concentrada nos valores concretos. A documentação da Anthropic diz que o Claude «trata-os como contexto, não como configuração imposta» e que «não há garantia de cumprimento estrito». No nosso estudo de 90 execuções autónomas, uma secção de regras realista produziu o mesmo número de valores concretos acertados que não ter ficheiro de regras nenhum: 7 de 55. Nas 13 regras em que o ficheiro trazia o valor certo verbatim, o agente escreveu-o tal e qual 4 vezes.
Como se escreve um bom CLAUDE.md?
Separa as tuas regras entre as que o modelo consegue adivinhar e as que não, e deixa de afinar a estrutura do ficheiro. O único teste fatorial direto, sobre 1650 sessões do Claude Code, não encontrou efeito detetável do tamanho do ficheiro, da posição da instrução, da divisão em vários ficheiros nem das contradições com ficheiros vizinhos, e uma instrução na linha 2 não rendeu mais do que a mesma na linha 250. Deixa no ficheiro o que um engenheiro competente aplicaria de qualquer maneira, passa os teus valores arbitrários para o momento da escrita e transforma em hook aquilo que nunca pode acontecer.
O que deve conter um CLAUDE.md?
Comandos de build, organização do projeto, convenções da casa e tudo aquilo que o agente nunca produziria por iniciativa própria. É essa última classe que o estudo mais bem dimensionado mediu, e aí o ficheiro cumpre. O que não pertence ali são os teus valores arbitrários, códigos de erro, formatos de nome de ficheiro, limiares: nas 13 regras em que o nosso ficheiro trazia o valor exato preto no branco, o agente escreveu-o tal e qual 4 vezes.
Que tamanho deve ter um CLAUDE.md?
O que couber no teu orçamento de contexto, porque não é o tamanho que decide se uma regra é cumprida. A Anthropic recomenda ficar abaixo das 200 linhas por ficheiro, e emagrecer um ficheiro inchado é boa higiene. O estudo fatorial não encontrou efeito detetável do tamanho, apoiado por um fator de Bayes a favor do nulo, por isso não contes com um ficheiro mais curto para mudar se uma dada regra sobrevive até à escrita.
O Claude Code lê o AGENTS.md ou só o CLAUDE.md?
Só o CLAUDE.md, a não ser que sejas tu a ligar o AGENTS.md. A documentação da Anthropic é explícita, o Claude Code lê CLAUDE.md e não AGENTS.md, com um import @AGENTS.md ou um link simbólico como ponte suportada. Nenhum dos dois é melhor do que o outro, porque o mecanismo é o mesmo, um documento carregado em contexto no arranque da sessão, e por isso o modo de falha também é o mesmo.
Porque é que o Claude Code não segue as minhas regras?
Quase sempre é diluição, não desprezo. O ficheiro é carregado uma vez e, à trigésima edição, é um fragmento antigo enterrado debaixo de dezenas de milhares de tokens de código, saídas de comandos e raciocínio. O estudo fatorial de Damon McMillan mede a mesma coisa pelo outro lado: cada função adicional que o agente gera está associada a uma descida de cerca de 5,6 % na probabilidade de cumprimento. A segunda causa é a tua própria base de código, que mostra ao agente como se fazem aqui as coisas e ainda por cima compila.
O CLAUDE.md serve mesmo para alguma coisa?
Serve para uma classe de regras, e não serve para aquela que te levou a escrever o ficheiro. O estudo de McMillan mediu uma anotação trivial, algo que o agente não tem razão para escrever se o ficheiro não lho pedir, e aí o ficheiro leva o cumprimento de quase nada a alguma coisa. O nosso pegou no caso inverso, regras para as quais o agente já tem uma resposta plausível concorrente, e uma secção de regras realista teve exatamente a nota de não haver ficheiro nenhum: 7 valores concretos em 55.
Deve pôr-se o CLAUDE.md no repositório?
Sim, e depois revê-lo como código, porque quem puder fazer commit nele está a escrever a política do teu agente. Mas pôr no repositório não é impor. A secção de regras do nosso estudo estava no repositório e era carregada no arranque de cada sessão, e o código que produziu era indistinguível do braço que não tinha ficheiro de regras nenhum.
Andrej Karpathy provou mesmo que um CLAUDE.md faz os erros cair de 40 % para 11 %?
Não encontrámos fonte primária nenhuma para esse número. Circula em fios de redes sociais e em reproduções em segunda mão, em mais do que uma forma, de 40 % ou de 41 % para 11 %, sem método publicado nem dimensão de amostra que possamos verificar. As medições que têm mesmo um artigo ou um protocolo por trás são bem menos lisonjeiras: McMillan não encontrou efeito detetável das quatro variáveis de estrutura em 1650 sessões, e as nossas 90 execuções deixam um ficheiro de regras realista empatado com a ausência de ficheiro.
Como é que se impõe mesmo uma regra no Claude Code?
Não é com prosa. A orientação da Anthropic é usar um hook PreToolUse para «bloquear uma ação independentemente do que o Claude decidir», e definições geridas para as permissões, já que «as regras de definições são impostas pelo cliente, independentemente do que o Claude decida fazer». Uma regra que não te podes dar ao luxo de perder pertence a um hook ou a uma permissão. Uma regra com a qual queres que o agente raciocine pertence ao contexto dele, no momento em que escreve.


