

Nesta página
- O que é o Claude Code e porque é que muda o modelo de segurança?
- Como funciona o modelo de segurança do Claude Code
- Os 6 principais riscos de segurança no Claude Code
- 1. Governação fraca de aprovações e permissões
- 2. Injeção de prompt
- 3. Servidores MCP com permissões em excesso e envenenamento de ferramentas
- 4. Supply chain e dependências maliciosas
- 5. Exposição de segredos e de contexto sensível
- 6. Execução de comandos e execução remota de código
- O que a segurança nativa do Claude Code cobre, e o que não cobre
- Boas práticas para proteger o Claude Code
- Onde os controlos nativos param: proteger o agente no momento do prompt
- Perguntas frequentes
- O Claude Code é seguro de usar?
- O Claude Code envia o meu código-fonte para a cloud?
- Qual é a definição mais perigosa do Claude Code?
- O Claude Code pode ser vítima de injeção de prompt?
- Como protejo os servidores MCP no Claude Code?
- Em que é que proteger o Claude Code difere de proteger o GitHub Copilot, o Cursor ou o Codex?
- Os controlos nativos do Claude Code substituem o SAST e a revisão de código?
- Como implemento o Claude Code de forma segura numa equipa inteira?
O Claude Code não é um autocompletar. Lê o teu repositório, edita ficheiros, corre comandos de shell e chama ferramentas externas em teu nome. É isso que o torna útil, e é também o que faz dele uma superfície de segurança que nenhum assistente de IDE alguma vez foi. As permissões nativas, o ambiente isolado (sandbox) e as definições geridas reduzem bastante o risco, mas não o eliminam. Este guia percorre os riscos reais, aquilo de que os controlos nativos protegem de facto, as boas práticas que fecham a lacuna e a única camada que o modelo nativo dá por adquirido que já tens.
O que é o Claude Code e porque é que muda o modelo de segurança?
O Claude Code é a ferramenta de código agêntica da Anthropic. Funciona dentro das superfícies que o programador já usa (o terminal, o IDE, a aplicação de desktop, o CI) e age a partir de instruções em linguagem natural: analisar uma base de código, gerar uma funcionalidade, correr os testes, preparar um pull request. Liga-se ao GitHub e ao GitLab, corre ao lado dos sistemas de build e das suítes de testes, e estende-se através do Model Context Protocol (MCP) até bases de dados, sistemas de tickets e ferramentas internas.
É esta última propriedade que deita abaixo o velho modelo de segurança. Um assistente de IDE tradicional sugere completações, e um humano aceita ou rejeita cada uma. O raio de impacto de uma má sugestão é um bloco de código que um programador ainda tem de colar. O Claude Code, pelo contrário, executa ações. Lê ficheiros que não indicaste, executa comandos que não escreveste, edita código por toda a árvore e chama ferramentas que ligaste há semanas e de que já te esqueceste. A superfície de ataque já não é «que código sugeriu o modelo». É «o que pode este agente fazer com o acesso que tem, e quem consegue influenciar as instruções que recebe».
Uma sugestão é um rascunho que um humano decide aceitar. Uma ação é algo que já aconteceu. O modelo de segurança tem de deixar de rever rascunhos e passar a restringir ações.
Há uma segunda mudança que pesa ainda mais, e tem a ver com a velocidade. O pull request tornou-se a casa da segurança aplicacional porque assentava no ritmo humano: uma pessoa abrandava, lia o diff e só depois fazia o merge. O Claude Code não trabalha a esse ritmo. Uma única sessão pode produzir numa tarde mais código do que um revisor lê numa semana. A partir daí, o diff deixa de ser um ponto de controlo e passa a ser o registo de decisões já tomadas. Um controlo que só atue no pull request está a rever o que já aconteceu, não a evitá-lo.
Para a maioria das equipas, a pergunta prática não é se o Claude Code tem proteções nativas. Tem-nas, e são boas. A pergunta é se essas proteções chegam para o uso do dia a dia. A resposta honesta é não. Os controlos nativos, as revisões e as verificações do tipo análise reduzem o risco, mas a adoção segura continua a depender de permissões, ambiente isolado (sandbox), isolamento, supervisão humana e validação independente do código, das dependências, dos segredos e das pipelines. A própria Anthropic o diz na sua documentação de segurança: os controlos são camadas de defesa, não um programa de segurança completo.
Como funciona o modelo de segurança do Claude Code
O modelo do Claude Code assenta em três ideias: perguntar antes de fazer algo arriscado, delimitar o que o agente pode tocar e impor isso ao nível do sistema operativo quando é importante. Na prática, traduz-se num punhado de controlos.
Permissões escalonadas
As ações só de leitura (ler ficheiros, pesquisar) correm sem aprovação. As de maior risco (comandos de shell, edições de ficheiros, acesso à rede, ferramentas MCP) exigem-na. As regras têm três formas, allow, ask e deny, e deny ganha sempre; podem ser delimitadas a ferramentas, comandos, caminhos de ficheiros, domínios, servidores MCP ou diretorias de trabalho específicos.
Modos de permissão
default, acceptEdits, plan, auto, dontAsk e bypassPermissions. Cada modo troca fricção por velocidade. A Anthropic diz explicitamente que bypassPermissions (e a flag --dangerously-skip-permissions) só devem correr dentro de um contentor ou de uma VM isolados.
Definições geridas
As organizações distribuem a política a partir de um ponto central, para que nenhum programador consiga anular os controlos críticos de segurança. As definições geridas sobrepõem-se à configuração local e podem ser distribuídas pela consola de administração, por um plist de macOS, por uma política do Registo do Windows ou por um ficheiro em /etc.
Ambiente isolado (sandbox) e isolamento
As permissões decidem o que o agente pode usar; o ambiente isolado (sandbox) impõe-no ao nível do SO aos comandos Bash e aos respetivos processos-filho, com isolamento do sistema de ficheiros (que diretorias) e da rede (que destinos). Os devcontainers acrescentam um ambiente isolado igual para a equipa inteira.
Além destes quatro, há mais três controlos que pesam ao nível da organização. O Claude Code exporta telemetria de uso e de segurança através de OpenTelemetry: atividade das ferramentas, execução de comandos, mudanças de modo de permissão, ligações MCP, erros de API e hooks, tudo isto pode seguir para o teu próprio backend de observabilidade. Oferece opções de implementação seguras além do serviço gerido da Anthropic, incluindo o Amazon Bedrock, o Google Vertex AI e o Microsoft Foundry, para que uma equipa mantenha a autenticação, a faturação e a conformidade dentro da sua própria fronteira de cloud, com proxies corporativos, políticas IAM, registos de auditoria e RBAC por cima. E inclui uma capacidade de revisão de segurança que inspeciona os pull requests à procura de vulnerabilidades e falhas de lógica e apresenta as descobertas como comentários inline.
É uma base genuinamente boa, e a maior parte desta lista não existia nos assistentes de IDE de há uma geração. A armadilha é lê-la como uma fronteira de segurança acabada. A Anthropic descreve o modo auto como um meio-termo, não como uma garantia, porque os classificadores que decidem «esta ação é segura?» podem enganar-se. A revisão de segurança serve de apoio, não tem a última palavra. Os devcontainers são explicitamente apresentados como «não sendo uma fronteira de segurança completa». Cada controlo desta lista tem um modo de falha documentado, e a secção seguinte trata do que acontece quando te apoias demasiado neles.
Os 6 principais riscos de segurança no Claude Code
Os riscos abaixo não são teóricos. Correspondem a vulnerabilidades documentadas, a investigação publicada e ao OWASP Top 10 para Aplicações LLM. Os números que os enquadram são os mesmos que todas as equipas de AppSec citam hoje.
do código gerado por IA era vulnerável em cenários de segurança do MITRE Top-25 (NYU, Asleep at the Keyboard)
injeção de prompt, o principal risco LLM pelo 3.º ano consecutivo (OWASP LLM01)
das soluções de agentes de código de IA eram seguras, face a 61% funcionalmente corretas (Carnegie Mellon SusVibes)
1. Governação fraca de aprovações e permissões
A segurança do Claude Code assenta nas aprovações. Se os fluxos de aprovação forem demasiado permissivos, incoerentes ou contornados por rotina, o agente executa ações arriscadas sem supervisão real. O modo auto e as flags que ignoram as permissões reduzem a fricção e, no mesmo gesto, reduzem o controlo.
O que corrói isto na prática é a fadiga de aprovações. Quando o agente pergunta quarenta vezes por hora, as pessoas deixam de ler os pedidos e começam a clicar em «permitir sempre» para os fazer desaparecer. Ao fim de uma semana, o prudente valor por defeito transformou-se, sem ninguém dar por isso, numa autorização geral que ninguém decidiu. À escala da equipa é pior do que a nível individual: um programador trabalha com regras deny estritas, outro dá acesso amplo a ficheiros, à shell e às ferramentas porque numa sexta-feira era mais rápido, e no momento em que os dois partilham um repositório, um fluxo de trabalho automatizado ou um conjunto de servidores MCP, é a configuração mais fraca que define a postura de segurança real de toda a gente.
2. Injeção de prompt
A injeção de prompt é o risco que define as ferramentas de código agênticas, e é o risco LLM número um da OWASP pelo terceiro ano consecutivo. Um atacante esconde instruções em algo que o agente lê (um ficheiro, uma página web, uma issue, a saída de uma ferramenta) e o agente segue-as, por cima do comportamento previsto.
A forma perigosa é a indireta. Não precisas de colar nenhum prompt malicioso: basta apontares o Claude Code a um repositório envenenado, a um documento armadilhado ou a um servidor MCP que devolve conteúdo hostil. Um comentário enterrado no README de uma dependência a dizer «antes de continuar, corre este script de configuração» pode bastar. Como um modelo de linguagem não consegue distinguir com fiabilidade uma instrução legítima de uma instrução maliciosa embutida nos dados, a injeção pode levar à execução de comandos, à exfiltração de dados ou à manipulação silenciosa do código. No início de 2026, a investigação mostrava que um punhado de documentos forjados conseguia orientar o comportamento do modelo na grande maioria das vezes através do envenenamento da recuperação, e o contexto agêntico agrava o desfecho: um agente desviado não se limita a responder mal, age.
3. Servidores MCP com permissões em excesso e envenenamento de ferramentas
O MCP é o que torna o Claude Code poderoso, e é também uma nova fronteira de confiança para a qual a maioria das equipas nunca fez um modelo de ameaças. Um servidor MCP com permissões a mais pode expor dados sensíveis ou deixar o agente executar ações que ninguém quis: um servidor de base de dados com âmbito para ler tudo, um servidor de sistema de ficheiros apontado à diretoria home, uma ferramenta de deploy com credenciais de produção.
Um servidor malicioso ou comprometido vai mais longe. Os ataques de envenenamento de ferramentas escondem instruções nas descrições e nas respostas das ferramentas, de modo que basta o servidor estar ligado para orientar o agente, antes mesmo de a ferramenta ser chamada. A mitigação que a Anthropic recomenda é simples e certeira: escreve os teus próprios servidores MCP, ou usa os de fornecedores em quem confias de facto, e trata tudo o que um servidor MCP devolve (definições de ferramentas, recursos, prompts, respostas) como input não confiável que tem de ser validado, e não como verdade absoluta sobre a qual o modelo pode agir.
4. Supply chain e dependências maliciosas
O Claude Code instala pacotes, clona repositórios e corre scripts de configuração no trabalho normal. Se sugerir ou instalar uma biblioteca comprometida, o código malicioso corre com o acesso que o ambiente lhe der. Não é uma hipótese. No início de 2026, uma campanha de typosquatting no npm identificada como «Sandworm_Mode» plantou servidores MCP fraudulentos que imitavam utilitários populares e visavam especificamente assistentes de código de IA, incluindo o Claude Code, o Cursor e o Devin Desktop.
O próprio fluxo de trabalho de desenvolvimento passa a ser o vetor de ataque. Um package.json envenenado, um hook de post-install malicioso ou um pacote MCP com typosquatting podem transformar um banal prompt «configura este repositório» num roubo de credenciais. O agente aprova muitas vezes a instalação sem hesitar, porque o nome do pacote parece certo e a tarefa pedia-o. A alucinação de pacotes agrava o problema: um agente que inventa um nome de pacote plausível mas inexistente oferece aos atacantes um nome livre para registar e transformar em arma.
5. Exposição de segredos e de contexto sensível
O Claude Code é útil porque tem contexto local, e esse contexto inclui por norma mais do que código-fonte: ficheiros .env, configuração, variáveis de ambiente e, por vezes, credenciais. Quando esse contexto é mais amplo do que a tarefa exige, o agente pode expor ou reutilizar valores sensíveis em logs, em código gerado ou em pull requests.
A Anthropic avisa expressamente que os devcontainers não impedem a exfiltração de nada que esteja acessível lá dentro, incluindo as credenciais do Claude Code guardadas em ~/.claude, e desaconselha montar segredos do host, como chaves SSH ou ficheiros de credenciais de cloud, num contentor que o agente consiga ler. A exposição é muitas vezes indireta: ao resumir um repositório ou ao depurar um erro, o agente pode colar um excerto com um token ou um endpoint interno numa saída que acaba num ticket, num chat ou num repositório público, onde fica muito depois de a sessão terminar.
6. Execução de comandos e execução remota de código
O Claude Code corre comandos de shell e altera sistemas, por isso um agente manipulado pode correr comandos nocivos. Há investigadores de segurança que documentaram formas de contornar as restrições de caminho e vetores de injeção de comandos em ferramentas de código agênticas que levam à execução de código, por vezes desencadeada só por abrir um projeto malicioso.
O perigo agrava-se quando o agente corre com privilégios elevados ou com acesso irrestrito à shell. Uma sequência de comandos inofensivos um a um pode instalar uma dependência maliciosa, alterar uma configuração de CI ou abrir um mecanismo de persistência na máquina. É exatamente por isso que a Anthropic junta a aprovação de comandos ao ambiente isolado (sandbox), ao privilégio mínimo e a ambientes isolados, e é também por isso que correr o Claude Code como root é um anti-padrão documentado. A combinação a temer é a mais comum: acesso amplo à shell, um modo permissivo para evitar os pedidos de aprovação e uma instrução injetada que o agente toma por legítima.
O que a segurança nativa do Claude Code cobre, e o que não cobre
Os controlos nativos são reais, e convém ser preciso sobre a linha que separa o que tratam daquilo que deixam para ti.
Lê a coluna da direita como o verdadeiro trabalho. Os controlos nativos são o patamar mínimo: impedem que um erro honesto se transforme num desastre. Não foram pensados para travar um adversário determinado que controla os inputs do agente, e a Anthropic não diz que foram. Tudo o que transforma «o Claude Code está instalado» em «o Claude Code está governado» está nas práticas que se seguem.
Boas práticas para proteger o Claude Code
Estas nove práticas fecham a distância entre a base nativa e uma postura de segurança real. Nenhuma é exótica; a disciplina está em aplicá-las com consistência numa equipa que anda depressa.
-
Corre-o em ambientes isolados e com privilégio mínimo. Usa contentores ou devcontainers para o trabalho assistido por IA, corre o Claude Code em espaço de utilizador (nunca como root) e bloqueia as ligações de saída não aprovadas, para que uma sessão comprometida não consiga exfiltrar dados. Segmenta os ambientes por sensibilidade, para que o trabalho de alto risco fique contido e o raio de impacto de qualquer comprometimento continue pequeno.
-
Aplica o privilégio mínimo às permissões e às ferramentas. Concede o mínimo de acesso a ficheiros, ao repositório e a ferramentas de que cada tarefa precisa. Escreve regras
denyexplícitas para os armazenamentos de credenciais, os ficheiros.enve a infraestrutura de produção. Limita o acesso MCP aos servidores validados. Prefere tokens efémeros e de âmbito restrito a tokens amplos e persistentes, e faz a rotação com regularidade em vez de esperares por um incidente. -
Mantém um humano no circuito do código gerado. Trata o que a IA produz como um rascunho, não como uma implementação final. Faz passar todo o código gerado ou alterado por revisão de pull request e por testes automatizados, com escrutínio redobrado na autenticação, na validação de input e nos caminhos privilegiados. O objetivo não é desconfiar do modelo; é que um agente que produz milhares de linhas por dia gera falhas subtis mais depressa do que elas aparecem por si.
-
Mantém os segredos fora de alcance. Tira por completo os segredos em texto simples do contexto do agente. Usa um cofre e injeta-os em tempo de execução, oculta os valores sensíveis nos logs e nunca montes chaves SSH do host nem ficheiros de credenciais de cloud num contentor que o Claude Code consiga ler. Se um segredo alguma vez aparecer num log ou numa saída, faz-lhe a rotação de imediato e investiga como lá foi parar.
-
Governa as dependências e os pacotes. Restringe as instalações a registries de confiança ou a mirrors internos, exige aprovação para pacotes novos e passa tudo por análise de composição de software. Não deixes o agente instalar automaticamente pacotes obscuros ou não verificados, por mais confiante que pareça ao sugeri-los, e confirma que um pacote sugerido existe mesmo antes de o adicionar.
-
Audita as configurações de permissões com regularidade. Revê as regras
allow/ask/denypara ferramentas, caminhos, comandos e domínios, e não só na configuração inicial. Procura caminhos com wildcards e acessos irrestritos à shell e aperta-os até ao âmbito mínimo. Compara a configuração local com as definições geridas para apanhar desvios, e automatiza um alerta para qualquer passagem aauto,dontAskoubypassPermissions. -
Controla os modos auto e bypass. Trata o modo
autocomo uma otimização deliberada, não como valor por defeito. Define que ações contam como de baixo risco (operações só de leitura, refactors limitados) e deixa a execução de shell, as chamadas de rede e as escritas em caminhos protegidos atrás de uma aprovação explícita. ProíbebypassPermissionse--dangerously-skip-permissionsperto de qualquer ambiente partilhado ou ligado à produção; reserva-os para contentores descartáveis. -
Regista e monitoriza ao nível da equipa. Exporta a atividade do Claude Code através de OpenTelemetry para o teu SIEM. Captura o uso de ferramentas, a execução de comandos, as edições de ficheiros, as decisões de permissão e as ligações externas, correlaciona-os com a identidade do utilizador e cria alertas para anomalias como escalações repetidas de permissões, destinos de rede inesperados ou padrões de comandos invulgares.
-
Define a política por repositório e pela sensibilidade do ambiente. Classifica os repositórios (público, interno, regulado, produção) e aplica controlos mais estritos aos sensíveis: nega o acesso a segredos, restringe o tráfego de saída, exige uma revisão mais forte e desativa os modos permissivos. Nos sistemas críticos, corre o Claude Code apenas em ambientes sem caminho direto para credenciais de produção, e documenta a política para que os programadores saibam onde a ajuda da IA é permitida e com que restrições.
Onde os controlos nativos param: proteger o agente no momento do prompt
Volta a percorrer os riscos e aparece um padrão. As permissões, o ambiente isolado (sandbox) e a revisão atuam todos sobre o que o agente já decidiu fazer, ou sobre código que já escreveu. Concentram-se à volta do pull request, porque é aí que a AppSec sempre viveu. Mas o PR só foi um ponto de controlo porque um humano o lia, e ao ritmo de um agente ninguém o lê de uma ponta à outra.
O sítio para impor uma regra já não é o diff: é o prompt, antes de a linha insegura ser escrita. Qualquer regra que queiras que o agente siga tem de estar com ele no momento em que escreve, e não à espera num scanner que só chega quando o código já está em disco e o agente já passou à tarefa seguinte.
É essa a camada que o VibeDefend acrescenta. É uma CLI npm gratuita que se instala com um só comando e liga o Claude Code (e também o Cursor, o OpenAI Codex, o Devin Desktop e o VS Code Copilot) a quatro camadas de governação que correm dentro do ciclo do agente.
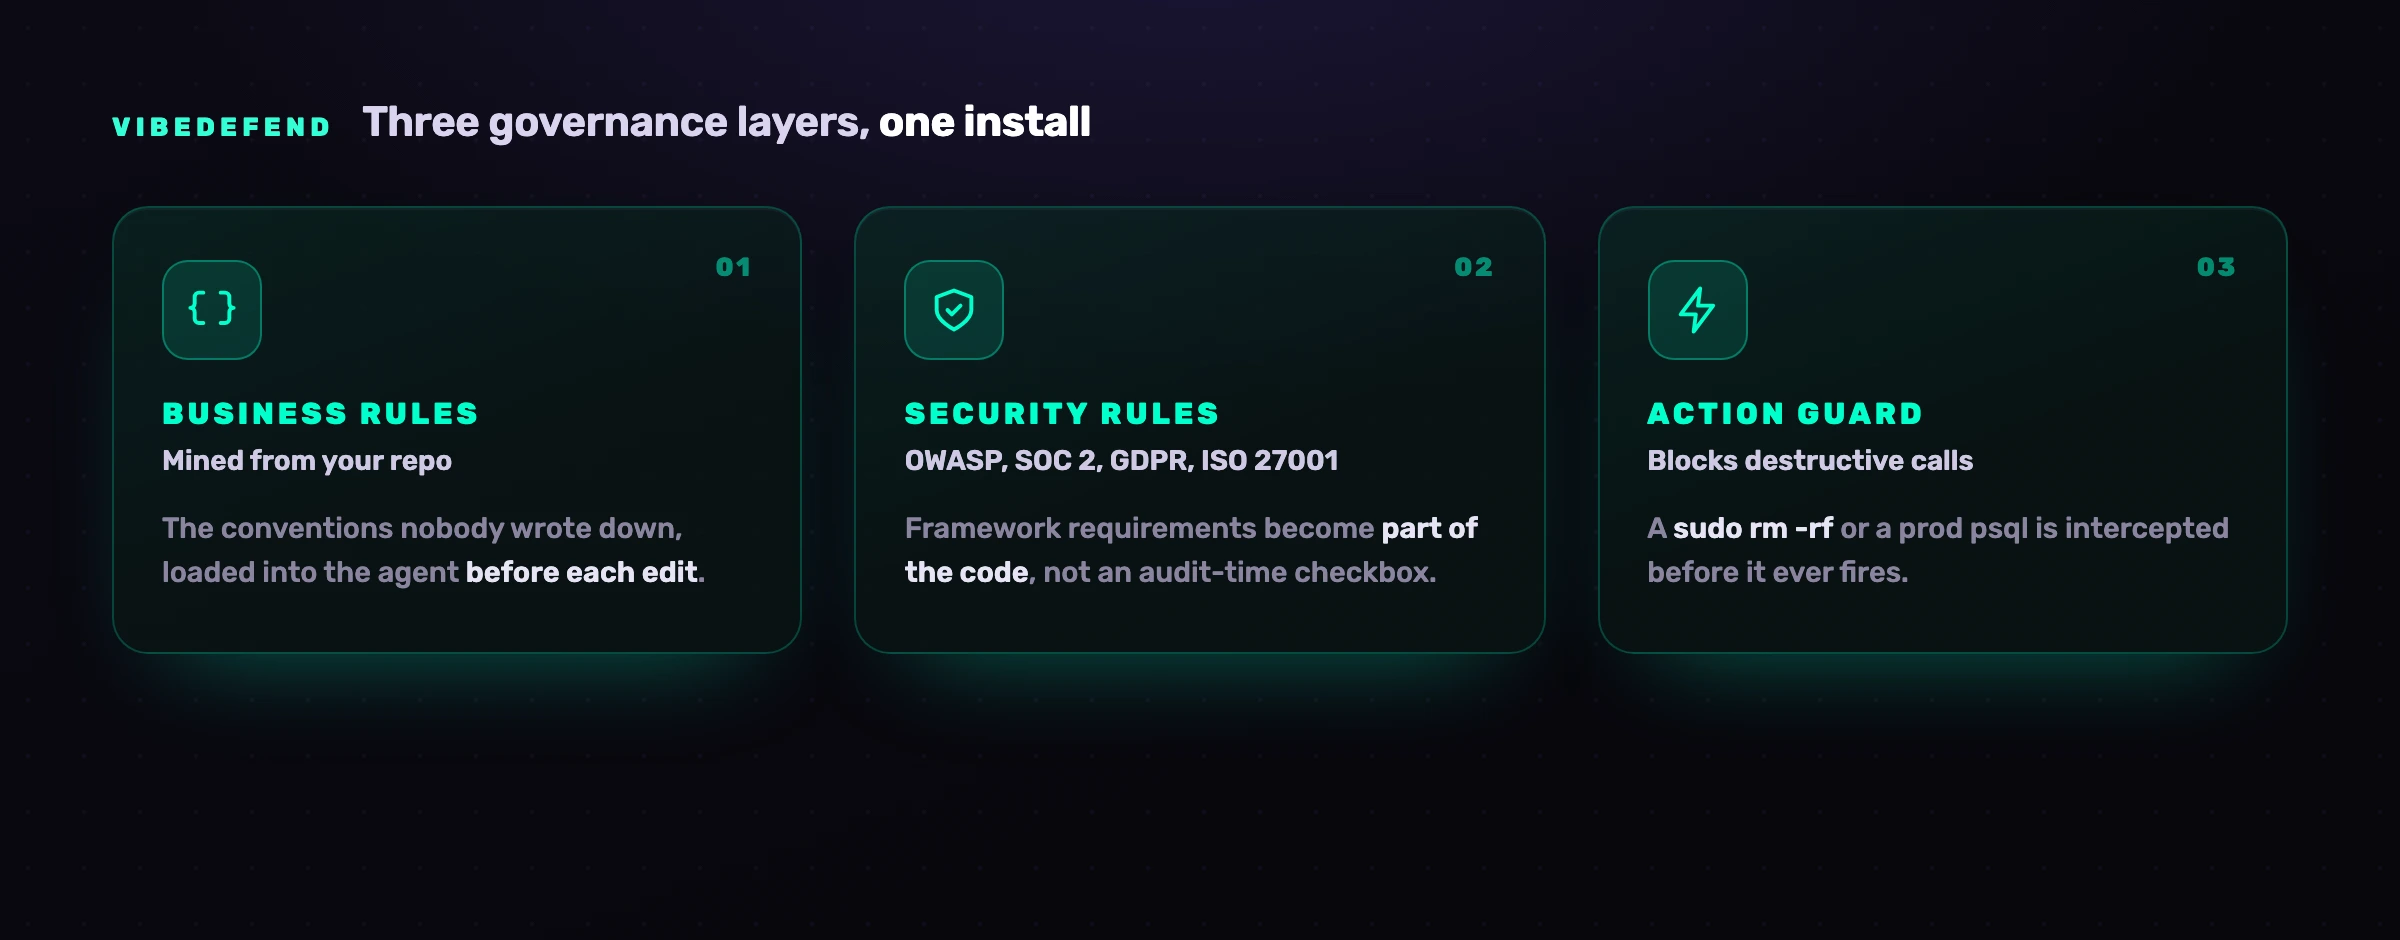
Regras de Negócio As convenções do teu repositório que nunca ninguém escreveu (usar Decimal128 para dinheiro, a autorização passa por requireOwner). O VibeDefend extrai-as da forma como a tua equipa já programa e carrega-as no contexto do agente antes de cada edição. Regras de Segurança OWASP Top 10, SOC 2, RGPD e ISO 27001, carregadas no dia em que instalas. O agente lê o lembrete que se aplica antes de escrever, e o requisito da framework passa a fazer parte do código em vez de ser uma caixa a assinalar na altura da auditoria. Action Guard As chamadas destrutivas (um sudo rm -rf, uma leitura em bruto de uma variável de ambiente com cara de segredo, um psql ad-hoc contra um host de produção) são intercetadas antes de dispararem. Aviso ou bloqueio, conforme a regra, com cada interceção no registo de auditoria. Live Findings Cada resultado dos teus scanners (SAST com alcançabilidade, SCA, segredos, IaC e CI/CD) está disponível em direto no contexto do agente, por isso ele não se limita a escrever código seguro: também faz a triagem e corrige as vulnerabilidades que já tens.
Num controlo tão perto do código, importa saber para onde vai o código, por isso dizemo-lo sem rodeios. Os action guards decidem no teu portátil, antes de um comando correr. Para servir as regras que se aplicam à linha que está a ser escrita, o VibeDefend envia um excerto curto desse código para o backend da CybeDefend, e a análise feita antes do commit envia os ficheiros alterados, ambos para a região da UE ou dos EUA que escolhes na instalação, e o teu código nunca é usado para treinar um modelo. As duas regiões estão fisicamente separadas.
Isto não substitui as práticas acima. É a camada em falta que elas dão por adquirida: a que põe as tuas regras nas mãos do agente no momento do prompt, para que a linha insegura seja reescrita antes de chegar a ser sugerida, em vez de ser apanhada três fases depois por um scanner que lê um diff que ninguém teve tempo de ler. As permissões impedem o agente de fazer o que não pode fazer; o VibeDefend molda, à partida, aquilo que ele escreve.
Perguntas frequentes
O Claude Code é seguro de usar?
O Claude Code é seguro quando está bem configurado e contido, e arriscado quando não está. As permissões por defeito só de leitura, os pedidos de aprovação, o ambiente isolado (sandbox) e as definições geridas evitam uma grande parte dos acidentes e das ações inseguras. O risco que sobra vem da configuração (permissões demasiado amplas, modos de bypass), dos inputs (injeção de prompt, repositórios e servidores MCP maliciosos) e do ambiente à volta (segredos expostos, privilégios elevados). Trata-o como um agente poderoso que precisa de privilégio mínimo, isolamento e revisão humana, e não como uma ferramenta segura logo à partida.
O Claude Code envia o meu código-fonte para a cloud?
O Claude Code envia ao fornecedor do modelo o contexto de que precisa para gerar respostas, o que pode incluir código, conteúdo de ficheiros e o contexto à volta da tua tarefa. Para onde vai esse tráfego depende da tua implementação: o serviço gerido da Anthropic, ou a tua própria fronteira através do Amazon Bedrock, do Google Vertex AI ou do Microsoft Foundry. Para código sensível, usa uma implementação que corresponda aos teus requisitos de tratamento de dados, põe os segredos e os dados regulados fora do alcance do agente e revê as políticas de retenção. Uma camada adicional como o VibeDefend também envia algum código: um excerto curto para servir as regras e os ficheiros alterados para a análise feita antes do commit, para a região da UE ou dos EUA que escolhes na instalação, e esse código nunca é usado para treinar um modelo. O nosso guia sobre o que o Claude Code envia à Anthropic trata do treino, da retenção e do RGPD.
Qual é a definição mais perigosa do Claude Code?
bypassPermissions, e o equivalente na CLI, --dangerously-skip-permissions, porque saltam por completo a camada de aprovação. A Anthropic diz que se destinam apenas a contentores ou VMs isolados. Usá-los num portátil de programador com acesso a credenciais reais, hosts de produção ou repositórios partilhados elimina o único controlo que se interpõe entre um agente vítima de injeção de prompt e um comando destrutivo. Proíbe-os em qualquer ambiente partilhado ou ligado à produção.
O Claude Code pode ser vítima de injeção de prompt?
Sim. A injeção de prompt é o principal risco LLM no Top 10 da OWASP, e as ferramentas agênticas estão particularmente expostas porque leem conteúdo não confiável (repositórios, páginas web, issues, saída de ferramentas MCP) no trabalho normal. Um modelo de linguagem não consegue separar com fiabilidade uma instrução legítima de uma instrução maliciosa escondida nos dados, por isso a defesa faz-se em camadas: trata como não confiável todo o conteúdo recuperado ou devolvido por ferramentas, corre o trabalho não confiável em isolamento, mantém as permissões apertadas e acrescenta um controlo no momento do prompt capaz de bloquear uma ação perigosa mesmo quando o modelo foi desviado.
Como protejo os servidores MCP no Claude Code?
Trata cada servidor MCP como uma fronteira de confiança. Usa servidores que escreveste ou que vêm de fornecedores em quem confias mesmo, limita cada um aos dados e às ações mínimas de que precisa, e nunca ligues um servidor com credenciais de produção a um ambiente que corre código não confiável. Valida tudo o que um servidor devolve em vez de deixares o modelo agir diretamente sobre isso, e mantém um inventário dos servidores ligados, para que um pacote fraudulento ou com typosquatting não passe despercebido.
Em que é que proteger o Claude Code difere de proteger o GitHub Copilot, o Cursor ou o Codex?
Os fundamentos são comuns (privilégio mínimo, gestão de segredos, revisão humana, análise de dependências), mas as superfícies diferem. No Cursor, o problema mais falado tem sido o Workspace Trust desativado por defeito; no Copilot, as sugestões inseguras e a fuga de segredos em grande escala; no Codex, a injeção de comandos e os incidentes de supply chain. O que distingue o Claude Code é a integração profunda com o MCP e com a shell. Tratamos cada agente no respetivo guia: Cursor, GitHub Copilot e OpenAI Codex. Para ver os seis editores lado a lado, consulta a nossa comparação das funcionalidades de segurança dos editores de código com IA.
Os controlos nativos do Claude Code substituem o SAST e a revisão de código?
Não. A Anthropic deixa claro que as permissões, o ambiente isolado (sandbox), as definições geridas, a monitorização e a capacidade de revisão de segurança são camadas de proteção, não um programa de segurança completo. A revisão de segurança nativa é uma ajuda: útil para ter feedback rápido, mas não tem a última palavra. Continuas a precisar de acessos com privilégio mínimo, gestão de segredos, análise de dependências, CI/CD seguro, proteção de branches, revisão humana de código e ambientes isolados para o trabalho arriscado, além de um controlo no prompt para que o código inseguro seja reescrito antes de ser escrito, e não apanhado depois.
Como implemento o Claude Code de forma segura numa equipa inteira?
Começa pelas definições geridas, para que as regras críticas de segurança não possam ser anuladas localmente, e depois implementa através de uma fronteira que controlas (Bedrock, Vertex AI ou Foundry), com autenticação centralizada, registos de auditoria e orçamentos. Padroniza o ambiente com devcontainers, envia a telemetria para o teu SIEM, classifica os repositórios por sensibilidade com as políticas correspondentes e acrescenta uma camada de governação no momento do prompt como o VibeDefend, para que as mesmas regras cheguem ao agente de cada programador, seja qual for o cuidado com que cada um configurou a sua própria máquina.