


Nesta página
- O que quer dizer «contexto» para um agente de programação?
- Quais são os limites do CLAUDE.md, do AGENTS.md e dos skills?
- CLAUDE.md: lido uma vez, seguido quando calha
- AGENTS.md: o mesmo ficheiro, partilhado por mais agentes
- Skills: carregados quando o agente se lembra deles
- O que nenhum deles faz
- Porque é que o agente perde a regra antes de escrever?
- CLAUDE.md, rules, skills, MCP ou hooks: o que vai para onde?
- Como é que se entrega uma regra no momento da edição?
- Onde é que a solução caseira deixa de chegar?
- Como é o método completo?
- Passo 1: extrair as regras do teu próprio código
- Passo 2: pôr uma pessoa a validar cada regra
- Passo 3: entregar a regra certa na edição
- Passo 4: verificar o resultado no fim da cadeia
- O que muda quando a regra chega no momento da edição?
- Por onde começar esta semana?
- Perguntas frequentes
- Como dar contexto ao Claude Code sobre a minha base de código?
- Skills ou hooks no Claude Code: qual é a diferença?
- Qual é a diferença entre rules e skills no Claude Code?
- O Claude Code tem suporte para rules?
- Vale a pena usar hooks no Claude Code?
- Porque é que o Claude ignora a saída do meu hook PreToolUse?
- O que é context engineering num agente de programação?
- O Claude Code consegue gerar o CLAUDE.md automaticamente?
- O Claude Code lê o AGENTS.md?
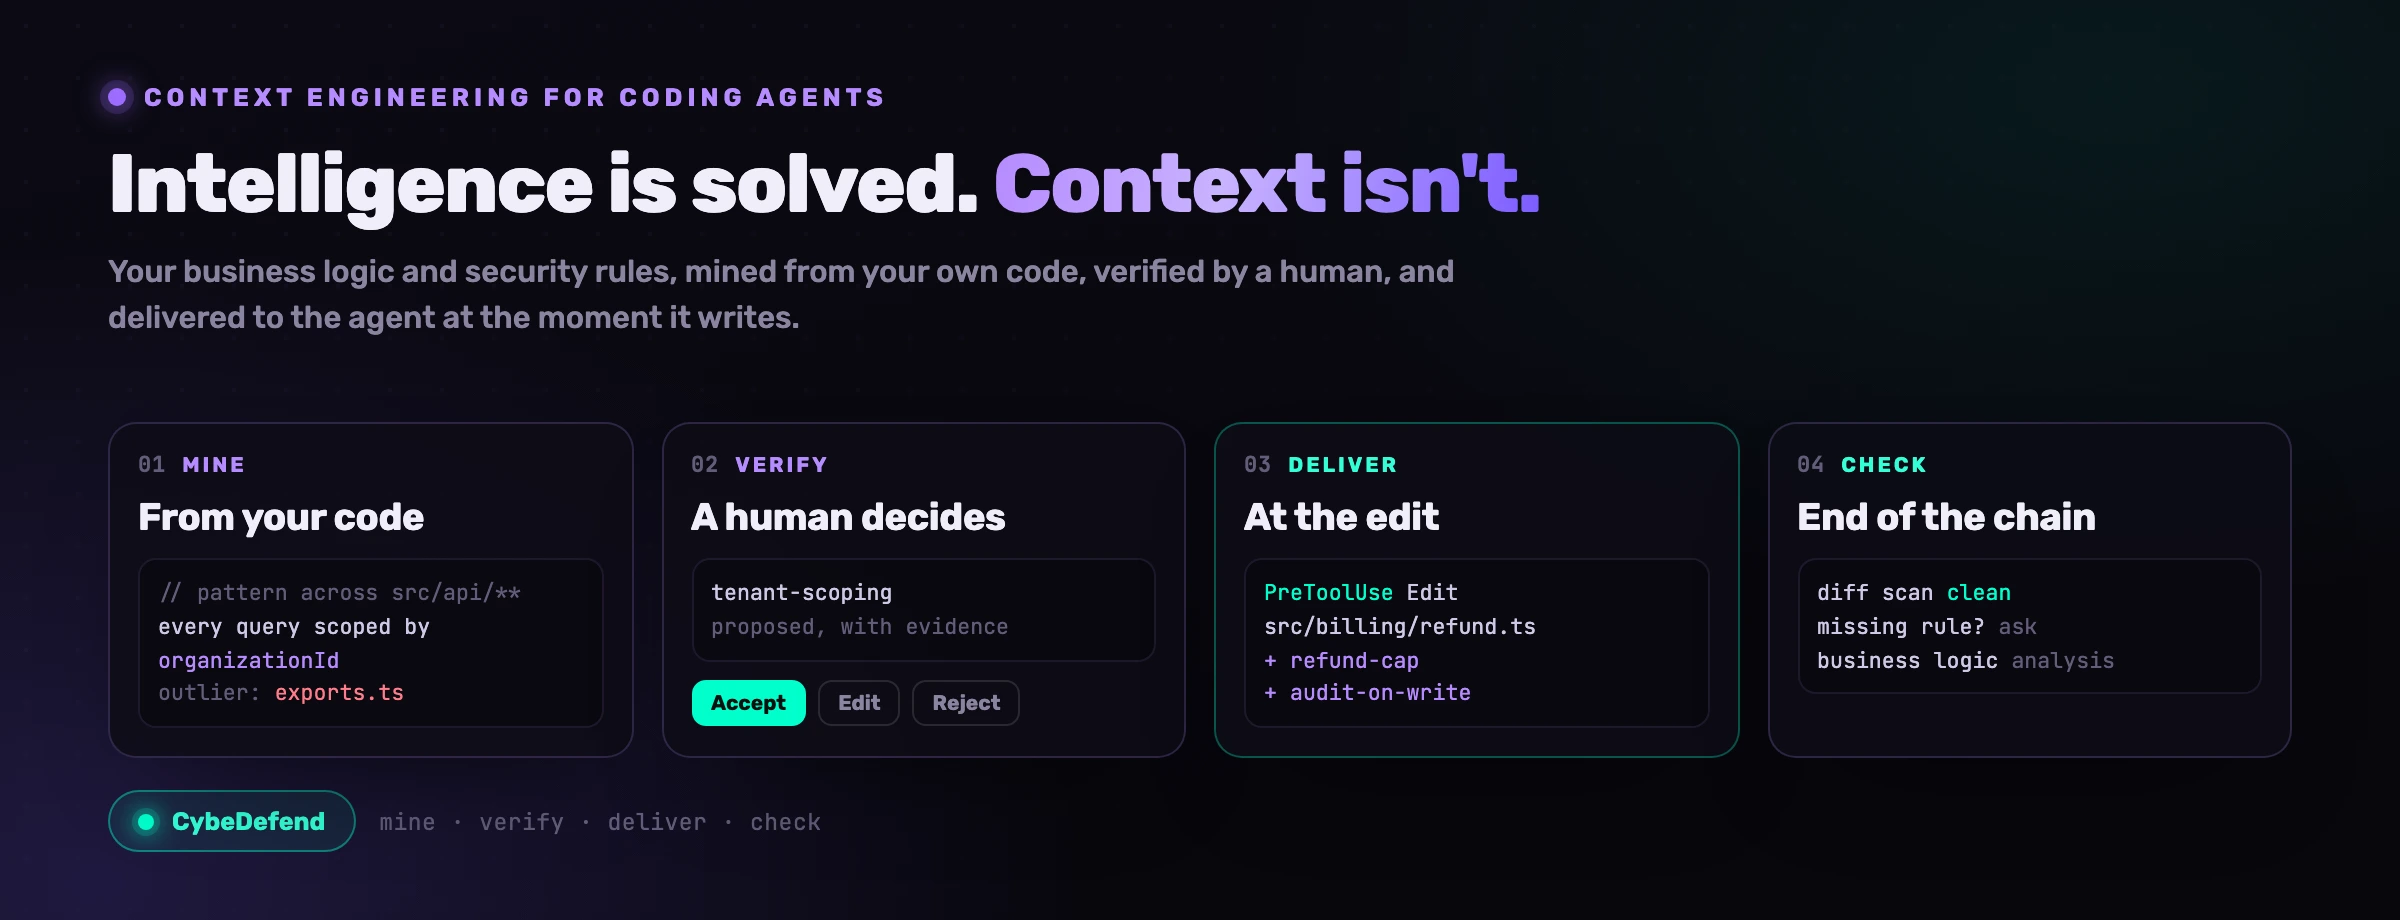
Escrever um endpoint de reembolso, o Claude Code já sabe. O que não tem como saber é que o teu responde 422 REFUND_EXCEEDS_CAPTURED, regista um evento de auditoria com o id de quem fez a operação e nunca atravessa a fronteira entre dois tenants. A isso chama-se contexto: a tua lógica de negócio, a tua nomenclatura, as tuas regras de segurança. O gargalo já não é a inteligência do modelo, é fazer-lhe chegar esse contexto no momento exato em que escreve. Este guia mostra onde deve viver cada tipo de contexto, dá-te um hook para copiar hoje mesmo e descreve o método em quatro passos que a CybeDefend aplica a uma base de código inteira: extrair as regras do teu código, pô-las à validação de uma pessoa, entregar a regra certa na edição e verificar o resultado.
O que quer dizer «contexto» para um agente de programação?
É tudo o que o modelo precisa de saber sobre o teu sistema e que não consegue deduzir do código que tem à frente. A Anthropic dá a esta disciplina o nome de context engineering. Birgitta Böckeler, que escreve sobre agentes de programação no site de Martin Fowler, cita a definição mais curta que por aí anda: «context engineering é fazer a curadoria daquilo que o modelo vê, para obteres um resultado melhor». Quando o agente trabalha num produto real, esse contexto arruma-se em três camadas.
Convenções
A maneira como o código se escreve aqui: os padrões do framework, a organização das pastas, o comando que corre os testes. O modelo apanha quase tudo isto no código à volta, e um CLAUDE.md curto trata do resto.
Lógica de negócio
Aquilo que o teu software tem de fazer e que nenhum modelo consegue deduzir sozinho: um reembolso nunca passa do valor capturado, acima de um certo limiar é precisa a aprovação de uma chefia, um estado de encomenda chama-se SHIPPED e não DISPATCHED. É também aqui que vive a tua nomenclatura.
Regras de segurança
As regras que têm um regulador ou um cliente por trás. Que campos são dados pessoais, o que pode aparecer num log, que query tem de ficar limitada ao tenant, que ação exige um evento de auditoria.
Todos os guias de CLAUDE.md falam da primeira camada. Só que é na segunda e na terceira que um erro do agente custa dinheiro, e é lá que nenhum scanner vai procurar: um reembolso que devolve de mais é código perfeitamente válido.
Essa classe de falhas tem artigo próprio, sobre as falhas de lógica de negócio no código gerado por IA. Aqui interessa-nos evitá-las na origem, garantindo que o agente conhece a regra no momento em que escreve.
Quais são os limites do CLAUDE.md, do AGENTS.md e dos skills?
Cada um foi pensado para um trabalho real, e cumpre-o. Nenhum foi pensado para levar as regras de negócio de uma empresa até ao momento da edição. Eis até onde vai cada um, dito por quem o faz.
CLAUDE.md: lido uma vez, seguido quando calha
A documentação da Anthropic não esconde nada. Os ficheiros CLAUDE.md são carregados «no início de cada conversa», e o Claude «trata-os como contexto, não como configuração imposta». A mesma página pede que apontes para «menos de 200 linhas por ficheiro CLAUDE.md», porque «ficheiros mais longos consomem mais contexto e reduzem o cumprimento». Ou seja, duzentas linhas para os comandos de build, as convenções e todas as regras de negócio que tens.
Mais: «se duas regras se contradisserem, o Claude pode escolher uma delas de forma arbitrária», e nada confronta o ficheiro com o código que ele descreve. No gestor de issues, são os utilizadores que contam o resultado. A issue #2901, aberta em julho de 2025 e com 31 comentários, diz: «o Claude Code viola com frequência instruções explícitas do projeto e do utilizador definidas nos ficheiros CLAUDE.md». A issue #33603, ainda aberta, tem por título «regras rígidas do CLAUDE.md e instruções de memória persistente ignoradas de forma sistemática».
AGENTS.md: o mesmo ficheiro, partilhado por mais agentes
O AGENTS.md é o formato aberto que o Codex, o Cursor, o Copilot e outros leem, usado por mais de 60 000 projetos open source. O próprio site resume bem a natureza da coisa: «o AGENTS.md é simplesmente Markdown normal», «um README para agentes». A norma decide onde vive o ficheiro, não se ele é cumprido.
E o único teste rigoroso feito até hoje não é lisonjeiro. Em fevereiro de 2026, Thibaud Gloaguen, Martin Vechev e mais três coautores publicaram Evaluating AGENTS.md, com esta conclusão: os ficheiros de contexto «não melhoram, em geral, as taxas de sucesso das tarefas, e aumentam o custo de inferência em mais de 20 % em média». As instruções que continham eram «bem seguidas», e os autores reservam estes ficheiros para «especificar práticas de programação fora do padrão», ao passo que as descrições gerais do repositório «não ajudam».
A isto somam-se três limites práticos:
- O Claude Code passa-lhe ao lado quando existe um CLAUDE.md. Com os dois ficheiros no repositório, o Claude Code lê, por omissão, «apenas os teus ficheiros CLAUDE.md». Uma equipa que mantenha os dois vê o seu AGENTS.md ignorado pelo Claude Code, enquanto os outros agentes o leem.
- O Codex põe-lhe um teto. Por omissão, o Codex deixa de acrescentar ficheiros de instruções quando o tamanho somado de todos chega aos 32 KiB.
- O Copilot pede-o curto. O prompt que o GitHub sugere para escrever as instruções diz que estas «não podem ter mais de 2 páginas» e «não podem ser específicas de uma tarefa». Ora, uma regra de negócio é, por natureza, específica de uma tarefa.
Skills: carregados quando o agente se lembra deles
Um skill é uma pasta de instruções e scripts que só é carregada quando é usada. A documentação da Anthropic sobre skills explica como é que o Claude escolhe: lê a descrição do skill para «decidir quando aplicar o skill». Uma regra embalada num skill só se aplica, portanto, se o agente reconhecer o momento certo.
A mesma documentação enumera as maneiras como esse reconhecimento falha. A descrição é «truncada aos 1536 caracteres». Com muitos skills instalados, o Claude Code «deixa cair algumas descrições para caber no orçamento de caracteres da listagem, o que remove as palavras-chave de que o Claude precisa para fazer corresponder o teu pedido». E, quando uma sessão longa é compactada, «os skills mais antigos podem desaparecer por completo».
Para procedimentos, os skills são excelentes. Como veículo de regras que têm de valer sempre, dependem precisamente daquilo de que estás a tentar não depender. Acresce que um skill escrito por outra pessoa executa código na tua sessão, o que é um risco à parte: lê os skills do Claude Code são seguros?
O que nenhum deles faz
Os três partem do princípio de que a parte difícil já está feita. Nenhum deles:
- encontra as tuas regras. Cada um guarda apenas o que alguém se lembrou de pôr por escrito.
- sabe que regra se aplica a esta edição. São carregados por sessão, por caminho ou por descrição, e nunca em função daquilo que o código que está a ser escrito faz realmente.
- dá por isso quando uma regra deixa de bater certo com o código. Um valor desatualizado fica no ficheiro até alguém, por acaso, o ler.
- verifica o resultado. Saber se a regra foi respeitada fica a cargo da revisão de código.
- funciona da mesma maneira em todos os teus agentes. Uma equipa com cinco agentes mantém cinco dialetos.
Porque é que o agente perde a regra antes de escrever?
Porque a atenção de um modelo não é uniforme, e uma regra lida no arranque já está longe da edição quando chega a hora de a aplicar. A equipa de engenharia da Anthropic di-lo sem rodeios: o contexto «tem de ser tratado como um recurso finito, com rendimentos marginais decrescentes». E dá ao efeito o nome de context rot: «à medida que o número de tokens na janela de contexto aumenta, a capacidade do modelo de recordar com precisão a informação desse contexto diminui».
Houve quem o medisse de forma independente. A Chroma testou 18 modelos no seu relatório Context Rot e concluiu que «o desempenho dos modelos se degrada à medida que o comprimento da entrada aumenta, muitas vezes de formas surpreendentes e pouco uniformes». Antes disso, o estudo Lost in the Middle tinha mostrado que o desempenho «se degrada significativamente quando os modelos têm de aceder a informação relevante no meio de contextos longos». E o IFScale, que empilha instruções umas em cima das outras, verificou que, com 500 instruções em simultâneo, «mesmo os melhores modelos de fronteira só atingem 68 % de precisão».
Na segurança, a história não muda. No benchmark SusVibes, 57 % das soluções produzidas pelo SWE-Agent com o Claude Sonnet 4 estavam funcionalmente corretas e só 11,8 % eram seguras, e «acrescentar ao pedido de funcionalidade pistas sobre vulnerabilidades» não resolveu o problema. Pedir a um agente que tenha cuidado não é o mesmo que lhe dar as tuas regras.
A nossa própria medição foi ao caso mais difícil, o das regras para as quais o agente já tem uma resposta plausível sua. Uma secção de regras realista no CLAUDE.md deu 7 valores concretos exatos em 55, precisamente o mesmo que não ter ficheiro nenhum. O protocolo completo está no artigo o Claude Code segue o CLAUDE.md?
Há duas forças por trás disto. A primeira é a diluição: à trigésima edição, o ficheiro é um fragmento antigo, soterrado por dezenas de milhares de tokens de código e de saídas de comandos. A segunda é o hábito. O código que o agente tem à frente mostra-lhe como se fazem as coisas nesta casa, e compila.
Num único prompt, isto vê-se assim. A 27 de setembro de 2026 pedimos ao Claude Code (com o modelo Haiku) uma função de reembolso num repositório vazio, primeiro sem regra nenhuma, depois com o hook apresentado mais abaixo a transportar a nossa regra de reembolsos. Foi uma execução de cada lado, o que faz disto uma ilustração e não uma medição.
As linhas que a regra mudou, na segunda execução:
if (amountCents > availableForRefund) {
  throw new RefundError("REFUND_EXCEEDS_CAPTURED");
}
order.refundedCents += amountCents;
await audit.log("refund.created", {
  orderId: order.id, amountCents, actorId,
});
Qualquer das duas versões é código razoável, mas só uma é o teu código. Esse desvio, o comportamento certo com os pormenores errados, é o que escapa a quem revê e o que faz rebentar um cliente da API.
CLAUDE.md, rules, skills, MCP ou hooks: o que vai para onde?
Cada mecanismo chega ao modelo num momento diferente, e é esse momento que decide para que serve.
| Mecanismo | Quando chega ao modelo | Serve para | Falha em |
|---|---|---|---|
| CLAUDE.md ou AGENTS.md | Uma vez, no arranque da sessão | Comandos de build, organização do projeto, convenções, práticas fora do padrão | Um valor concreto que faz falta trinta edições depois |
.claude/rules/ com paths | Quando o Claude lê um ficheiro que corresponde ao padrão | Regras ligadas a uma pasta ou a um tipo de ficheiro | Regras acionadas pelo que o código faz, e não pelo sítio onde está |
| Skills | Quando o Claude decide que um skill se aplica à tarefa | Procedimentos e playbooks que, de outro modo, terias de colar à mão | Regras que se têm de aplicar quer o agente se lembre delas quer não |
| Ferramentas MCP | Quando o agente decide chamá-las | Grandes volumes de documentos, pesquisa, dados em tempo real | Tudo o que dependa de o agente se lembrar de perguntar |
| Hooks | Num evento, sempre: arranque da sessão, prompt, antes ou depois de uma ferramenta | A regra certa no momento da edição; bloquear um comando | Nada, tirando o facto de seres tu a escrever a lógica de correspondência |
A coluna que interessa é a segunda. Um ficheiro, um skill ou uma ferramenta MCP dependem todos de algo que aconteceu antes, ou de o modelo decidir ir ver. Um hook, pelo contrário, é executado pelo próprio Claude Code, quer o modelo se lembre dele quer não.
As rules delimitadas por caminho ficam a meio caminho. Segundo a documentação da Anthropic, são acionadas «quando o Claude lê ficheiros que correspondem ao padrão, e não em cada utilização de ferramenta». É um progresso real face a um único ficheiro enorme, mas continua preso a um caminho e não à operação.
Quanto à segurança dos skills, que executam código vindo do repositório de outra pessoa, lê os skills do Claude Code são seguros?.
Como é que se entrega uma regra no momento da edição?
Com um hook PreToolUse nas ferramentas de escrita, que vai buscar as regras do ficheiro em causa e as devolve como additionalContext. Bastam três ficheiros. O primeiro regista o hook em .claude/settings.json:
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          { "type": "command", "command": "node \"$CLAUDE_PROJECT_DIR/.claude/hooks/rules-at-edit.mjs\"" }
        ]
      }
    ]
  }
}
Depois, cada regra passa a ser um pequeno ficheiro em .claude/edit-rules/, com os caminhos a que se aplica logo na primeira linha:
applies-to: src/billing/**, src/api/refunds/**
Refunds: never refund more than the captured amount.
Answer 422 with the code REFUND_EXCEEDS_CAPTURED, never a prose message.
Every refund writes an audit event: audit.log("refund.created", { orderId, amountCents, actorId }).
Falta o hook propriamente dito, .claude/hooks/rules-at-edit.mjs (Node 22.5 ou mais recente, por causa do path.matchesGlob):
import { readFileSync, readdirSync } from "node:fs";
import path from "node:path";

const root = process.env.CLAUDE_PROJECT_DIR ?? process.cwd();
const input = JSON.parse(readFileSync(0, "utf8"));
const file = path.relative(root, input.tool_input?.file_path ?? "");
const dir = path.join(root, ".claude/edit-rules");

const rules = readdirSync(dir)
  .map((name) => readFileSync(path.join(dir, name), "utf8"))
  .filter((text) => {
    const globs = text.match(/^applies-to:\s*(.+)$/m)?.[1] ?? "";
    return globs.split(",").some((g) => path.matchesGlob(file, g.trim()));
  });

if (rules.length > 0) {
  // JSON, not plain text: on PreToolUse, Claude Code only reads additionalContext.
  process.stdout.write(JSON.stringify({
    hookSpecificOutput: {
      hookEventName: "PreToolUse",
      additionalContext: `Rules for ${file}:\n\n${rules.join("\n---\n")}`,
    },
  }));
}
Foi esta a configuração que produziu a coluna da direita na comparação dos reembolsos, mais acima. O Claude Code coloca o contexto dos hooks «junto ao resultado da ferramenta», por isso o agente lê a regra ao mesmo tempo que o resultado da escrita nesse ficheiro, e corrige ali mesmo. Na nossa execução, escreveu a função, leu a regra e respondeu «Atualizei a função para», antes de enumerar o código de erro e o evento de auditoria.
Os outros agentes falam dialetos próprios. O Codex, da OpenAI, documenta o mesmo formato em PreToolUse: «para acrescentar contexto visível para o modelo sem bloquear, devolve hookSpecificOutput.additionalContext». No Cursor, o preToolUse pode permitir, recusar ou reescrever uma chamada, e o hook postToolUse acrescenta additional_context «depois do resultado da ferramenta». Já as instruções de repositório do GitHub Copilot delimitam um ficheiro com um padrão applyTo, e é o AGENTS.md mais próximo na árvore que tem precedência.
Onde é que a solução caseira deixa de chegar?
Nas próprias regras. O hook resolve a questão do momento, e vale a pena instalá-lo hoje. Só que deixa de pé o resto da lista acima: as regras continuam a sair da memória de alguém e a envelhecer, ninguém verifica se foram respeitadas, e cada agente da equipa precisa da sua própria versão. Pior, traz um limite só seu, porque um caminho não é uma intenção: nada impede que um reembolso seja escrito em utils.ts, e um glob não distingue um reembolso de um formatador. Passadas as dez regras e o agente único, manter isto à mão torna-se um trabalho em si mesmo.
Como é o método completo?
Começa onde qualquer ficheiro fica pelo caminho, quando ainda não há nenhuma regra escrita. É o método que a CybeDefend aplica com o VibeDefend, da base de código até ao diff, e foi pensado para uma equipa de desenvolvimento, não para o portátil de uma pessoa. As regras vivem num único sítio por projeto, o agente de cada programador recebe o mesmo conjunto validado, e cada passo existe por causa de um dos limites descritos acima.
Passo 1: extrair as regras do teu próprio código
As tuas regras já estão no teu código, escritas sob a forma de repetição. Depois de o repositório estar ligado e analisado, um extrator percorre o grafo de código à procura de cinco tipos de regularidade:
- Padrões de presença: um campo ou uma chamada que quase todas as instâncias têm. Todas as entidades têm um
organizationId, todas as escritas emorderschamam o logger de auditoria. - Conjuntos de valores: os nomes literais que o teu código usa para estados, papéis e códigos de erro. É a tua nomenclatura, e um agente que inventa um sexto estado de encomenda parte todos os consumidores dos outros cinco.
- Coocorrência: guardas e decoradores que andam sempre juntos, como uma verificação de autenticação e um rate limit.
- Chamadas obrigatórias antes de operações sensíveis: verificação de permissões, isolamento por tenant, rate limits, feature flags.
- Convenções identificadas por um modelo a partir de grupos de código semelhante, com os casos fora da norma listados à parte.
Cada proposta chega com as suas provas (onde o padrão foi encontrado, e quantas vezes) e com um grau de confiança. Os casos fora da norma são a parte mais útil. Numa base de código onde quarenta endpoints têm isolamento por tenant, aquele que não o tem é uma de duas coisas: uma exceção que alguém quis, ou uma falha em que ninguém reparou. É exatamente aí que a lógica de negócio e a segurança se cruzam.
Passo 2: pôr uma pessoa a validar cada regra
A extração propõe, nunca decide. Um padrão pode ser só um hábito, e uma regra é política: quem a escreve orienta todos os agentes da equipa. É por isso que os ficheiros de instruções são uma superfície de ataque por direito próprio.
No VibeDefend, cada proposta é aceite, editada ou rejeitada no dashboard, ou dentro do próprio agente quando uma sessão arranca. Uma regra sugerida pelo próprio agente é recusada enquanto não a confirmares. E uma verificação semanal de desvios propõe uma atualização sempre que o código se afasta de uma regra aceite: é assim que as regras continuam a corresponder à realidade sem que alguém tenha de manter um ficheiro.
Passo 3: entregar a regra certa na edição
É o hook da secção anterior, com uma pesquisa de regras no lugar dos globs. Antes de cada escrita, o caminho do ficheiro e o início do código que está a ser escrito seguem como intenção, e voltam, como contexto para esse ficheiro, até cinco regras de negócio e cinco regras de segurança relevantes para aquela alteração. O instalador liga isto ao Claude Code, ao Cursor, ao Codex, ao Windsurf e ao GitHub Copilot no VS Code, cada um com os limites do seu próprio sistema de hooks.
Entregar uma regra informa o agente, não o obriga a nada. Para o que nunca pode acontecer, há uma guarda à parte que verifica cada comando antes de ele correr e que o pode bloquear. A regra no contexto é uma sugestão forte; o controlo é a guarda sobre a ação. Preferimos dizer qual é qual.
Passo 4: verificar o resultado no fim da cadeia
São três verificações, da sessão até à arquitetura:
- No fim de uma sessão, uma revisão faz uma pergunta só: este trabalho revelou uma regra duradoura que não está escrita em lado nenhum? Propõe no máximo uma, muitas vezes nenhuma, e nada fica registado sem o teu sim.
- Antes do commit, o diff é analisado à procura de vulnerabilidades, de erros de configuração da infraestrutura e de segredos, para que o agente os corrija na mesma sessão.
- Na própria lógica de negócio, o BLSA, a nossa Business Logic Security Analysis, lê a arquitetura inteira, segmento a segmento, para encontrar aquilo que nenhum padrão apanha: um reembolso que pode ser repetido, um tenant que consegue ler os dados de outro, dados pessoais que saem por uma exportação, uma operação que não é idempotente. O BLSA é uma linha de investigação conduzida com o CNRS e o laboratório CRIStAL, já a funcionar com design partners mas ainda sem disponibilidade geral. Vê o que procura no setor fintech.
Lado a lado, a diferença tem menos a ver com o agente do que com a equipa à volta dele.
O que muda quando a regra chega no momento da edição?
Deixa-se de perder a maior parte das regras. O nosso estudo controlado passou 30 tickets de programação por três agentes autónomos, numa única base de código e com um único modelo. Nas 19 tarefas da primeira fase, o agente sem regras e o agente com um ficheiro de regras realista implementaram, cada um, 7 de 55 valores concretos de forma exata. O agente que recebeu as regras na edição chegou aos 46 de 53.
exatos sem regra nenhuma (7 de 55)
exatos com uma secção de regras realista no CLAUDE.md (7 de 55)
exatos com a regra entregue na edição (46 de 53)
Convém dizer o que isto mede e o que não mede. Mede a entrega na edição. As 49 regras foram escritas por nós, não extraídas, por isso o estudo ainda não diz nada sobre a qualidade da extração. Trata-se de uma única base de código, com uma execução por braço e por tarefa, avaliada por auditores cegos que são modelos.
E o estudo traz o seu próprio contraexemplo: numa das tarefas, uma regra foi entregue treze vezes e o agente violou-a na mesma, que é a razão de ser da guarda. O protocolo e todos os números estão no estudo.
Por onde começar esta semana?
Por dez regras, não por uma plataforma.
- Faz a lista de dez regras que a tua equipa repete nas revisões de código, aqueles comentários que já escreveste mais de duas vezes.
- Separa-as com uma única pergunta: um engenheiro competente, acabado de chegar à equipa, conseguiria adivinhá-la? Se sim, vai para o CLAUDE.md. Se não, tem de chegar ao agente no momento da edição.
- Delimita o que está preso a uma pasta com
.claude/rules/e um campopaths. - Acrescenta o hook acima para as regras arbitrárias, e confirma que devolve JSON.
- Transforma tudo o que nunca pode acontecer numa regra de bloqueio ou numa guarda, e não numa frase.
- Testa-o onde costuma falhar: uma funcionalidade que toque numa regra, trinta turnos depois de a sessão começar.
Quando a lista deixar de te caber na cabeça, chegou a altura de a extrair em vez de a escrever.
Perguntas frequentes
Como dar contexto ao Claude Code sobre a minha base de código?
Em três camadas. Os comandos de build, a organização do projeto e as convenções vão para um CLAUDE.md curto, que o Claude lê no arranque de cada sessão. As regras próprias de uma pasta ficam em .claude/rules/, com um campo paths, para serem carregadas quando o Claude lê um ficheiro correspondente. E as regras de negócio e de segurança que o modelo não consegue adivinhar (códigos de erro, limiares, formatos de auditoria) chegam-lhe no momento da edição, através de um hook PreToolUse que devolve additionalContext em JSON.
Skills ou hooks no Claude Code: qual é a diferença?
Um skill é algo que o Claude escolhe carregar; um hook é algo que o Claude Code executa, escolha o Claude o que escolher. A descrição de um skill fica no contexto e o corpo só é carregado quando o Claude, ou tu, o invocam, o que o torna indicado para procedimentos. Um hook dispara num evento, seja o arranque de uma sessão, um prompt ou uma chamada a uma ferramenta, e por isso é o sítio certo para uma regra que tem de chegar ao agente todas as vezes, ou para bloquear um comando.
Qual é a diferença entre rules e skills no Claude Code?
As rules são instruções, os skills são procedimentos. Os ficheiros em .claude/rules/ entram no contexto sem condições, ou então quando o Claude lê um ficheiro que corresponde ao seu padrão paths. Um skill empacota um procedimento de vários passos, com scripts opcionais, e só é carregado quando é usado. Usa as rules para aquilo que tem de ser sempre verdade no código, e os skills para a maneira de levar a cabo uma tarefa.
O Claude Code tem suporte para rules?
Tem. Os ficheiros Markdown em .claude/rules/ são carregados como instruções, de forma recursiva, com um tema por ficheiro. Uma rule que tenha um campo paths no frontmatter só é carregada quando o Claude lê um ficheiro que corresponde a um dos seus padrões glob; sem esse campo, entra em todas as sessões. As rules pessoais, guardadas em ~/.claude/rules/, aplicam-se a todos os projetos da tua máquina.
Vale a pena usar hooks no Claude Code?
Para tudo o que tem de acontecer sempre, são o único mecanismo fiável. A própria documentação da Anthropic diz que, para bloquear uma ação «independentemente do que o Claude decidir», deves recorrer a um hook PreToolUse e não a uma instrução. Os hooks também conseguem acrescentar contexto num momento preciso, por exemplo as regras do ficheiro que está a ser escrito, coisa que um ficheiro lido no arranque da sessão não consegue fazer.
Porque é que o Claude ignora a saída do meu hook PreToolUse?
Porque o texto simples que um hook PreToolUse imprime vai parar ao log de debug, não ao modelo. O Claude Code só junta ao contexto o stdout em texto simples em UserPromptSubmit, UserPromptExpansion, SessionStart e PostModelSwitch. A solução é devolver JSON, com hookSpecificOutput.hookEventName definido como PreToolUse e o teu texto em additionalContext. Verificámos a diferença no Claude Code 2.1.282, a 27 de setembro de 2026.
O que é context engineering num agente de programação?
É decidir que informação chega à janela de contexto do modelo, e quando, para que ele faça bem a tarefa. Num agente de programação, isto tem menos a ver com escrever um prompt mais comprido e mais a ver com o momento certo: os factos estáveis no arranque da sessão, as regras relevantes no momento da edição, e mais nada a disputar a atenção do modelo. A equipa de engenharia da Anthropic usa o termo para designar a disciplina no seu todo.
O Claude Code consegue gerar o CLAUDE.md automaticamente?
Consegue. O /init analisa a tua base de código e escreve um CLAUDE.md inicial, com os comandos de build, as instruções de teste e as convenções que encontra. Para a primeira camada de contexto, é um bom ponto de partida. Não é o mesmo que extrair regras de negócio: o estudo Evaluating AGENTS.md concluiu que os ficheiros de contexto gerados por modelos não melhoravam, em geral, o sucesso das tarefas. E um ficheiro gerado continua a chegar uma única vez, no arranque da sessão, e continua a precisar de alguém que o valide.
O Claude Code lê o AGENTS.md?
Lê, desde que não haja CLAUDE.md. Segundo a documentação da Anthropic, o Claude Code lê o AGENTS.md como instruções do projeto se não existir nenhum CLAUDE.md nem CLAUDE.local.md no diretório de trabalho ou acima dele. Quando os dois ficheiros estão presentes, lê por omissão apenas os ficheiros CLAUDE.md, a não ser que o teu CLAUDE.md importe o AGENTS.md ou que alteres essa definição. Em qualquer dos casos o mecanismo é o mesmo, um ficheiro carregado no arranque da sessão, e com os mesmos limites para as regras de que se precisa trinta edições depois.


