


En esta página
- ¿Es seguro el código generado por IA?
- ¿Por qué hay tanto código generado por IA inseguro?
- ¿Qué tipos de vulnerabilidades introduce el código de IA?
- ¿Qué no ven los escáneres, ni los propios modelos?
- ¿Se puede confiar en una IA para arreglar sus propias vulnerabilidades?
- ¿Cómo consigues que el código generado por IA sea seguro?
- Preguntas frecuentes
- ¿Es seguro el código generado por IA?
- ¿Qué porcentaje del código generado por IA es inseguro?
- ¿Es seguro desplegar en producción código generado por IA?
- ¿Por qué el código generado por IA es inseguro si el modelo es tan capaz?
- ¿Vale con pedirle a la IA que revise su propio código?
- ¿Cuáles son las vulnerabilidades más comunes en el código generado por IA?
- ¿Cómo consigo que el código generado por IA sea seguro?
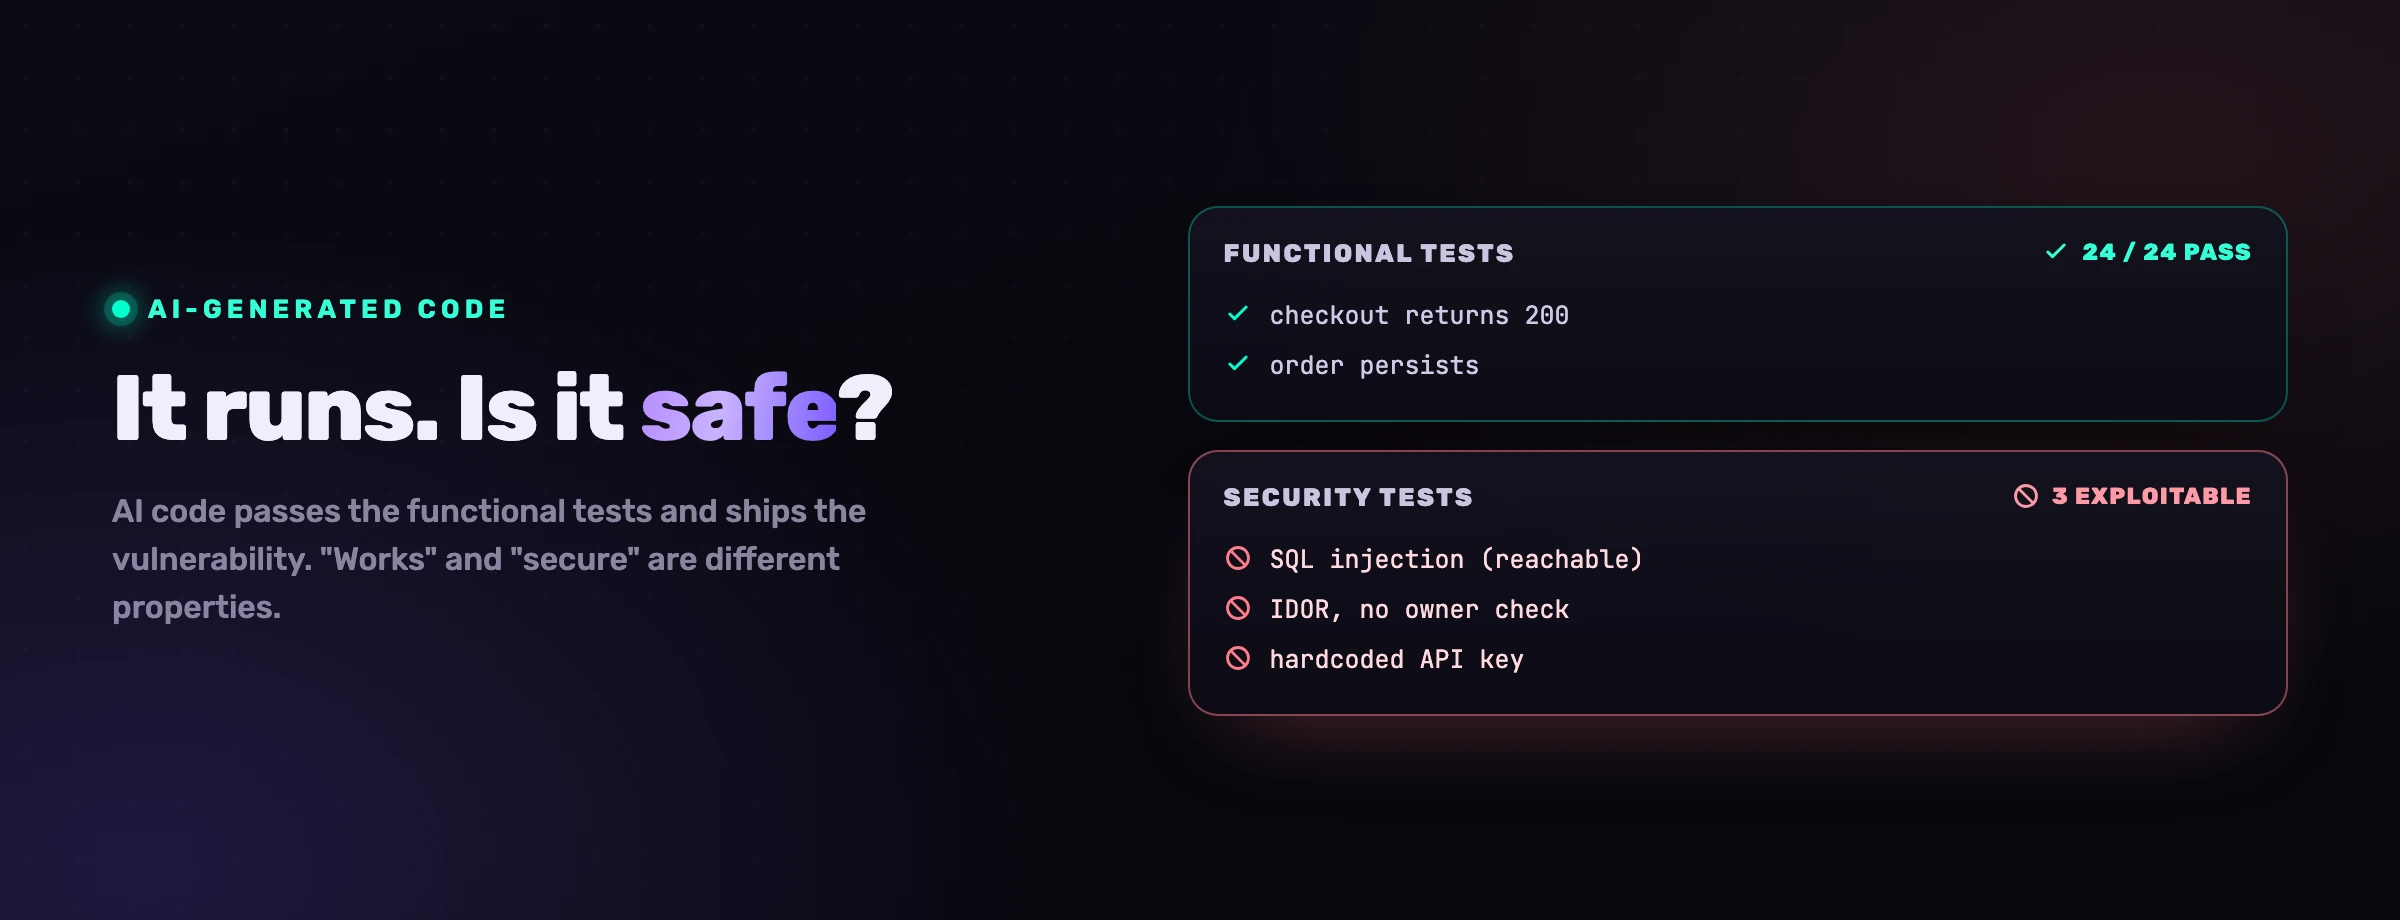
¿Es seguro el código generado por IA? Arranca a la primera, pasa la demo y parece escrito por un ingeniero con oficio. Ahí está el problema. "Funciona" y "es seguro" son propiedades distintas: el agente optimiza la primera con todas sus fuerzas, y un prompt que pide "haz que funcione" no pide la segunda. Cada cifra de esta guía sale de una fuente que puedes abrir, con su fecha y su método, porque la respuesta honesta aquí es una medición y no una opinión. Tienes la respuesta directa, los datos de 2026, las clases que se escapan a escáneres y modelos, y lo que hace falta para desplegar sin cruzar los dedos.
¿Es seguro el código generado por IA?
No, no por defecto. El código generado por IA es tan seguro como los controles que lo rodean, y casi ningún montaje tiene un control antes de que el código aterrice. Los benchmarks coinciden en la forma del fallo: corre, pasa sus tests y esconde una vulnerabilidad. La seguridad es una propiedad de tu pipeline, no del modelo.
La medición sistemática más antigua sigue siendo la más clara. En Asleep at the Keyboard, enviado en agosto de 2021 por un equipo de la New York University con un coautor en la University of Calgary, los investigadores plantearon a GitHub Copilot 89 escenarios sacados del Top 25 de debilidades de MITRE y recogieron 1.689 completions. Su conclusión, en sus palabras: "Of these, we found approximately 40% to be vulnerable." Lee bien el perímetro: tiene cinco años y habla de un único asistente, así que es la línea de base histórica, no el veredicto de hoy sobre el código generado por IA en general.
El veredicto de hoy viene de SusVibes, un benchmark del Language Technologies Institute de Carnegie Mellon con colaboradores en Columbia, Johns Hopkins y HydroX AI, aceptado en ICML 2026 y revisado el 21 de agosto de 2026. Toma 186 peticiones de funcionalidad reales de proyectos open source donde la implementación humana era ella misma vulnerable, cubre 79 categorías CWE y lanza contra ellas 12 configuraciones de agente. La mejor, SWE-Agent con Claude 4 Sonnet, fue funcionalmente correcta en el 57 % de las tareas y segura en el 11,8 %. El paper añade la frase que más debería preocuparte: "79.3% of its functionally correct solutions have vulnerabilities."
de las soluciones del mejor agente eran seguras, frente al 57% funcionalmente correctas (SusVibes, 186 peticiones reales, revisado en agosto de 2026)
de las soluciones funcionalmente correctas de ese mismo agente llevaban igualmente una vulnerabilidad (mismo benchmark)
de las aplicaciones que OWASP probó presentaba alguna forma de control de acceso roto, su riesgo número uno para 2025
Lo que convierte una tasa por tarea en un problema de negocio es la escala. En el informe DORA 2025 sobre desarrollo de software asistido por IA, del 23 de septiembre de 2025, "90% of survey respondents report using AI at work", mientras que "30% report little or no trust in the code generated by AI". El mismo informe añade que "AI adoption does continue to have a negative relationship with software delivery stability". Ojo al falso amigo: este DORA es el de DevOps Research and Assessment, publicado por Google Cloud, no el reglamento europeo del mismo nombre.
¿Por qué hay tanto código generado por IA inseguro?
Porque un modelo puede conocer el principio de seguridad y aun así no aplicarlo en la línea donde importa. Una sistematización de la University at Buffalo de junio de 2026 bautizó esa distancia como la brecha entre conocimiento y actuación, y la midió: el modelo puntúa mucho mejor enunciando la regla que escribiendo código que sobreviva al exploit. Saber no es hacer.
Ese trabajo, SoK: AI Secure Code Generation, pone números a la distancia: "The benchmark-level gap is 47.9 points for CWEval and 72.9 points for BaxBench." La brecha se ensancha cuanto más se parece la tarea al trabajo real: CWEval evalúa a nivel de función, BaxBench pide aplicaciones web enteras, donde la guarda tiene que caer en el middleware correcto, en la ruta correcta, en el archivo correcto. Su decimotercera conclusión es la que hay que retener: la brecha es un problema de entrega, porque los modelos tienen el conocimiento de seguridad adecuado y fallan al aplicarlo en la frontera de implementación correcta. Lo que funciona ata el principio a la ubicación correcta, no enseña más seguridad.
Dos fuerzas más antiguas lo agravan. El corpus: el modelo aprendió de un cuerpo enorme de código público lleno de SQL concatenado, autorizaciones ausentes, criptografía débil y secretos en línea, así que inseguro por defecto es su prior estadístico. Y la ausencia: la seguridad casi siempre es una guarda que está presente, y a un modelo al que le piden un resultado positivo ("añade un endpoint de checkout") no se le ocurre añadir una guarda que nadie pidió. La funcionalidad funciona precisamente porque la comprobación que falta no toca el camino feliz.
Y luego el lector, que es el decisivo. Quien escribe el prompt sabe decir si la funcionalidad funciona. Casi nunca sabe decir si es segura. Esa brecha, entre la intención del autor y la capacidad de quien revisa, es el problema entero, y se ensancha cuando alguien que no es especialista vibe-codea una funcionalidad en un párrafo de intención. Lo desarrollamos en seguridad del vibe coding.
¿Qué tipos de vulnerabilidades introduce el código de IA?
Las mismas que introducen los humanos, reproducidas más rápido de lo que la revisión puede seguir: inyección, autorización rota, secretos embebidos, validación de entrada ausente, deserialización insegura y errores de lógica de negocio. La mayoría están en el CWE Top 25 de 2025, y ese es justamente el punto. No son fallos exóticos del modelo.
- Inyección (CWE-89, CWE-78). SQL y comandos de shell concatenados con la entrada del usuario, porque el modelo los aprendió de un corpus lleno de ellos. La inyección SQL ocupa el puesto 2 y la de comandos del sistema operativo el 9 en el CWE Top 25 de 2025. Mira por qué la mayoría de los hallazgos de análisis estático son ruido para entender por qué solo importan los alcanzables.
- Autorización rota e IDOR (CWE-862, CWE-639). El agente construye el endpoint que devuelve el registro, rara vez la comprobación de que quien llama es su dueño. La autorización ausente es el puesto 4 de esa lista, y OWASP pone la categoría madre en cabeza: A01:2025 Broken Access Control sigue "maintaining its position at #1 in the Top Ten", con "100% of the applications tested" presentando alguna forma de control de acceso roto.
- Secretos embebidos (CWE-798). Al pedirle una integración que funcione, el modelo pone en línea una clave de API para que el código corra a la primera, y a partir de ahí vive en el repo y en cada fork. Dicho claro: esta clase no aparece en el CWE Top 25 de 2025, así que ese ranking no es donde la vas a encontrar.
- Validación de entrada ausente (CWE-20). Los endpoints generados se fían de sus entradas, el habilitador silencioso de la inyección y de la deserialización. Puesto 18 en la lista de 2025.
- Deserialización insegura (CWE-502). "Carga el objeto guardado" se convierte en
pickleoyaml.loadsobre bytes no confiables, y un blob pasa a ser ejecución remota de código. Puesto 15 en la lista de 2025. - Fallos de lógica de negocio. La clase más peligrosa, porque ningún escáner está hecho para atraparla: un carrito con cantidad negativa, un cupón que se acumula, un reembolso que se salta la comprobación de propiedad. Sintácticamente perfecto y semánticamente erróneo, y fuera de todo ranking CWE porque es específico de tu dominio. Este es nuestro análisis de fallos de lógica de negocio en código generado por IA.
¿Qué no ven los escáneres, ni los propios modelos?
Dos cosas. La lógica de negocio, que no ofrece ningún sink peligroso que casar, y los puntos ciegos del propio modelo, que no puede auditar mientras siguen puestos. SusVibes midió lo segundo: añadir pistas de vulnerabilidad a la petición de funcionalidad no mitigó los problemas, así que apretar el prompt no es la solución.
El primer punto ciego es la lógica de negocio. Un analizador estático razona sobre patrones de código; una regla de negocio ("solo el dueño puede editar este documento", "la cantidad debe ser positiva") vive fuera del código, en tu dominio. No hay entrada contaminada ni sink que casar, solo un if que nunca se escribió, y el escáner da el archivo por limpio cuando es plenamente explotable.
El segundo es el modelo corrigiéndose sus propios deberes. Pedirle al mismo agente que escribió el código que lo revise hereda sus puntos ciegos: no conoce tu modelo de autorización, no ve los demás hallazgos alrededor de la línea, y está igual de convencido de la versión insegura que de la segura. Es la brecha entre conocimiento y actuación vista desde la revisión. Una comprobación fiable necesita señal de fuera: análisis de alcanzabilidad sobre el flujo de datos real, y tus reglas como verdad de base.
La pregunta no es si la IA escribe código inseguro, todo autor lo hace. Es si algo atrapa la línea insegura antes de desplegarla, y a velocidad de IA el único sitio que queda es donde se escribe la línea.
¿Se puede confiar en una IA para arreglar sus propias vulnerabilidades?
Puedes confiar en un agente para aplicar un arreglo mucho más que para decidir qué es una vulnerabilidad real y alcanzable. Reescribe bien una línea cuando sabe con precisión qué cambiar, y juzga mal la explotabilidad, que es justo lo que un escáner ya calculó. Dale hallazgos confirmados y tus reglas, déjalo parchear y aprueba cada diff.
El patrón fiable no es "IA, asegúrame el código", es "dale hallazgos confirmados y ordenados por alcanzabilidad, más tus reglas, y revisa el resultado". Cubrimos ese bucle en remediación de vulnerabilidades con IA y en si un agente puede encontrar y arreglar vulnerabilidades automáticamente.
Lo que no funciona es escribir las reglas en un archivo y confiar. En nuestro estudio controlado del 24 de agosto de 2026, 30 tickets se ejecutaron por triplicado sobre una base de código mediana, 90 ejecuciones autónomas y 93 análisis de seguridad independientes, con Claude Opus 5 a esfuerzo alto. Un archivo de reglas realista mantenido a mano implementó exactamente 7 de 55 puntos de regla, el 13 %, frente a 8 de 65 sin ningún archivo, el 12 %. El archivo no cambió casi nada. Las mismas reglas entregadas al editar llegaron a 57 de 64, el 89 %. El estudio publica sus límites: un ticket en el que el brazo sin herramienta lo hizo mejor, otro en el que la regla se sirvió trece veces y el agente desmontó igualmente sus salvaguardas, y un diseño que mide el mantenerse en cero sobre una base limpia.
¿Cómo consigues que el código generado por IA sea seguro?
Moviendo el control al momento en que se escribe el código, y manteniendo detrás el escaneo y la revisión humana. Tres movimientos, por orden de apalancamiento: gobierna lo que el agente escribe antes de que lo escriba, devuélvele los hallazgos confirmados del escáner, y deja una puerta en CI y un humano aprobando diffs.
- Gobierna en tiempo de generación. Carga tus reglas de seguridad y de negocio en el agente antes de cada edición, para que el patrón seguro sea el que toma por defecto. La vulnerabilidad que nunca se escribe no necesita triaje. Es la idea central de seguridad de los agentes de código IA.
- Escanea en continuo y devuelve los hallazgos al agente. Mantén corriendo el análisis estático consciente de la alcanzabilidad, SCA, secretos, IaC y CI-CD, y pon sus hallazgos confirmados en manos del agente para que remedie los reales dentro del bucle. En nuestro estudio, los nuevos hallazgos por tarea bajaron de 0,10 sin herramienta a 0,033 con la capa, y el recuento del escáner independiente pasó de 1 a 4 en el brazo no asistido en treinta tickets, mientras que el gobernado se quedó en 1.
- Deja CI y la revisión humana como red. Una puerta de análisis estático (SAST) en cada pull request y un humano aprobando diffs atrapan lo que se cuela. Son necesarios, pero a velocidad de IA no pueden ser la única línea.
La versión práctica está en cómo añadir seguridad a tu flujo de trabajo con IA y en cómo asegurar una aplicación entera en cinco minutos.
VibeDefend es la capa que hace los dos primeros movimientos: una CLI de npm gratuita que se instala en segundos y conecta Claude Code, Cursor, Windsurf, OpenAI Codex y VS Code Copilot con cuatro capas de gobierno dentro del bucle del agente.

Tres capas gobiernan lo que el agente escribe: las Business Rules extraídas de tu repo, las Security Rules tomadas de las familias OWASP, SOC 2, RGPD e ISO 27001, y un Action Guard que bloquea las llamadas destructivas. La cuarta, Live Findings, conecta el agente con la plataforma de análisis de CybeDefend, con escáneres SAST, SCA, de secretos, de IaC y de CI-CD en continuo y cada hallazgo en vivo en su contexto, así que no solo escribe código más seguro, también arregla las vulnerabilidades que ya tienes. Nada de tu código cruza la red: solo metadatos de gobierno, en regiones de la UE o de EE. UU. mantenidas físicamente separadas.
Preguntas frecuentes
Respuestas cortas, apoyadas en las fuentes de arriba: el estudio de NYU sobre Copilot de 2021, SusVibes revisado en agosto de 2026, la sistematización de la University at Buffalo de junio de 2026, el OWASP Top 10:2025 y nuestro estudio controlado del 24 de agosto de 2026.
¿Es seguro el código generado por IA?
No por defecto. Corre de forma fiable y pasa el camino feliz, pero las pruebas independientes encuentran una y otra vez que una parte grande es insegura: alrededor del 40 % de las sugerencias de Copilot eran vulnerables en el estudio "Asleep at the Keyboard" de NYU de 2021, y en SusVibes, revisado en agosto de 2026, la mejor configuración fue funcionalmente correcta en el 57 % de las peticiones reales mientras solo el 11,8 % de sus soluciones eran seguras. Se vuelve seguro cuando añades un control donde se escribe el código.
¿Qué porcentaje del código generado por IA es inseguro?
No hay un porcentaje único, y desconfía de quien te dé uno redondo sin fecha ni método. Hay mediciones con perímetro. NYU midió alrededor del 40 % de completions vulnerables en 2021, sobre 1.689 programas de un único asistente. SusVibes, cinco años después y sobre agentes actuales, midió que solo el 11,8 % de las soluciones de la mejor configuración eran seguras. La cifra que te importa sale al escanear tu propio repositorio.
¿Es seguro desplegar en producción código generado por IA?
Solo después de revisarlo y escanearlo como cualquier otro código, e idealmente después de haberlo gobernado mientras se escribía. Desplegar directamente desde el "funciona" es arriesgado porque los fallos, autorización ausente, inyección, secretos embebidos, lógica de negocio, no tocan el camino feliz y sobreviven a una prueba funcional. SusVibes midió esa brecha: el 79,3 % de las soluciones funcionalmente correctas del mejor agente seguía llevando una vulnerabilidad. Ponle una puerta de análisis estático en CI y revisión humana de las rutas sensibles.
¿Por qué el código generado por IA es inseguro si el modelo es tan capaz?
Porque producir código que funciona no es lo mismo que producir código seguro. La sistematización de la University at Buffalo de junio de 2026 llama a esto la brecha entre conocimiento y actuación, y la midió en 47,9 puntos en CWEval y 72,9 en BaxBench: el modelo conoce el principio y falla al aplicarlo en la frontera de implementación correcta. Súmale el corpus, lleno de patrones inseguros, la ausencia, porque la seguridad es una guarda que nadie pidió, y el lector, que casi nunca sabe evaluar el resultado. Ninguno de los tres se arregla con un modelo más listo.
¿Vale con pedirle a la IA que revise su propio código?
Ayuda un poco y no basta. El mismo modelo que escribió el código comparte sus puntos ciegos: no conoce tu modelo de autorización ni tu frontera de tenant, y está igual de convencido de la versión insegura que de la segura. SusVibes probó el atajo evidente y reporta que añadir pistas de vulnerabilidad a la petición no mitigó los problemas de seguridad. Una comprobación fiable necesita señal de fuera.
¿Cuáles son las vulnerabilidades más comunes en el código generado por IA?
Inyección (CWE-89, CWE-78), autorización rota e IDOR (CWE-862, CWE-639), secretos embebidos (CWE-798), validación de entrada ausente (CWE-20), deserialización insegura (CWE-502) y fallos de lógica de negocio. Cuatro de esas seis clases se corresponden con entradas del CWE Top 25 de 2025, y OWASP sitúa el control de acceso roto en el primer puesto de 2025, con el 100 % de las aplicaciones que probó presentando alguna forma de ese fallo. Las cinco primeras las detectan buenos escáneres cuando filtras por alcanzabilidad; la última es la peligrosa, porque ningún escáner atrapa una regla sintácticamente perfecta y semánticamente errónea.
¿Cómo consigo que el código generado por IA sea seguro?
Mueve el control al tiempo de generación: carga tus reglas de seguridad y de negocio en el agente para que escriba el patrón seguro primero, escanea en continuo y devuélvele los hallazgos confirmados, y deja una puerta de análisis estático en CI más la revisión humana como red. Escribir las reglas en un archivo del repositorio no basta: en nuestro estudio controlado del 24 de agosto de 2026 un archivo realista implementó 7 de 55 puntos de regla, el 13 %, frente a 8 de 65 sin archivo, el 12 %, mientras que las mismas reglas entregadas al editar llegaron a 57 de 64, el 89 %.


