


En esta página
- ¿Qué significa «contexto» para un agente de código?
- ¿Qué límites tienen CLAUDE.md, AGENTS.md y las skills?
- CLAUDE.md: se lee una vez y se sigue cuando encaja
- AGENTS.md: el mismo archivo, compartido por más agentes
- Skills: se cargan cuando el agente se acuerda de ellas
- Lo que no hace ninguno
- ¿Por qué el agente pierde la regla antes de escribir?
- CLAUDE.md, reglas, skills, MCP o hooks: ¿qué lleva cada uno?
- ¿Cómo se entrega una regla en el momento de la edición?
- ¿Dónde se queda corta la versión casera?
- ¿Cómo es el método completo?
- Paso 1: extrae las reglas de tu propio código
- Paso 2: que una persona verifique cada regla
- Paso 3: entrega la regla adecuada en la edición
- Paso 4: comprueba el resultado al final de la cadena
- ¿Qué cambia cuando la regla llega en el momento de la edición?
- ¿Por dónde empezar esta semana?
- Preguntas frecuentes
- ¿Cómo dar contexto a Claude Code sobre mi código?
- ¿Qué diferencia hay entre skills y hooks en Claude Code?
- ¿En qué se diferencian las rules y las skills de Claude Code?
- ¿Se pueden definir reglas en Claude Code?
- ¿Sirven de algo los hooks de Claude Code?
- Mi hook PreToolUse se ejecuta, pero Claude ignora su salida: ¿por qué?
- ¿Qué es la ingeniería de contexto en los agentes de código?
- ¿Claude Code puede generar el CLAUDE.md automáticamente?
- ¿Claude Code lee el AGENTS.md?
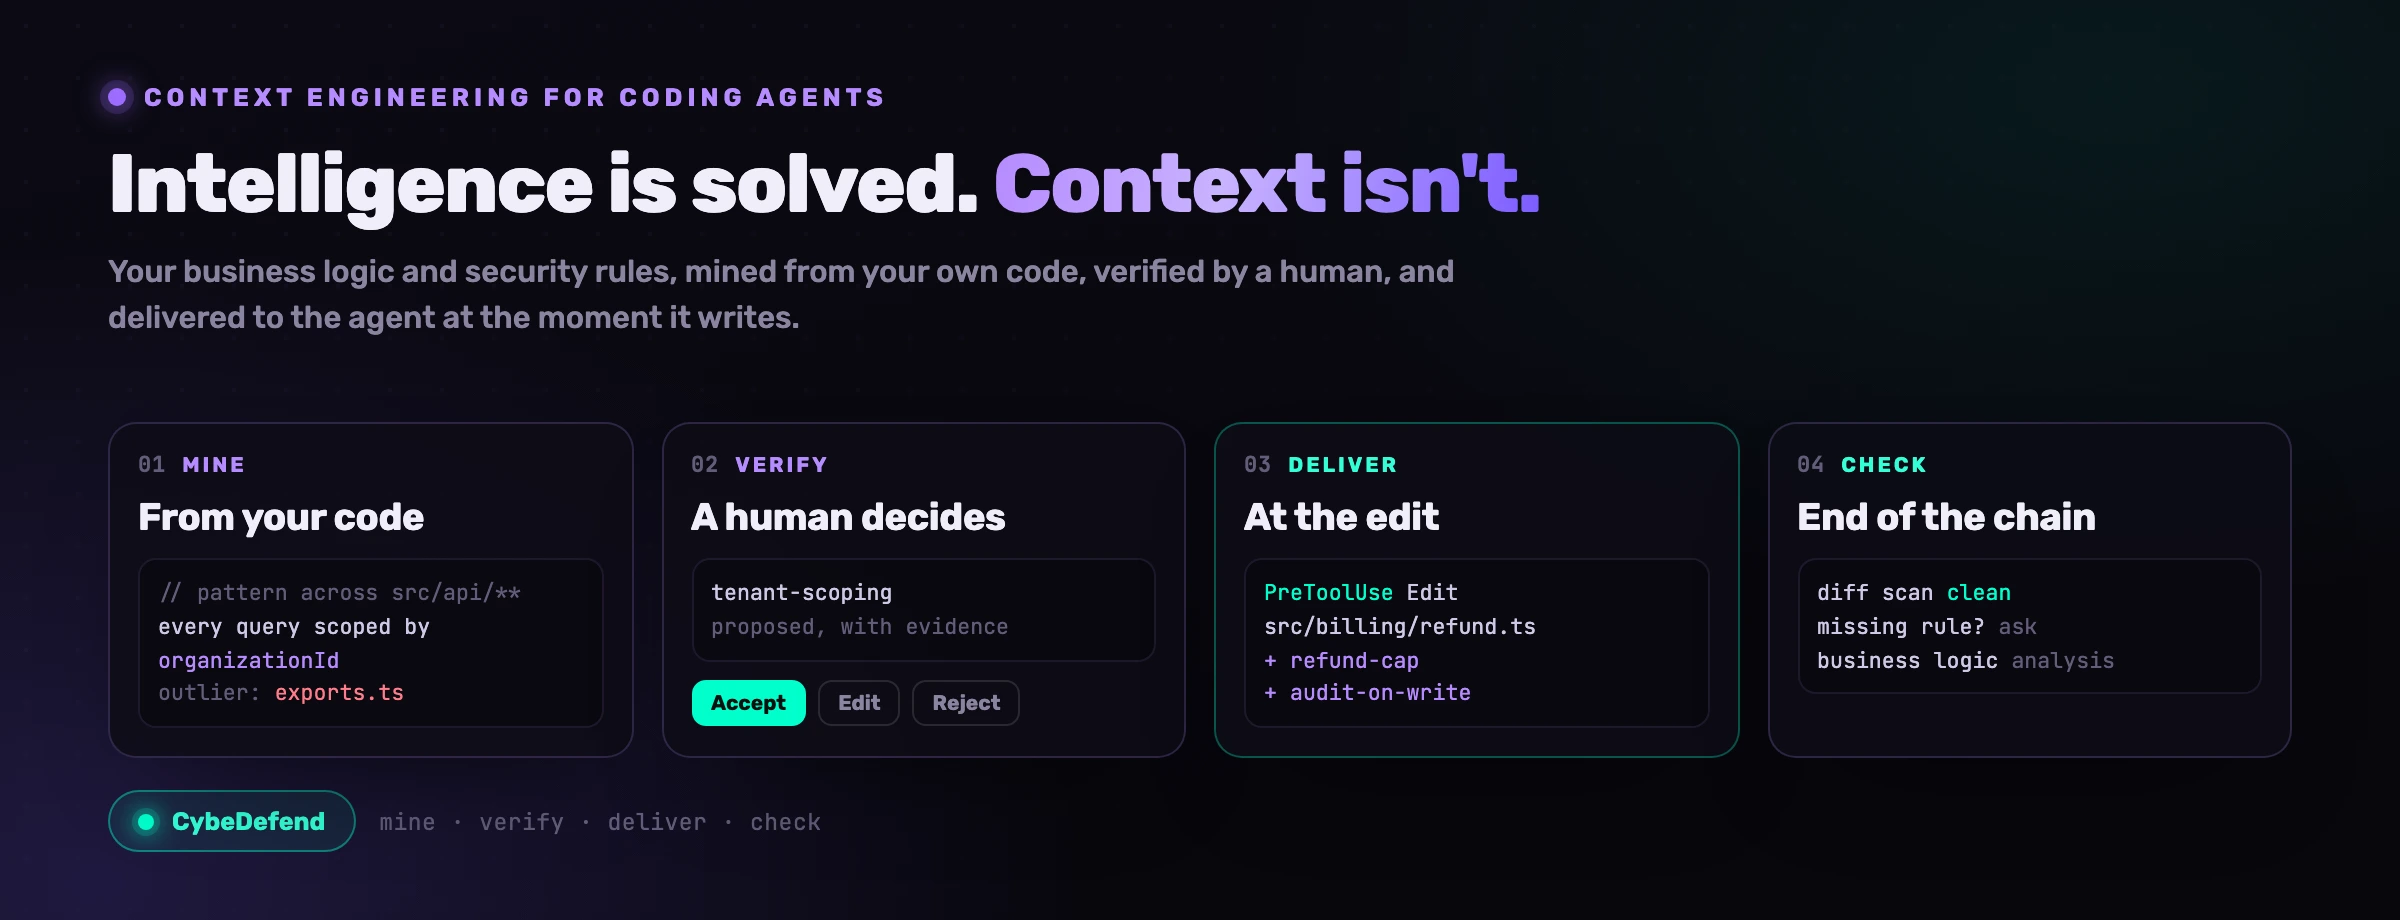
Claude Code ya sabe escribir un endpoint de reembolsos. Lo que no puede saber es que el tuyo responde 422 REFUND_EXCEEDS_CAPTURED, deja un evento de auditoría con el id de quien lo ejecuta y jamás pasa de un tenant a otro. Eso es el contexto: tu lógica de negocio, tu nomenclatura, tus reglas de seguridad. El cuello de botella ya no es la inteligencia del modelo, sino hacerle llegar ese contexto justo cuando escribe. En esta guía verás dónde encaja cada tipo de contexto, un hook que puedes copiar hoy mismo y el método en cuatro pasos con el que CybeDefend lo resuelve para una base de código entera: extraer las reglas de tu código, que una persona las verifique, entregar la que toca en cada edición y comprobar el resultado.
¿Qué significa «contexto» para un agente de código?
Todo lo que el modelo necesita saber de tu sistema y que no puede deducir del código que tiene delante. Anthropic llama a esta disciplina ingeniería de contexto. Birgitta Böckeler, que escribe sobre agentes de código en el sitio de Martin Fowler, recoge la definición más corta que circula: «la ingeniería de contexto consiste en seleccionar lo que ve el modelo para obtener un mejor resultado». Cuando un agente de código trabaja sobre un producto real, ese contexto se reparte en tres capas.
Convenciones
Cómo se escribe el código en esta casa: los patrones del framework, la organización de carpetas, el comando que lanza los tests. El modelo capta casi todo esto del código que lo rodea, y un CLAUDE.md breve cubre lo que falta.
Lógica de negocio
Lo que tu software tiene que hacer y ningún modelo puede deducir: un reembolso nunca supera el importe capturado, por encima de cierto umbral tiene que aprobar un responsable, un estado de pedido se llama SHIPPED y no DISPATCHED. Aquí vive también tu nomenclatura.
Reglas de seguridad
Las que tienen detrás a un regulador o a un cliente. Qué campos son datos personales, qué puede aparecer en un log, qué consulta tiene que filtrarse por tenant, qué acción exige un evento de auditoría.
Casi todas las guías sobre CLAUDE.md hablan de la primera capa. Pero un error del agente cuesta dinero en la segunda y en la tercera, y ahí no mira ningún escáner, porque un reembolso que abona de más es código perfectamente válido.
Esa clase de fallo la tratamos en los fallos de lógica de negocio del código generado por IA. Esta guía va de evitarlo en origen: que el agente conozca la regla en el momento de escribir.
¿Qué límites tienen CLAUDE.md, AGENTS.md y las skills?
Cada uno nació para un trabajo real, y lo hace. Ninguno nació para llevar las reglas de negocio de una empresa hasta el momento de la edición. Veamos dónde se detiene cada uno, con las palabras de su propio fabricante.
CLAUDE.md: se lee una vez y se sigue cuando encaja
La documentación de Anthropic habla con franqueza. Los archivos CLAUDE.md se cargan «al inicio de cada conversación» y «Claude los trata como contexto, no como configuración aplicada». La misma página te pide apuntar a «menos de 200 líneas por archivo CLAUDE.md», porque «los archivos más largos consumen más contexto y reducen la adherencia». Doscientas líneas, para que quepan tus comandos de build, tus convenciones y todas y cada una de tus reglas de negocio.
Hay más. «Si dos reglas se contradicen, Claude puede elegir una de forma arbitraria», y nada contrasta el archivo con el código que describe.
El resultado lo cuentan los propios usuarios en el gestor de incidencias. La incidencia #2901, abierta en julio de 2025 y con 31 comentarios, lo resume así: «Claude Code incumple con frecuencia instrucciones explícitas de proyecto y de usuario definidas en archivos CLAUDE.md». La #33603, que sigue abierta, lleva por título «Reglas estrictas de CLAUDE.md e instrucciones de memoria persistente ignoradas sistemáticamente».
AGENTS.md: el mismo archivo, compartido por más agentes
AGENTS.md es el formato abierto que leen Codex, Cursor, Copilot y otros, presente en más de 60.000 proyectos de código abierto. Su propia web deja clara su naturaleza: «AGENTS.md es simplemente Markdown estándar», «un README para agentes». El estándar resuelve dónde vive el archivo, pero no si alguien lo cumple.
La única prueba rigurosa hasta la fecha no lo deja en buen lugar. En febrero de 2026, Thibaud Gloaguen, Martin Vechev y otros tres coautores publicaron Evaluating AGENTS.md, con esta conclusión: los archivos de contexto «en general no mejoran la tasa de éxito de las tareas, y aumentan el coste de inferencia en más de un 20 % de media». Las instrucciones que contenían se seguían «bien», y los autores reservan estos archivos para «especificar prácticas de programación no estándar»; las descripciones generales del repositorio, en cambio, «no ayudan».
A eso se suman tres límites prácticos:
- Claude Code se lo salta si hay un CLAUDE.md. Con los dos archivos en el repositorio, Claude Code lee por defecto «solo tus archivos CLAUDE.md». Un equipo que mantiene ambos ve cómo Claude Code se salta su AGENTS.md, mientras el resto de sus agentes lo lee.
- Codex le pone techo. Por defecto, Codex deja de añadir archivos de instrucciones en cuanto su tamaño conjunto llega a 32 KiB.
- Copilot lo quiere corto. El prompt que propone GitHub para redactar tus instrucciones exige que «no ocupen más de 2 páginas» y que «no sean específicas de una tarea». Y una regla de negocio es, por naturaleza, específica de una tarea.
Skills: se cargan cuando el agente se acuerda de ellas
Una skill es una carpeta de instrucciones y scripts que solo se carga cuando se usa. La documentación de Anthropic sobre las skills explica cómo elige Claude: lee la descripción de la skill para «decidir cuándo aplicarla». Una regla empaquetada como skill, por tanto, solo se aplica si el agente reconoce que ha llegado el momento.
La misma documentación enumera las maneras en que ese reconocimiento falla. La descripción se «trunca a los 1.536 caracteres». Con muchas skills instaladas, Claude Code «descarta algunas descripciones para no pasarse del presupuesto de caracteres del listado, lo que elimina las palabras clave que Claude necesita para asociarlas a tu petición». Y cuando una sesión larga se compacta, «las skills más antiguas pueden desaparecer por completo».
Para procedimientos, las skills son excelentes. Como vehículo de reglas que tienen que cumplirse siempre, dependen justo de aquello de lo que intentas no depender. Y una skill escrita por otra persona ejecuta código en tu sesión, lo que ya es un riesgo en sí: lee ¿son seguras las skills de Claude Code?.
Lo que no hace ninguno
Los tres dan por hecho que lo difícil ya está resuelto. Ninguno de ellos:
- encuentra tus reglas. Cada uno contiene solo lo que alguien se acordó de escribir.
- sabe qué regla se aplica a esta edición. Se cargan por sesión, por ruta o por descripción, nunca en función de lo que hace de verdad el código que se está escribiendo.
- se entera de que una regla ya no cuadra con el código. Un valor desfasado sigue en el archivo hasta que alguien, por casualidad, lo lee.
- comprueba el resultado. Si la regla se respetó o no, queda en manos de la revisión de código.
- funciona igual en todos tus agentes. Un equipo que trabaja con cinco agentes mantiene cinco dialectos.
¿Por qué el agente pierde la regla antes de escribir?
Porque la atención de un modelo no es uniforme, y una regla leída al principio queda muy lejos de la edición cuando por fin hace falta. El equipo de ingeniería de Anthropic lo dice sin rodeos: el contexto «debe tratarse como un recurso finito, con rendimientos marginales decrecientes». Y le pone nombre al efecto, context rot: «a medida que aumenta el número de tokens en la ventana de contexto, disminuye la capacidad del modelo para recordar con precisión la información de ese contexto».
Hay trabajos independientes que lo han medido. Chroma probó 18 modelos en su informe Context Rot y comprobó que «el rendimiento de los modelos se degrada a medida que crece la longitud de la entrada, a menudo de formas sorprendentes y nada uniformes». Antes, el estudio Lost in the Middle ya había mostrado que el rendimiento «se degrada de forma significativa cuando los modelos tienen que acceder a información relevante situada en mitad de contextos largos». Y IFScale, que apila instrucciones unas encima de otras, vio que con 500 instrucciones simultáneas «incluso los mejores modelos de frontera solo alcanzan un 68 % de precisión».
La seguridad no se libra. En el benchmark SusVibes, el 57 % de las soluciones que produjo SWE-Agent con Claude Sonnet 4 eran funcionalmente correctas, pero solo el 11,8 % eran seguras, y «completar la petición de funcionalidad con pistas sobre vulnerabilidades» no lo arregló. Pedirle a un agente que tenga cuidado no equivale a darle tus reglas.
Nuestra propia medición fue a por el caso más difícil: reglas para las que el agente ya tiene una respuesta plausible de cosecha propia. Una sección de reglas realista en CLAUDE.md sacó 7 valores exactos de 55, exactamente lo mismo que no tener ningún archivo. El protocolo completo está en ¿Claude Code sigue tu CLAUDE.md?.
Lo explican dos fuerzas. La primera es la dilución: en la trigésima edición, el archivo es un fragmento viejo enterrado bajo decenas de miles de tokens de código y de salidas. La segunda es la costumbre: el código que el agente tiene delante le enseña cómo se hacen aquí las cosas, y encima compila.
Veamos cómo se nota en un solo prompt. El 27 de septiembre de 2026 le pedimos a Claude Code (con el modelo Haiku) que escribiera una función de reembolso en un repositorio vacío, primero sin ninguna regla y después con el hook que mostramos más abajo, cargado con nuestra regla de reembolsos. Una ejecución por caso: es una ilustración, no una medición.
Las líneas que cambió la regla, en la segunda ejecución:
if (amountCents > availableForRefund) {
  throw new RefundError("REFUND_EXCEEDS_CAPTURED");
}
order.refundedCents += amountCents;
await audit.log("refund.created", {
  orderId: order.id, amountCents, actorId,
});
Las dos versiones son código razonable, pero solo una es tu código. Esa distancia, el comportamiento correcto con los detalles equivocados, es la que se le escapa a quien revisa y la que rompe a quien consume tu API.
CLAUDE.md, reglas, skills, MCP o hooks: ¿qué lleva cada uno?
Cada mecanismo llega al modelo en un momento distinto, y es ese momento el que decide para qué sirve.
| Mecanismo | Cuándo llega al modelo | Sirve para | Donde falla |
|---|---|---|---|
| CLAUDE.md o AGENTS.md | Una vez, al arrancar la sesión | Comandos de build, estructura, convenciones, prácticas no estándar | Un valor concreto que hace falta treinta ediciones después |
.claude/rules/ con paths | Cuando Claude lee un archivo que coincide con el patrón | Reglas ligadas a un directorio o a un tipo de archivo | Reglas que dependen de lo que hace el código, no de dónde está |
| Skills | Cuando Claude decide que una skill encaja con la tarea | Procedimientos y playbooks que, si no, pegarías a mano | Reglas que tienen que aplicarse tanto si el agente piensa en ellas como si no |
| Herramientas MCP | Cuando el agente decide llamarlas | Corpus grandes, búsqueda, datos en vivo | Todo lo que dependa de que el agente se acuerde de preguntar |
| Hooks | En un evento, cada vez que ocurre: inicio de sesión, prompt, antes o después de una herramienta | La regla adecuada en la edición; bloquear un comando | Nada, salvo que la lógica de coincidencia la escribes tú |
Fíjate en la segunda columna. Un archivo, una skill o una herramienta MCP dependen de algo que ocurrió antes o de que el modelo decida mirar. Un hook, en cambio, lo ejecuta el harness, piense el modelo en él o no.
Las reglas acotadas por ruta quedan a medio camino. Según la documentación de Anthropic, «se activan cuando Claude lee archivos que coinciden con el patrón, no en cada uso de una herramienta». Es una mejora real frente a un único archivo grande, pero el disparador sigue siendo una ruta y no la operación.
Si te preocupa la seguridad de las skills, que ejecutan código sacado del repositorio de otra persona, lee ¿son seguras las skills de Claude Code?.
¿Cómo se entrega una regla en el momento de la edición?
Con un hook PreToolUse sobre las herramientas de escritura, que busca las reglas del archivo que se va a escribir y las devuelve como additionalContext. Hacen falta tres archivos. El primero registra el hook en .claude/settings.json:
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          { "type": "command", "command": "node \"$CLAUDE_PROJECT_DIR/.claude/hooks/rules-at-edit.mjs\"" }
        ]
      }
    ]
  }
}
Después, cada regla va en un archivo pequeño dentro de .claude/edit-rules/, con las rutas a las que se aplica en la primera línea:
applies-to: src/billing/**, src/api/refunds/**
Refunds: never refund more than the captured amount.
Answer 422 with the code REFUND_EXCEEDS_CAPTURED, never a prose message.
Every refund writes an audit event: audit.log("refund.created", { orderId, amountCents, actorId }).
Y queda el hook en sí, .claude/hooks/rules-at-edit.mjs, que necesita Node 22.5 o posterior por path.matchesGlob:
import { readFileSync, readdirSync } from "node:fs";
import path from "node:path";

const root = process.env.CLAUDE_PROJECT_DIR ?? process.cwd();
const input = JSON.parse(readFileSync(0, "utf8"));
const file = path.relative(root, input.tool_input?.file_path ?? "");
const dir = path.join(root, ".claude/edit-rules");

const rules = readdirSync(dir)
  .map((name) => readFileSync(path.join(dir, name), "utf8"))
  .filter((text) => {
    const globs = text.match(/^applies-to:\s*(.+)$/m)?.[1] ?? "";
    return globs.split(",").some((g) => path.matchesGlob(file, g.trim()));
  });

if (rules.length > 0) {
  // JSON, not plain text: on PreToolUse, Claude Code only reads additionalContext.
  process.stdout.write(JSON.stringify({
    hookSpecificOutput: {
      hookEventName: "PreToolUse",
      additionalContext: `Rules for ${file}:\n\n${rules.join("\n---\n")}`,
    },
  }));
}
Este es el montaje que produjo la columna de la derecha en la comparación de reembolsos de más arriba. Claude Code coloca el contexto de los hooks «junto al resultado de la herramienta», así que el agente lee la regla a la vez que el resultado de su escritura en ese archivo, y corrige sobre la marcha. En nuestra ejecución escribió la función, leyó la regla y contestó «He actualizado la función para» antes de enumerar el código de error y el evento de auditoría.
Cada uno de los otros agentes habla su propio dialecto. Codex, de OpenAI, documenta la misma forma en PreToolUse: «para añadir contexto visible para el modelo sin bloquear, devuelve hookSpecificOutput.additionalContext». En Cursor, el hook preToolUse puede permitir, denegar o reescribir una llamada, y postToolUse añade additional_context «después del resultado de la herramienta». Las instrucciones de repositorio de GitHub Copilot acotan un archivo con un patrón applyTo, y manda el AGENTS.md más cercano en el árbol.
¿Dónde se queda corta la versión casera?
En las reglas mismas. El hook arregla el momento, y vale la pena instalarlo hoy, pero deja en pie el resto de la lista de arriba: las reglas siguen saliendo de la memoria de alguien y siguen quedándose desfasadas, nada comprueba si se han respetado y cada agente del equipo necesita su propia versión. Encima añade un límite propio, porque una ruta no es una intención: nada impide escribir un reembolso en utils.ts, y un glob no distingue un reembolso de un formateador. En cuanto pasas de diez reglas y de un solo agente, mantener todo esto a mano se convierte en un trabajo aparte.
¿Cómo es el método completo?
Arranca justo donde se detienen todos los archivos: sin ninguna regla escrita. Es el método que CybeDefend aplica con VibeDefend, desde la base de código hasta el diff, y está pensado para un equipo de desarrollo, no para el portátil de una sola persona.
Las reglas viven en un único sitio por proyecto, el agente de cada desarrollador recibe el mismo conjunto verificado, y cada paso existe porque existe uno de los límites que acabamos de ver.
Paso 1: extrae las reglas de tu propio código
Tus reglas ya están en tu código, escritas en forma de repetición. Una vez conectado y analizado el repositorio, un motor de extracción recorre su grafo de código en busca de cinco tipos de regularidad:
- Patrones de presencia: un campo o una llamada que llevan casi todas las instancias. Todas las entidades tienen un
organizationId, todas las escrituras enordersllaman al logger de auditoría. - Conjuntos de valores: los nombres literales que usa tu código para estados, roles y códigos de error. Es tu nomenclatura, y un agente que se inventa un sexto estado de pedido rompe a todos los consumidores de los otros cinco.
- Coocurrencias: guardas y decoradores que siempre van juntos, como un control de autenticación y un rate limit.
- Llamadas obligatorias antes de una operación sensible: comprobación de permisos, filtrado por tenant, rate limits, feature flags.
- Convenciones que un modelo pone por nombre a partir de grupos de código parecido, con la lista de casos atípicos.
Cada propuesta llega con su evidencia (dónde se encontró el patrón y con qué frecuencia) y con un nivel de confianza. Lo más valioso son los casos atípicos. En una base de código donde cuarenta endpoints filtran por tenant, el único que no lo hace es o una excepción deliberada o un fallo en el que nadie reparó. Justo ahí se cruzan la lógica de negocio y la seguridad.
Paso 2: que una persona verifique cada regla
La extracción propone, nunca decide. Un patrón puede ser una simple costumbre y no una regla. Y una regla es política: quien la escribe dirige a todos los agentes del equipo, razón por la cual los archivos de instrucciones son una superficie de ataque por derecho propio.
En VibeDefend, cada propuesta se acepta, se edita o se rechaza desde el dashboard, o desde el propio agente al arrancar una sesión. Una regla que sugiere el agente se rechaza salvo que tú la hayas confirmado. Cada semana, un control de deriva propone una actualización si el código se aleja de una regla aceptada, y así las reglas siguen siendo ciertas sin que nadie tenga que mantener un archivo.
Paso 3: entrega la regla adecuada en la edición
Es el hook de la sección anterior, con recuperación en lugar de globs. Antes de cada escritura se envían como intención la ruta del archivo y el comienzo del código que se va a escribir, y vuelven, como contexto para ese archivo, hasta cinco reglas de negocio y cinco de seguridad relevantes para ese cambio. El instalador lo conecta a Claude Code, Cursor, Codex, Windsurf y GitHub Copilot en VS Code, cada uno con los límites de su propio sistema de hooks.
Entregar informa al agente, no lo obliga. Para lo que no debe ocurrir nunca hay una guarda aparte, que revisa cada comando antes de que se ejecute y puede bloquearlo. La regla en el contexto es una sugerencia fuerte; la guarda sobre la acción es el control. Preferimos decir claramente cuál es cuál.
Paso 4: comprueba el resultado al final de la cadena
Tres controles, que van de la sesión a la arquitectura:
- Al cerrar una sesión, una revisión se hace una única pregunta: ¿ha sacado a la luz este trabajo una regla duradera que no está escrita en ninguna parte? Propone una como mucho, a menudo ninguna, y no se registra nada sin tu visto bueno.
- Antes del commit, se escanea el diff en busca de vulnerabilidades, errores de configuración de la infraestructura y secretos, para que el agente los corrija en la misma sesión.
- Sobre la lógica de negocio en sí, BLSA, nuestro Business Logic Security Analysis, recorre toda la arquitectura segmento a segmento para encontrar lo que ningún patrón detecta: un reembolso que se puede repetir, un tenant capaz de leer los datos de otro, datos personales que se escapan por una exportación, una operación que no es idempotente. BLSA es una línea de investigación que llevamos con el CNRS y el laboratorio CRIStAL. Ya funciona con design partners, pero todavía no está disponible para todo el mundo. Mira lo que busca en fintech.
Si se ponen uno al lado del otro, la diferencia tiene menos que ver con el agente que con el equipo que lo rodea.
¿Qué cambia cuando la regla llega en el momento de la edición?
Que la mayoría de las reglas dejan de perderse por el camino. Nuestro estudio controlado pasó 30 tickets de desarrollo por tres agentes autónomos, sobre una sola base de código y con un solo modelo. En las 19 tareas de su primera fase, tanto el agente sin reglas como el agente con un archivo de reglas realista implementaron de forma exacta 7 de 55 detalles de regla. El que recibía las reglas en la edición implementó 46 de 53.
exactas sin ninguna regla (7 de 55)
exactas con una sección de reglas realista en CLAUDE.md (7 de 55)
exactas con la regla entregada en la edición (46 de 53)
Conviene precisar qué mide esto y qué no. Mide la entrega en el momento de la edición: las 49 reglas las escribimos nosotros, no salieron de una extracción, así que de momento no dice nada sobre la calidad de la extracción. Se trata de una sola base de código, con una ejecución por brazo y por tarea, calificada a ciegas por auditores que son modelos. Y el estudio incluye su propio contraejemplo: en una tarea, una regla se entregó trece veces y el agente la incumplió igualmente, que es precisamente la razón de ser de la guarda. El protocolo y todas las cifras están en el estudio.
¿Por dónde empezar esta semana?
Por diez reglas, no por una plataforma.
- Apunta diez reglas que tu equipo repite al revisar código: los comentarios que has escrito más de dos veces.
- Clasifícalas con una sola pregunta: ¿las adivinaría un ingeniero competente recién llegado al equipo? Si la respuesta es sí, van en CLAUDE.md. Si es no, tienen que llegar al agente en la edición.
- Acota lo que depende de un directorio con
.claude/rules/y un campopaths. - Añade el hook de arriba para las reglas arbitrarias, y comprueba que devuelve JSON.
- Convierte todo lo que no debe pasar nunca en una regla deny o en una guarda, no en una frase.
- Pruébalo donde falla: una funcionalidad que toque una regla, treinta turnos después de arrancar la sesión.
El día en que la lista ya no te quepa en la cabeza, toca extraerla en lugar de escribirla.
Preguntas frecuentes
¿Cómo dar contexto a Claude Code sobre mi código?
Por capas, y son tres. Los comandos de build, la estructura y las convenciones van en un CLAUDE.md corto, que Claude lee al principio de cada sesión. Las reglas propias de un directorio van en .claude/rules/ con un campo paths, para que se carguen cuando Claude lea un archivo que coincida. Y las reglas de negocio y de seguridad que el modelo no puede adivinar (códigos de error, umbrales, formatos de auditoría) se entregan en el momento de la edición, con un hook PreToolUse que devuelve additionalContext en JSON.
¿Qué diferencia hay entre skills y hooks en Claude Code?
Una skill es algo que Claude elige cargar; un hook es algo que Claude Code ejecuta, lo elija Claude o no. La descripción de una skill está en el contexto y su cuerpo se carga cuando la invoca Claude, o tú, así que es buena para procedimientos. Un hook se dispara con un evento (el inicio de una sesión, un prompt, una llamada a una herramienta), y por eso es el sitio adecuado para una regla que tiene que llegar al agente siempre, o para bloquear un comando.
¿En qué se diferencian las rules y las skills de Claude Code?
Las reglas son instrucciones; las skills, procedimientos. Los archivos de .claude/rules/ se cargan en el contexto sin condiciones, o cuando Claude lee un archivo que coincide con su patrón paths. Una skill empaqueta un procedimiento de varios pasos, con scripts opcionales, y solo se carga cuando se usa. Usa reglas para lo que el código tiene que cumplir siempre, y skills para explicar cómo se lleva a cabo una tarea.
¿Se pueden definir reglas en Claude Code?
Sí. Los archivos Markdown de .claude/rules/ se cargan como instrucciones, de forma recursiva, con un tema por archivo. Si una regla lleva un campo paths en su frontmatter, solo se carga cuando Claude lee un archivo que coincide con alguno de sus patrones glob; sin ese campo, se carga en todas las sesiones. Las reglas personales, en ~/.claude/rules/, se aplican a todos los proyectos de tu máquina.
¿Sirven de algo los hooks de Claude Code?
Para todo lo que tiene que ocurrir siempre, son el único mecanismo fiable. La propia documentación de Anthropic dice que, para bloquear una acción «decida lo que decida Claude», hay que usar un hook PreToolUse y no una instrucción. Los hooks también pueden añadir contexto en un momento preciso, por ejemplo las reglas del archivo que se está escribiendo, algo que un archivo leído al inicio de la sesión no puede hacer.
Mi hook PreToolUse se ejecuta, pero Claude ignora su salida: ¿por qué?
Porque el texto plano que imprime un hook PreToolUse va al log de depuración, no al modelo. Claude Code solo añade al contexto la stdout en texto plano en UserPromptSubmit, UserPromptExpansion, SessionStart y PostModelSwitch. Devuelve JSON en su lugar, con hookSpecificOutput.hookEventName a PreToolUse y tu texto en additionalContext. Comprobamos la diferencia con Claude Code 2.1.282 el 27 de septiembre de 2026.
¿Qué es la ingeniería de contexto en los agentes de código?
Es decidir qué información llega a la ventana de contexto del modelo, y cuándo, para que haga bien la tarea. En un agente de código tiene menos que ver con escribir un prompt más largo que con elegir el momento: los hechos estables al inicio de la sesión, las reglas relevantes en el momento de la edición y nada más que compita por su atención. El equipo de ingeniería de Anthropic usa el término para referirse a la disciplina en su conjunto.
¿Claude Code puede generar el CLAUDE.md automáticamente?
Sí: /init analiza tu base de código y escribe un CLAUDE.md inicial con los comandos de build, las instrucciones para los tests y las convenciones que descubre. Para la primera capa de contexto es un buen punto de partida, pero no equivale a extraer reglas de negocio. El estudio Evaluating AGENTS.md vio que, en general, los archivos de contexto generados por un modelo no mejoraban el éxito en las tareas. Y un archivo generado sigue llegando una sola vez, al inicio de la sesión, y sigue necesitando que alguien lo verifique.
¿Claude Code lee el AGENTS.md?
Sí, cuando no hay CLAUDE.md. Según la documentación de Anthropic, Claude Code lee AGENTS.md como instrucciones del proyecto si no encuentra ni CLAUDE.md ni CLAUDE.local.md en el directorio de trabajo ni en los superiores. Si están los dos archivos, por defecto solo lee tus archivos CLAUDE.md, a menos que tu CLAUDE.md importe AGENTS.md o que cambies ese ajuste. En cualquier caso el mecanismo es el mismo, un archivo que se carga al inicio de la sesión, con los mismos límites para las reglas que hacen falta treinta ediciones después.


