

En esta página
- ¿Claude Code sigue tu CLAUDE.md?
- ¿Qué dice ya la investigación publicada?
- ¿Qué medimos nosotros que los estudios grandes no midieron?
- ¿Qué pasa cuando la regla sí está en el archivo, con el valor correcto?
- ¿Eran reglas imposibles de adivinar por diseño?
- ¿Por qué dos agentes configurados distinto cometen el mismo error?
- ¿Lo arregla un CLAUDE.md perfecto?
- ¿Qué dicen los proveedores de seguridad sobre los archivos de reglas?
- ¿Qué merece la pena cambiar y qué no?
- ¿Cuánto hay que fiarse de estas cifras?
- Lo que vendemos, dicho sin adornos
- Preguntas frecuentes
- ¿Claude Code hace caso de verdad al CLAUDE.md?
- ¿Cómo se escribe un buen CLAUDE.md?
- ¿Qué debe contener un CLAUDE.md?
- ¿Qué longitud debe tener un CLAUDE.md?
- ¿Claude Code lee AGENTS.md o solo CLAUDE.md?
- ¿Por qué Claude Code no sigue mis reglas?
- ¿Sirve de algo el CLAUDE.md?
- ¿Hay que subir el CLAUDE.md al repositorio?
- ¿Karpathy midió de verdad una caída de errores del 40 % al 11 % con un CLAUDE.md?
- ¿Cómo se obliga de verdad a cumplir una regla en Claude Code?
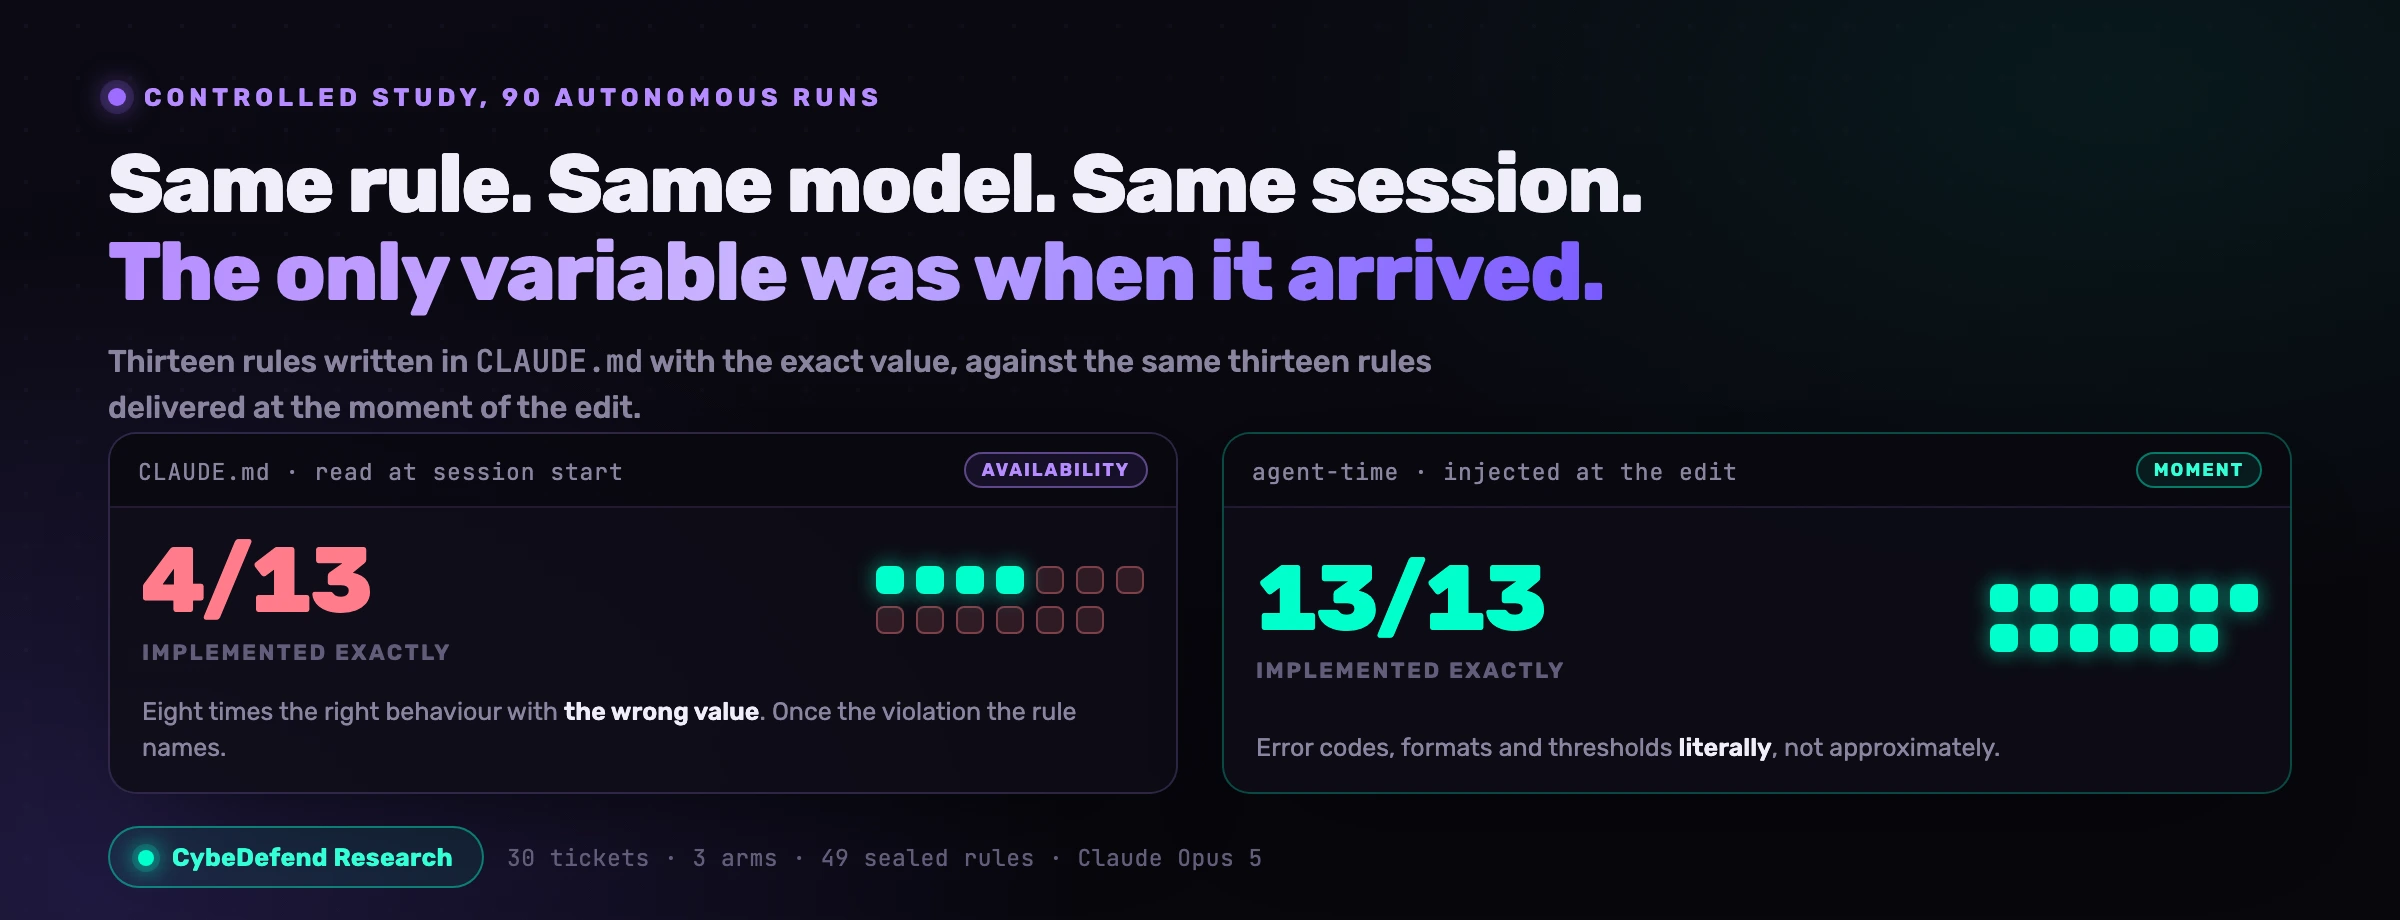
Claude Code cumple tu CLAUDE.md justo en aquello que habría hecho bien sin el archivo, y se lo salta en aquello que te llevó a escribirlo. Lo medimos así: 30 tickets de desarrollo, una sola base de código, un solo modelo y tres agentes autónomos trabajando en paralelo, 90 ejecuciones en total. Entre los tres brazos solo cambiaba una cosa, la vía por la que el agente podía llegar a las 49 reglas de negocio y de cumplimiento de la plataforma. El brazo que llevaba una sección de reglas escrita a mano en CLAUDE.md, con el desgaste de cualquier archivo real, acertó el valor exacto en 7 de 55 casos. El brazo que no tenía ninguna regla acertó 7 de 55. El mismo resultado.
¿Claude Code sigue tu CLAUDE.md?
En parte, y la parte que se deja por el camino es justo la que te importa.
Anthropic no lo esconde. Su página sobre la memoria dice que los archivos CLAUDE.md «se cargan al inicio de cada conversación» y que «Claude los trata como contexto, no como configuración aplicada». La de resolución de problemas es todavía más directa: «Claude lo lee e intenta seguirlo, pero no hay ninguna garantía de cumplimiento estricto, sobre todo con instrucciones vagas o contradictorias».
Lo que no vas a encontrar en esa documentación, a 13 de septiembre de 2026, es una cifra. Ninguna tasa de cumplimiento medida. Para el fabricante es una decisión razonable; para el equipo que tiene que decidir si ese archivo es un control o una recomendación, no sirve de nada.
La pregunta, mientras tanto, sigue ahí. Si buscas en las incidencias de anthropics/claude-code los títulos que mencionan a la vez CLAUDE.md y alguna forma de «ignore», salen 199 resultados, 9 de ellos todavía abiertos a 13 de septiembre de 2026. No todos van de cumplimiento de reglas, pero hay un título que se repite y no deja lugar a dudas: CLAUDE.md Mandatory Rules Consistently Ignored Across Multiple Repositories, abierta desde junio de 2025 y con 45 reacciones. Lo revelador es el plural: el título habla de varios repositorios a la vez. Nadie está reportando un bug, están describiendo cómo se comporta la herramienta.
¿Qué dice ya la investigación publicada?
Dos cosas. Que nada de lo que solemos retocar cambia el resultado: ni el tamaño del archivo, ni el sitio donde pones la regla, ni repartirlo en varios archivos, ni limpiar las contradicciones. Y que el cumplimiento se degrada según se alarga la sesión. Conviene decir de entrada que esto no lo hemos descubierto nosotros.
En mayo de 2026, Damon McMillan publicó Instruction Adherence in Coding Agent Configuration Files: A Factorial Study of Four File-Structure Variables (arXiv 2605.10039, enviado el 11 de mayo de 2026). Es, con diferencia, el trabajo con más potencia estadística sobre el tema: 1.650 sesiones de Claude Code CLI, 16.050 observaciones a nivel de función, dos bases de código en TypeScript, cinco tareas de programación y Sonnet 4.6, con Opus 4.6 como contraste entre modelos. Las cuatro variables se manipularon de forma factorial: tamaño del archivo, posición de la instrucción, arquitectura del archivo y contradicciones con archivos vecinos.
El veredicto, en palabras del propio artículo: «ninguna de las cuatro variables estructurales, ni ninguna de las tres interacciones de segundo orden, produce un contraste detectable una vez corregidas las comparaciones múltiples». En tamaño y en conflictos, además, el nulo viene respaldado por factores de Bayes a su favor (BF10 entre 0,05 y 0,10), que es bastante más que no haber podido rechazar la hipótesis. Lo único que se movió fue el paso del tiempo dentro de la sesión: «cada función adicional que el agente genera se asocia a una caída aproximada del 5,6 % en las probabilidades de cumplimiento por paso (OR = 0,944)», un efecto que el artículo describe como no monótono.
Ese segundo punto es el que abre la puerta a nuestro estudio. Una anotación trivial es una marca que el agente no tiene ningún motivo para escribir si el archivo no se la pide: el archivo parte de cero y, efectivamente, lleva el cumplimiento de casi nada a algo. Nosotros nos hicimos la pregunta incómoda para nuestro propio negocio: ¿y cuando el agente ya trae una respuesta plausible puesta, y la regla dice que esa respuesta plausible está mal?
¿Qué medimos nosotros que los estudios grandes no midieron?
El caso en el que el agente ya tiene una respuesta. Nuestro estudio controlado, publicado el 24 de agosto de 2026, pasó 30 tickets de desarrollo por una base de código Express y SQLite de tamaño medio, por triplicado: tres agentes autónomos, los mismos tickets, el mismo modelo (Claude Opus 5 con effort high), 90 ejecuciones y 93 escaneos de seguridad independientes. Lo único que cambiaba de un brazo a otro era la vía de acceso a las 49 reglas de la plataforma: ninguna, una sección de reglas en el CLAUDE.md del repositorio, o inyección en el momento mismo de la edición.
Las reglas cubren once familias, de los reembolsos y la aritmética de fidelización a la minimización del RGPD, la obligación de precio de referencia de la directiva Ómnibus, los topes de efectivo y los rastros de auditoría. Cada una arrastra un detalle deliberadamente arbitrario: 422 REFUND_EXCEEDS_CAPTURED, un umbral de 150,00 euros para la aprobación del responsable, erased-{id}@removed.invalid, ORD-{store}-{YYMMDD}-{seq}.
La sección del brazo con archivo se escribió como se escriben de verdad en las empresas: 41 líneas que cubren cerca de la mitad del corpus, con las reglas parafraseadas, dos valores desfasados y familias enteras que sencillamente no están. Lo que el archivo decía de cada regla quedó sellado antes de la primera ejecución, igual que el corpus. Los tickets se redactaron como incidencias, en voz de desarrollador, y una comprobación automática verificó que ninguno filtrara un literal. Tres auditores ciegos evaluaron cada diff sin saber de qué brazo venía.
reglas con su valor exacto usando una sección de reglas realista en CLAUDE.md
reglas con su valor exacto sin ningún archivo de reglas
reglas con su valor exacto cuando la regla llega en la edición
Siete de 55 en los dos brazos de control. No parecido: idéntico. En las diecinueve tareas de la fase 1, tener un archivo de reglas realista en el repositorio no movió nada medible en el código entregado.
Lo que sí cambió fue la forma del error, y esa es la única aportación que le hemos podido demostrar al archivo: el brazo sin nada violó más reglas (18 frente a 12), y el brazo con archivo produjo más veces el comportamiento correcto con el valor equivocado (28 frente a 20). Un documento parafraseado mueve los fallos de «violada» a «casi». No los convierte en «exacta».
¿Qué pasa cuando la regla sí está en el archivo, con el valor correcto?
Se implementa tal cual el 31 % de las veces. Como habíamos sellado de antemano lo que el archivo decía de cada regla, podemos partir la fase 1 según su contenido real. En 13 reglas el valor correcto estaba ahí, por escrito, en un documento que se carga al principio de cada sesión.
| Lo que el archivo decía de la regla | Reglas evaluadas | Exactas | Correcto, con otro valor | Violadas | Exactas en la edición |
|---|---|---|---|---|---|
| Exacta, el valor correcto, por escrito | 13 | 4 (31 %) | 8 | 1 | 13 (100 %) |
| Vaga, la dirección sin el valor | 21 | 2 (10 %) | 13 | 2 | 15 (71 %) |
| Ausente, nunca escrita | 20 | 1 (5 %) | 6 | 9 | 18 (90 %) |
Esa primera fila merece una segunda lectura. La información estaba disponible: lo que cambiaba era el momento en que llegaba.
El ejemplo más claro es la tarea M06. El ticket pide aceptar una tarjeta regalo por debajo del importe de la cesta y cobrar el resto con tarjeta bancaria. La regla dice que se gana un punto de fidelidad por cada euro entero pagado en dinero, y que la parte cubierta con la tarjeta regalo no genera ninguno. El brazo con archivo tenía esa regla, con su valor exacto. Reescribió la función de pago, calculó la parte elegible para ordenar los medios de pago y dejó intacta la línea floor(total / 100), que sigue repartiendo puntos sobre el total. En el flujo que él mismo acababa de escribir, los euros de tarjeta regalo dan fidelidad.
El trabajo de un ingeniero cuidadoso que nunca ha visto el documento de reglas.
Lo había visto. Al arrancar la sesión, en un archivo cargado antes del primer turno. El brazo que recibió esa misma regla dentro de su bucle, mientras editaba el archivo de pagos, escribió earned = floor(remainderCents / 100) y le puso dos tests propios.
¿Eran reglas imposibles de adivinar por diseño?
Algunas sí, y es una objeción que toca responder, no esquivar. Antes de la primera ejecución clasificamos regla por regla hasta qué punto el modelo podía llegar a ellas por su cuenta: 35 imposibles de adivinar, 13 débilmente adivinables y 1 adivinable. Los detalles arbitrarios son deliberados, porque son la única forma de distinguir entre conocer una regla y acertar una razonable.
La tarea M21 es exactamente esa frontera. Los tres brazos limitaron los pagos en efectivo a 1.000 euros, porque es un hecho jurídico público que el modelo ya sabe y que no hace falta contarle. Solo el brazo que recibió la regla respondió con el código de error propio de la plataforma, 422 CASH_LIMIT, probado al céntimo en el límite y sobre la parte en efectivo de un pago mixto. Los otros dos devolvieron un 422 con un mensaje en prosa.
Para quien consume tu API eso no es lo mismo: un caso está contemplado, el otro se lo tiene que adivinar quien escriba la integración. Lo que una empresa paga no es lo que el modelo sabe del mundo, es el contrato arbitrario que hace que sus propios sistemas se entiendan entre sí.
Y a quien le parezca que nuestro corpus es demasiado arbitrario, le devolvemos la pregunta de M21: ¿tus códigos de error y tus formatos lo son menos?
¿Por qué dos agentes configurados distinto cometen el mismo error?
Porque el error de un agente es determinista, no aleatorio. Es el resultado que no habíamos anticipado y el que más consecuencias tiene en el día a día. En 16 de las 30 tareas, los dos brazos de control, ejecutados por separado y en árboles distintos, llegaron a la misma implementación equivocada. No a una parecida. A la misma.
- El mismo SQL de escritura absoluta en el recuento anual,
quantity = excluded.quantity, donde la regla exige un movimiento tipado en un libro de movimientos. - El mismo diseño prohibido para las promociones que se solapan: que el solape es una funcionalidad y que gana la más potente. Es el instinto de cualquier ingeniero, y justo lo que prohíbe la regla de precios.
- El mismo límite de 4.000 caracteres para los diagnósticos que se conservan, y el mismo campo
ibanolvidado en la lista de campos que hay que anonimizar.
Si das por hecho que una salida mala de un agente es una tirada de dados, y que la revisión la caza a la segunda o a la tercera, deja esa idea. La empresa que no pone su contrato delante del agente no recibe un abanico de interpretaciones entre las que un revisor pueda elegir. Recibe en todas partes la misma interpretación razonable y equivocada, y además defendida por los mismos tests.
Esa segunda parte es la que duele. Tras 30 tickets, los brazos de control dejaron atrás 57 y 52 reglas incumplidas, de las cuales 21 y 12 eran violaciones abiertas: datos personales en una exportación para el transportista y en los logs, un precio tachado ilegal, puntos de fidelidad sobre tarjetas regalo, stock sobrescrito sin dejar rastro.
Al menos un tercio quedaron fijadas por tests en verde que los propios agentes habían escrito. La deuda no solo es silenciosa: además la defiende la CI. Lo contamos con más detalle en los fallos de lógica de negocio del código generado por IA.
¿Lo arregla un CLAUDE.md perfecto?
Te lleva dos tercios del camino, y lo comprobamos en lugar de suponerlo. A la altura de la tarea 22, la diferencia entre brazos planteaba una objeción legítima: ¿había tenido el archivo alguna oportunidad de verdad? Así que registramos por adelantado una enmienda al protocolo y sustituimos la sección desfasada por el corpus completo de 49 reglas, verbatim, con todos los literales de máquina y presentado como recién sincronizado por el equipo de ingeniería. Es la versión más fuerte que puede existir de «pon las reglas en el repo».
Ese 64 % es una mejora real y no vamos a hacer como si no lo fuera. También es el techo, cuesta lo mismo en tokens, y los cuatro fallos que quedan enseñan más que los aciertos. El archivo resolvió bien las reglas a las que el ticket apuntaba de frente, y perdió en otros dos frentes.
El primero son las piezas accesorias dentro de una regla que por lo demás clavó. Tenía 403 ADJUSTMENT_LIMIT para los ajustes de más o menos 30 unidades escrito verbatim en su archivo: fijó el umbral exacto de 30 y respondió con un 403 en prosa, sin el literal. La dilución no actúa solo a lo largo de un documento, actúa también dentro de una misma regla.
El segundo son las reglas transversales que el ticket no menciona. La que prohíbe escribir directamente sobre las cantidades de stock estaba en su archivo, verbatim, y perdió tres de tres veces contra la costumbre del código que tenía delante.
El código que ya existe es una instrucción implícita más fuerte que cualquier documento: le enseña al agente cómo se hacen las cosas en esta casa, lo tiene a la vista mientras escribe y, encima, compila. Una regla que contradice una costumbre del código solo gana si llega en el mismo instante que la costumbre.
¿Qué dicen los proveedores de seguridad sobre los archivos de reglas?
Las dos cosas a la vez, muchas veces dentro del mismo producto, y casi nunca con una medición al lado.
La versión optimista se defendió pronto y se defendió bien. En junio de 2025, Rami McCarthy publicó en Wiz Rules Files for Safer Vibe Coding y liberó un juego de reglas de seguridad de base para Cursor, Windsurf, Copilot, el AGENTS.md de Codex y el CLAUDE.md de Claude. Su tesis es que los archivos de reglas son el método ideal para centralizar y estandarizar estas mejoras de prompting orientadas a la seguridad, con una advertencia que aparece en el propio artículo: el mejor archivo de reglas de seguridad es el que está hecho a medida de tu organización. Para la clase de regla a la que apunta, la postura genérica de código seguro, no tenemos ninguna evidencia en contra.
La versión escéptica suele hablar de quién puede editar el archivo, no de si el modelo lo sigue. La guía de Kodem sobre cómo asegurar los editores de código con IA, publicada el 31 de octubre de 2025 por Mahesh Babu, sostiene que las funciones de protección de estas herramientas «se desactivan con frecuencia en la práctica», y que eso deja «un entorno donde código no confiable o archivos de reglas envenenados pueden ejecutarse sin ningún escrutinio». Es un problema real, pero es otro problema. Una regla puede fallar porque alguien la desactivó, y puede fallar porque el modelo la diluyó con el archivo perfectamente intacto.
Y luego está el patrón que más dice sin decirlo: el mismo proveedor que publica un archivo de reglas vende un producto de inyección de contexto. Sonar publica un AGENTS.md para su flujo de agente y te pide que lo dejes en la raíz del repositorio como archivo de instrucciones de tu agente; a la vez vende Vortex, que según su propia descripción inyecta el contexto y las restricciones adecuadas del proyecto para que los agentes arranquen con las cosas claras.
Endor Labs, por su parte, lee tu CLAUDE.md como una declaración de intenciones para su escáner: el 7 de septiembre de 2026 escribía que un CLAUDE.md que dice «todas las rutas de API se autentican a través de nuestro middleware SSO» le cuenta al escáner algo que ninguna cantidad de pattern matching sacaría a la luz.
Ninguno ha publicado una tasa de cumplimiento, y Anthropic tampoco, hasta donde hemos podido comprobar. El debate se ha sostenido sobre afirmaciones y sobre hilos de GitHub. Ahora se sostiene sobre un estudio factorial grande acerca de la estructura del archivo y un estudio pequeño acerca del caso difícil. Sigue siendo poca base, pero es bastante más de la que había.
¿Qué merece la pena cambiar y qué no?
Empieza por lo que la evidencia descarta, que es justo donde la mayoría de los equipos gasta el esfuerzo. McMillan puso a prueba, de forma factorial y a escala, las cuatro recomendaciones que repite cualquier guía sobre cómo escribir un buen CLAUDE.md.
| El consejo de siempre | Lo que encontró el estudio factorial |
|---|---|
| Acorta el archivo | Ningún efecto detectable del tamaño, con un factor de Bayes a favor del nulo |
| Pon la regla importante arriba del todo | Ningún efecto detectable de la posición de la instrucción |
| Divídelo en varios archivos, o usa imports | Ningún efecto detectable de la arquitectura del archivo |
| Quita las contradicciones con los archivos vecinos | Ningún efecto detectable de los conflictos, con un factor de Bayes a favor del nulo |
Con dos matices. Anthropic sí recomienda quedarse por debajo de 200 líneas por archivo CLAUDE.md, y lo hace por presupuesto de contexto: adelgazar un archivo hinchado sigue siendo buena higiene. Pero si estás apostando un resultado de cumplimiento a bajar de 300 líneas a 150, el único experimento directo que existe dice que no vas a medir la diferencia.
El segundo matiz es el efecto «lost in the middle», que se cita sin parar para justificar subir las reglas al principio: McMillan comparó una regla en la línea 2 con la misma regla en la línea 250, y no encontró ningún efecto.
Lo que sí tiene respaldo es aquello que ninguno de los dos estudios se propuso medir: la distancia hasta la escritura. Su decaimiento dentro de la sesión y nuestro corte entre regla servida y no servida son el mismo fenómeno mirado desde dos extremos. De las 58 reglas evaluadas que nuestra capa sirvió en el momento de la edición, 55 salieron exactas (95 %). De las 6 que no consiguió servir, 4 no lo fueron. Mismo agente, misma sesión, misma inteligencia, distinta distancia. Así que ordena tus reglas por una sola pregunta: ¿podría el agente adivinarla?
Deja en el archivo lo que al archivo se le da bien: comandos de build, estructura del proyecto, convenciones que cualquier ingeniero competente adoptaría igual, y todo aquello que el agente no produciría nunca por su cuenta. Esa última categoría es la que midió el estudio con potencia estadística, y ahí el archivo funciona.
Lleva tus valores arbitrarios al momento de la edición. Códigos de error, formatos de nombre de archivo, umbrales, la forma exacta de tu línea de auditoría, las columnas que puede llevar una exportación. Son las reglas que peor gestiona un archivo, porque el agente ya tiene una respuesta rival que le parece buena y el archivo se la discute desde treinta mil tokens de distancia. Son también, casualmente, las que llevan detrás a un regulador o a un cliente.
Deja que las reglas se conviertan en estructura. Cuando la regla llegaba en el momento de la edición, el agente construía el mecanismo que esa regla implica: un libro de movimientos, una clave de idempotencia, un evento de auditoría. Las tareas siguientes lo reutilizaban, a veces sin que la regla volviera a servirse. Cuando llegó el ticket del rastro de auditoría, en la tarea 14, el brazo que llevaba todo el experimento emitiendo eventos de auditoría cerró el rastro en 334 líneas; los dos que no habían escrito ninguno lo levantaron desde cero en 1.107 y 1.620. El cumplimiento que se va asentando por el camino costó cinco veces menos código que el cumplimiento recuperado a posteriori.
Y para lo que no puede pasar nunca, deja de escribir prosa. Anthropic no se anda con rodeos: para bloquear una acción decida lo que decida Claude, hay que usar un hook PreToolUse, porque las instrucciones de CLAUDE.md moldean el comportamiento de Claude pero no son una capa de aplicación estricta. Una regla que no te puedes permitir perder es un hook o un permiso, nunca una viñeta. Y revisa el archivo como revisas el código, porque quien pueda hacer commit en él está escribiendo la política de tu agente: ver la inyección por archivo de instrucciones.
¿Cuánto hay que fiarse de estas cifras?
Menos que de las de McMillan, y preferimos decirlo nosotros a que lo deduzcas tú. Hicimos una ejecución por brazo y por tarea, sobre una única base de código y con un único modelo, en 25 tareas que ponían reglas en juego y unas 65 reglas evaluadas por brazo. Él hizo 1.650 sesiones y 16.050 observaciones. Las diferencias grandes (13 % frente a 87 %, 64 % frente a 100 %) son demasiado amplias para ser un accidente de conteo, pero las distribuciones secundarias hay que leerlas con ese tamaño de muestra en la cabeza. No publicamos ningún valor p, y es deliberado.
Además hay un conflicto de interés que conviene poner encima de la mesa.
Escribimos nosotros el corpus, y vendemos una herramienta que entrega reglas en el momento de la edición. Contra ese sesgo pusimos tres salvaguardas: corpus y rúbricas sellados antes de la primera ejecución, una calificación previa de hasta qué punto cada regla se podía adivinar, y los tickets comprobados por máquina para que no filtraran literales. Los auditores ciegos son modelos, no personas. Repetirlo con revisores humanos es el siguiente paso evidente, y no lo hemos dado. El estudio también cuenta dónde perdió nuestro propio brazo.
Van cuatro apuntes más, rápido. Dos casos de exceso de celo, correcciones acertadas aplicadas donde no tocaba. Cuatro reglas que nunca se recuperaron, cada una de una familia a la que el ticket no apuntaba, y que explican cuatro de las siete desviaciones de nuestro brazo. Seis tareas con la entrega degradada por un fallo de autenticación y una caída de canal, contadas en nuestra contra en vez de excluidas. Trece falsos positivos en las guardas sobre comandos.
El suyo es el mejor experimento; el nuestro, el caso más difícil. Él aisló la estructura de forma limpia con un objetivo que no tenía ningún instinto rival; nosotros elegimos objetivos que son puro instinto rival, y renunciamos a potencia estadística para conseguirlo. Juntos dicen algo muy sencillo: lo que falla no es la estructura del archivo, y las reglas en las que el archivo falla son precisamente aquellas por las que lo escribiste.
Lo que vendemos, dicho sin adornos
Nuestro producto es la inyección de reglas en el momento en el que el agente escribe. Este estudio la mide, y el mismo estudio dice lo que no puede hacer. VibeDefend se instala en el entorno del agente, no en tu repositorio. Un hook se dispara antes de cada edición de archivo y pone en el contexto del modelo las reglas que afectan a ese archivo y a esa intención, justo antes de la escritura. En las 30 tareas eso supuso 669 inyecciones de reglas de negocio y 1.078 inyecciones de reglas de seguridad, por algo así como un dólar por ticket.
Lo que no hace es obligar. Si la tarea M24 está en este artículo es porque marca el límite exacto de lo que vendemos. La parte determinista de la capa es la guarda que bloquea la acción, no la regla puesta en el contexto, y preferimos decir cuál de las dos es un control antes que dar a entender que lo son las dos. El modelo completo está en la seguridad de los agentes de código con IA.
Preguntas frecuentes
¿Claude Code hace caso de verdad al CLAUDE.md?
Lee el archivo al principio de cada sesión y lo sigue de forma desigual, y el fallo se concentra en los valores concretos. La documentación de Anthropic dice que Claude los trata como contexto, no como configuración aplicada, y que no hay ninguna garantía de cumplimiento estricto. En nuestro estudio de 90 ejecuciones autónomas, una sección de reglas realista consiguió el mismo número de valores implementados de forma exacta que no tener ningún archivo: 7 de 55. En las 13 reglas cuyo valor correcto aparecía verbatim en el archivo, el agente lo implementó tal cual 4 veces.
¿Cómo se escribe un buen CLAUDE.md?
Ordénalo por lo que el modelo puede adivinar, y deja de retocar la estructura. La única prueba factorial directa, sobre 1.650 sesiones de Claude Code, no encontró efecto detectable del tamaño del archivo, de la posición de la instrucción, del reparto en varios archivos ni de las contradicciones con archivos vecinos, y una instrucción en la línea 2 no rindió mejor que la misma en la línea 250. Deja en el archivo lo que un ingeniero competente aplicaría igual, lleva tus valores arbitrarios al momento de la escritura, y convierte en hook todo lo que no puede pasar nunca.
¿Qué debe contener un CLAUDE.md?
Comandos de build, estructura del proyecto, convenciones de la casa y todo lo que el agente no produciría por su cuenta. Esa última clase es la que midió el estudio mejor dimensionado, y ahí el archivo cumple. Lo que no pinta nada ahí son tus valores arbitrarios, los códigos de error, los formatos de nombre de archivo y los umbrales: en las 13 reglas donde nuestro archivo llevaba el valor exacto por escrito, el agente lo implementó de forma exacta 4 veces.
¿Qué longitud debe tener un CLAUDE.md?
La que te quepa en el presupuesto de contexto, porque no es la longitud lo que decide si una regla se cumple. Anthropic recomienda quedarse por debajo de 200 líneas por archivo, y adelgazar un archivo hinchado es buena higiene. El estudio factorial no encontró ningún efecto detectable del tamaño, con el apoyo de un factor de Bayes a favor del nulo, así que no esperes que acortar el archivo cambie si una regla concreta sobrevive hasta la escritura.
¿Claude Code lee AGENTS.md o solo CLAUDE.md?
Solo CLAUDE.md, salvo que lo conectes tú mismo. La documentación de Anthropic es explícita: Claude Code lee CLAUDE.md, no AGENTS.md, y admite como puente un import @AGENTS.md o un enlace simbólico. Ninguno de los dos es mejor que el otro, porque el mecanismo es idéntico en los dos casos, un documento cargado en contexto al inicio de la sesión, así que el modo de fallo también lo es.
¿Por qué Claude Code no sigue mis reglas?
Casi nunca es que las ignore a propósito: es que se diluyen. El archivo se carga una vez y, para cuando llega la trigésima edición, es un fragmento viejo enterrado bajo decenas de miles de tokens de código, salidas de comandos y razonamiento. El estudio factorial de Damon McMillan mide lo mismo desde el otro lado: cada función adicional que genera el agente se asocia a una caída de alrededor del 5,6 % en las probabilidades de cumplir. La segunda causa es tu propia base de código, que le está enseñando al agente cómo se hacen aquí las cosas y, además, compila.
¿Sirve de algo el CLAUDE.md?
Sí para una clase de regla, no para la clase por la que casi todos lo escriben. McMillan midió una anotación trivial, algo que el agente no tiene motivo para escribir si el archivo no se lo pide, y ahí el archivo lleva el cumplimiento de casi nada a algo. Nosotros tomamos el caso contrario, reglas para las que el agente ya tiene una respuesta rival plausible, y una sección de reglas realista sacó exactamente lo mismo que no tener archivo: 7 valores exactos de 55.
¿Hay que subir el CLAUDE.md al repositorio?
Sí, y luego revisarlo como código, porque quien pueda hacer commit en él está escribiendo la política de tu agente. Pero subirlo no es imponerlo: la sección de reglas de nuestro estudio estaba en el repositorio y se cargaba al inicio de cada sesión, y el código que salió de ahí era indistinguible del que produjo el brazo sin ningún archivo de reglas.
¿Karpathy midió de verdad una caída de errores del 40 % al 11 % con un CLAUDE.md?
No hemos encontrado ninguna fuente primaria de esa cifra. Circula en hilos de redes y en resúmenes de segunda mano, con más de una versión, del 40 % o del 41 % al 11 %, sin método publicado ni tamaño de muestra que se pueda comprobar. Las mediciones que sí tienen un artículo o un protocolo detrás son menos halagüeñas: McMillan no encontró efecto detectable de las cuatro variables de estructura en 1.650 sesiones, y nuestras 90 ejecuciones dejan un archivo de reglas realista empatado con no tener ninguno.
¿Cómo se obliga de verdad a cumplir una regla en Claude Code?
Con prosa, no. Anthropic recomienda un hook PreToolUse para bloquear una acción decida lo que decida Claude, y los ajustes gestionados para los permisos, porque las reglas de configuración las aplica el cliente al margen de lo que decida Claude. Una regla que no te puedes permitir perder va en un hook o en un permiso. Una regla con la que quieres que el agente razone va en su contexto, en el momento en que escribe.


