


In questa pagina
- Quali dati invia Codex a OpenAI?
- OpenAI usa il mio codice per addestrare i modelli?
- Cosa salva Codex sul mio computer?
- Codex «ruba» il tuo codice?
- Come tengo segreti e codice regolamentato lontani da Codex?
- Dove le impostazioni di privacy non arrivano
- Domande frequenti
- Se uso Codex, il mio codice arriva a OpenAI?
- Codex usa i miei dati per l'addestramento?
- Come si disattiva l'addestramento sul mio codice in Codex?
- Codex salva le mie sessioni sul computer?
- Codex può leggere il mio file .env?
- Codex e GDPR: i miei dati possono restare in Europa?
- Codex è sicuro per il codice proprietario dell'azienda?
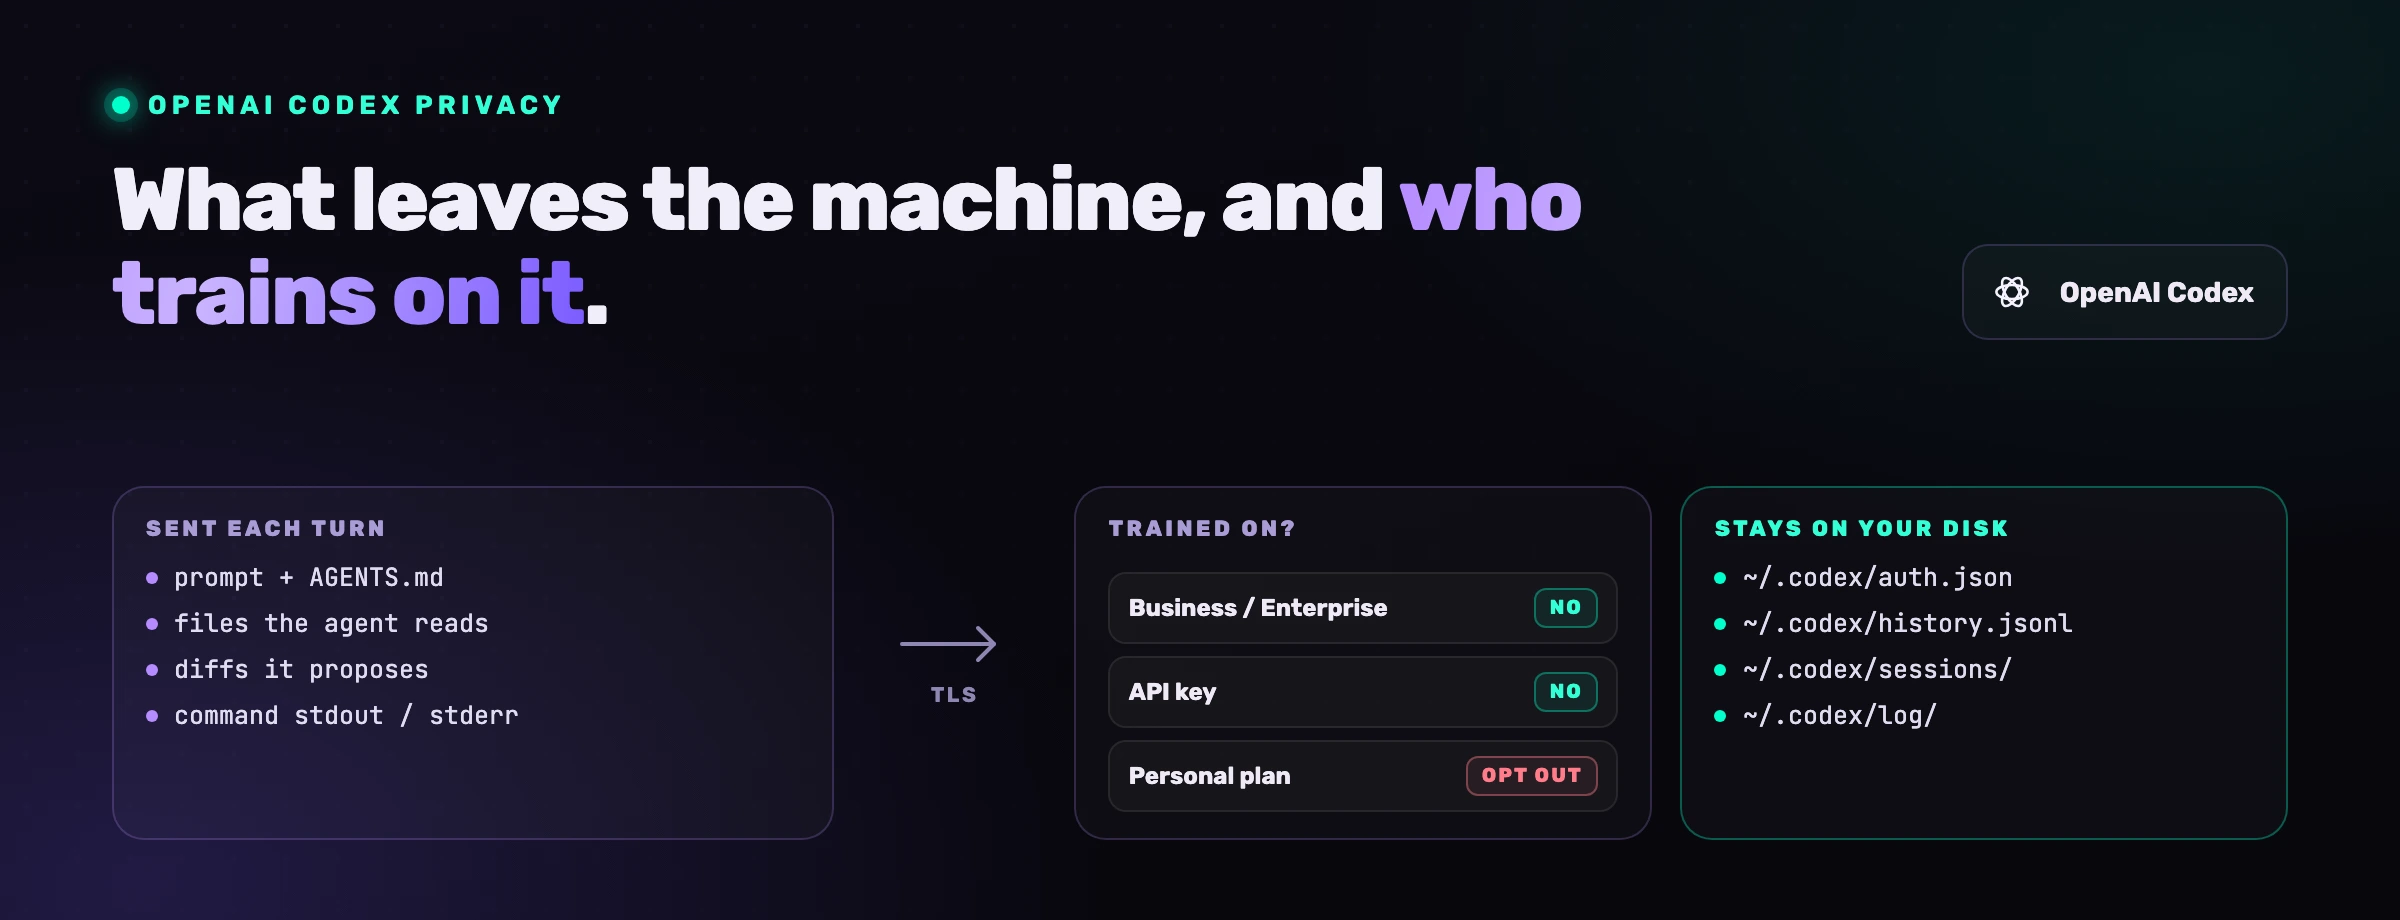
Sì, OpenAI Codex manda il tuo codice a OpenAI, e non potrebbe fare altrimenti: per ragionare su un repository un agente deve vederlo, quindi il prompt, i file che decide di aprire, i diff che propone e l'output dei comandi che lancia arrivano tutti ai modelli di OpenAI. Fermarsi a quel sì, però, serve a poco. Le domande che contano sono più strette: che cosa esce di preciso dalla tua macchina e che cosa resta scritto in ~/.codex, se OpenAI usa quel materiale per l'addestramento (dipende da come hai fatto login), che cosa conserva e per quanto tempo, con quali impostazioni tieni segreti e codice regolamentato lontano dall'agente. Questa guida le prende una per una, ciascuna con l'impostazione che decide la risposta.
Quali dati invia Codex a OpenAI?
Codex invia a OpenAI tutto quello che gli serve per ragionare sul compito, e niente di ciò che non ha mai aperto. Lo mostra OpenAI stessa, nel suo articolo tecnico sul loop dell'agente di Codex: a ogni turno la CLI manda all'API Responses il prompt che hai scritto, i file di istruzioni come AGENTS.md, una breve descrizione dell'ambiente (directory di lavoro e shell) e l'output di tutte le chiamate agli strumenti fatte fin lì. È da quest'ultimo canale che passano il contenuto dei file che l'agente ha scelto di leggere, i diff che propone, lo stdout e lo stderr dei comandi eseguiti e quello che quei comandi mostrano del repository (percorsi, stato di git, struttura). Con Codex cloud cambia la scala: Codex crea un container e ci fa il checkout del tuo repository, sull'infrastruttura di OpenAI, quindi tutto quello che c'è in quel checkout è in gioco.
C'è un lato buono: un file che l'agente non ha mai letto non parte. Per questo la privacy con Codex si gioca sul raggio d'azione dell'agente: che cosa può aprire, e che cosa gli hai detto di non toccare.
| Modalità d'uso | Cosa esce dalla macchina | Dove gira il modello | Quali condizioni valgono |
|---|---|---|---|
| CLI o estensione IDE, con login ChatGPT | Prompt, file letti, diff, output dei comandi, metadati | Da OpenAI, nel tuo workspace ChatGPT | Quelle del tuo piano ChatGPT (personale o Business/Enterprise/Edu) |
| CLI o SDK, con chiave API | Le stesse cose, più la telemetria facoltativa che configuri tu | API di OpenAI | I controlli sui dati dell'API (nessun training di default) |
| Codex cloud | Il task e l'intero repository, scaricato dal tuo server Git dentro il container | Sandbox ospitata da OpenAI | Quelle del tuo piano ChatGPT |
codex exec in locale, dentro la CI | Come la CLI, ma senza nessuno davanti | OpenAI | Quelle della credenziale usata dal runner |
Insieme a tutto questo viaggiano due cose a cui quasi nessuno pensa. La prima sono le variabili d'ambiente: la shell in cui l'agente lancia i comandi le vede, quindi un DATABASE_URL o un AWS_SECRET_ACCESS_KEY esportato lì può comparire nell'output di un comando e partire insieme a quello. A decidere quali variabili arrivano a quella shell è la shell_environment_policy di Codex, che però non toglie nulla finché non glielo chiedi: secondo il riferimento di configurazione di OpenAI, le variabili con KEY, SECRET o TOKEN nel nome di default vengono mantenute. La seconda sono le ricerche web: con web_search impostato su live (il flag --search) escono anche le query che il modello compone, mentre la modalità predefinita, cached, si appoggia a un indice mantenuto da OpenAI e non tocca il web esterno. Lo stesso riferimento avverte però che con --yolo, o con un'altra impostazione di sandbox ad accesso completo, quel default diventa live.
OpenAI usa il mio codice per addestrare i modelli?
Dipende da come hai fatto login, non da quale versione di Codex usi. CLI, estensione o cloud, la policy di OpenAI sull'uso dei dati tratta Codex come il resto dei suoi prodotti, con i servizi per i privati da una parte e quelli per le aziende dall'altra; di specifico, Codex ci aggiunge un solo interruttore.
| Come accedi a Codex | Training attivo in partenza? | Come si cambia |
|---|---|---|
| Workspace ChatGPT Business, Enterprise o Edu | No, secondo la pagina di OpenAI sulla privacy per le aziende | Controlli dell'amministratore del workspace; solo opt-in |
| Chiave API (Codex CLI o SDK) | No. I controlli sui dati dell'API di OpenAI lo dichiarano così: «dal 1° marzo 2023 i dati inviati all'API di OpenAI non vengono usati per addestrare o migliorare i modelli di OpenAI (a meno che tu non scelga esplicitamente di condividere i dati con noi)» | Solo opt-in |
| Piano personale (Free, Go, Plus, Pro) | Può esserlo, finché non lo disattivi | Impostazioni di ChatGPT, Controlli dei dati, «Migliora il modello per tutti»; in alternativa, il portale privacy di OpenAI. Basta una delle due strade |
| Ambienti completi di Codex (piani personali) | Controllo separato | Impostazioni di Codex, interruttore del training sugli ambienti completi |
È sull'ultima riga che si inciampa. Le FAQ di OpenAI sui controlli dei dati dicono due cose: che con un piano personale l'impostazione «Migliora il modello per tutti» vale anche per i tuoi task in Codex, e che Codex ha un'impostazione a parte per il training sugli ambienti completi, gestita nelle sue impostazioni. Toccare l'impostazione di ChatGPT o passare dal portale privacy non la sposta di un millimetro. Nessuna delle due pagine dice quale sia il valore predefinito di quell'impostazione di Codex. In pratica: se hai un piano Plus e anni fa hai spento «Migliora il modello per tutti», niente ti autorizza a pensare che Codex si sia adeguato. Controllali tutti e due.
C'è un'eccezione che sopravvive all'opt-out, e la policy sull'uso dei dati citata sopra la mette nero su bianco: se mandi un feedback su una risposta, un pollice su o giù per esempio, l'intera conversazione collegata può essere usata per il training.
Cosa salva Codex sul mio computer?
Codex salva sul tuo disco, nella cartella ~/.codex, più di quanto ci si aspetti: impostazioni, credenziali, log e, di default, le trascrizioni delle sessioni. La guida di OpenAI alla configurazione avanzata elenca i file, che conviene conoscere per nome:
config.toml, le tue impostazioni;auth.json, le credenziali in cache, quando è in uso lo store su file (altrimenti finiscono nel portachiavi di sistema);history.jsonl, quelle che la guida chiama trascrizioni delle sessioni, attive se non le spegni tu;log/, i log.
Accanto c'è sessions/, dove Codex conserva ogni conversazione in un file che può riprodurre e riprendere.
Per la privacy pesano history.jsonl e sessions/. Fra tutti e due contengono i tuoi prompt, le risposte dell'agente e l'output dei suoi comandi, compreso qualunque pezzo di codice o segreto ci sia passato in mezzo, e restano sul disco finché non li cancelli. A decidere che cosa rimane in locale e che cosa viene esportato sono poche chiavi di config.toml:
# Niente trascrizioni delle sessioni in ~/.codex/history.jsonl
[history]
persistence = "none"

# Nessun export OpenTelemetry dei log, e mai il testo dei prompt
[otel]
exporter = "none"
log_user_prompt = false

# Via le credenziali dalla shell usata dall'agente
[shell_environment_policy]
ignore_default_excludes = false  # toglie anche i nomi che contengono KEY, SECRET o TOKEN

[shell_environment_policy.filters]
"AWS_*" = "exclude"
"DATABASE_URL" = "exclude"

# Analytics a livello di macchina
[analytics]
enabled = false
Tre precisazioni, prese dalla documentazione di OpenAI, vanno lette insieme a questo blocco. history.persistence = "none" ferma history.jsonl e nient'altro: i file in sessions/ sono un meccanismo a parte, il riferimento di configurazione non documenta alcuna chiave per loro, e l'unico modo documentato per evitarli è codex exec --ephemeral, che gira senza scriverli. La tabella filters è la forma attuale di shell_environment_policy; il vecchio array exclude funziona ancora, ma il riferimento ormai lo segna come legacy, e Codex rifiuta un misto dei due. Infine l'export OpenTelemetry dei log è disattivato di default: finché non lo configuri tu, non viene esportato nulla, e otel.log_user_prompt è un opt-in esplicito, che serve a includere in quell'export il testo integrale dei prompt.
Restano due canali, entrambi attivi per impostazione predefinita: le metriche anonime di utilizzo e di stato, che secondo OpenAI non contengono dati in grado di identificarti e che si spengono con analytics.enabled = false, e il comando /feedback (feedback.enabled). Nessuna di queste chiavi, però, cambia ciò che riceve il modello: cambiano quello che la tua macchina scrive su disco e quello che inoltra.
Codex «ruba» il tuo codice?
No, e la domanda merita una risposta precisa più che rassicurante. Codex trasmette il tuo codice a OpenAI alle condizioni del piano con cui hai fatto login, e quelle condizioni sono pubbliche: è un flusso di dati che hai accettato, non un furto.
Se la domanda gira tanto sui motori di ricerca è per due incidenti, e in nessuno dei due era Codex a portarsi via il codice. Il primo riguarda codexui-android, un'interfaccia web remota per Codex pubblicata su npm, funzionante per davvero, in sviluppo attivo e con qualche migliaio di download a settimana. Come ha raccontato The Hacker News il 1° giugno 2026, le versioni pubblicate da un mese circa leggevano ~/.codex/auth.json a ogni avvio e lo spedivano al server di un attaccante, con codice che nel repository GitHub non è mai comparso. Nel secondo, una falla di command injection nell'ambiente cloud di Codex, scoperta da BeyondTrust Phantom Labs e riportata da The Hacker News a marzo 2026, permetteva di rubare con un nome di branch costruito ad arte il token GitHub usato da Codex, e BeyondTrust indica fra le superfici coinvolte il sito di ChatGPT, la CLI di Codex, l'SDK e l'estensione IDE; OpenAI l'ha poi corretta. Il copione è identico: nel mirino c'erano le credenziali intorno a Codex, e a rubare era un terzo.
È lì che va messa l'attenzione. La guida di OpenAI all'autenticazione chiede di trattare ~/.codex/auth.json come una password, e con cli_auth_credentials_store = "keyring" i token finiscono nel portachiavi di sistema, così il file non è più lì da leggere. Verifica quello che installi, sapendo che un repository pulito non dimostra nulla sul pacchetto che il registry serve davvero, e davanti a qualunque componente aggiuntivo per Codex usa la stessa diffidenza che avresti per un'estensione del browser che ti chiede la password.
C'è poi una terza strada per perdere codice, l'unica per cui nessuno compila un report di incidente: una prompt injection nascosta in un repository che hai clonato, che ordina all'agente di spedire i tuoi file altrove con un curl, in una sessione in cui la rete era aperta. È proprio per questo che la sandbox workspace-write di Codex, di default, tiene la rete chiusa, e la guida di OpenAI a sandbox e approvazioni lo dice senza giri di parole: di default l'agente gira con l'accesso alla rete disattivato. Quali flag la aprono, e quando ha senso farlo, lo spiega la nostra guida ai flag di sandbox e approvazione di Codex.
Come tengo segreti e codice regolamentato lontani da Codex?
Restringi quello che l'agente può aprire, e fai in modo che lì dentro non trovi nulla di interessante. In ordine di impatto:
- Niente segreti nei file che l'agente può leggere. Un
.envcon chiavi vere, unconfig/production.ymlcon la password del database, uncredentials.jsondimenticato nell'albero del progetto: se sta nel workspace l'agente può leggerlo, e da lì a una trascrizione il passo è breve. Usa un secrets manager e inietta i valori a runtime. - Ripulisci la shell. Una
shell_environment_policyconignore_default_excludes = falsee vocifiltersimpostate suexcludeper chiavi, token e stringhe di connessione, e l'output dei comandi non ha più niente da far trapelare. - Tieni chiusa la rete. Lascia
sandbox_workspace_write.network_accessafalse. Quando un task ha davvero bisogno del registry, aprila solo per quell'esecuzione con-c. - Dichiara non fidati i repository che non conosci. Con
projects."<path>".trust_level = "untrusted", il riferimento di configurazione di OpenAI indica che Codex salta i livelli.codex/che il repository si porta dietro, configurazione locale, hook e regole compresi, e un progetto appena clonato non può riconfigurare l'agente contro di te. - Sulle macchine condivise o soggette a vincoli normativi, spegni le trascrizioni locali.
history.persistence = "none", più una pulizia programmata di~/.codex/sessions/, che quella chiave non copre. In CI, usacodex exec --ephemeral. - Scegli l'accesso in base ai dati. Codice sotto NDA, codebase regolamentata, fixture con dentro dati di clienti: qui servono un workspace Business o Enterprise, oppure una chiave API. Per chi usa l'API con obblighi più stringenti, i controlli sui dati dell'API di OpenAI documentano tre cose. I log di monitoraggio degli abusi sono conservati di default «fino a 30 giorni», di più se lo impone la legge. L'opzione Zero Data Retention tiene i contenuti del cliente fuori da quei log sugli endpoint idonei,
/v1/responsescompreso, e OpenAI la concede previa approvazione, non su semplice richiesta. Anche la residenza dei dati è soggetta a idoneità: la regione Europa (SEE e Svizzera) richiede Zero Data Retention o un altro dei controlli di conservazione ridotta di OpenAI, e non copre i dati di sistema, come i metadati di account e di utilizzo. Se devi documentare il trattamento ai fini del GDPR, sono i tre punti da cui partire. - Fai passare uno scanner di segreti prima dell'agente. Una chiave committata che lo scanner ti segnala oggi è una chiave che la prossima sessione non si caricherà nel contesto.
Dove le impostazioni di privacy non arrivano
Tutti i controlli visti finora decidono che cosa Codex legge e trasmette. Su che cosa scrive non interviene nessuno, eppure il codice che produce è a sua volta una superficie di rischio per la privacy. Pensa a un agente che incolla nel codice un token visto in una fixture, che mette a log il corpo intero di una richiesta con dentro un numero di carta, o che restituisce una scheda utente con campi che chi chiama non era autorizzato a vedere. Ha appena creato un problema di protezione dei dati che nessuna policy di conservazione potrà sistemare, perché la fuga ormai sta nel tuo repository e nei tuoi log di produzione.
È questo il livello che VibeDefend aggiunge in agent-time. Lavora dentro il loop di Codex e confronta con le tue regole il diff che l'agente sta per scrivere: il segreto finito nel codice, la riga di log che dice troppo, il controllo di autorizzazione che manca vengono riscritti prima di arrivare nel repository. La sua guardia decide in locale, sul tuo computer, la telemetria è fatta di soli metadati strutturati, e l'analisi gira su modelli self-hosted, nella regione UE o US che scegli all'installazione, senza API LLM di terze parti e senza che il tuo codice venga usato per addestrare un modello. Nel nostro studio controllato, l'agente con questo livello ha applicato la regola esatta nell'89% dei casi (57 regole valutate su 64), contro il 12% senza alcuno strumento e il 13% con un file di regole tenuto a mano nel repository.
Per il quadro d'insieme, con i rischi di sandbox, supply chain e autonomia, c'è la guida completa alla sicurezza di OpenAI Codex. E se il tuo team sta portando Codex su codice che dall'azienda non può uscire, parliamone: è una configurazione che abbiamo fatto molte volte.
Domande frequenti
Se uso Codex, il mio codice arriva a OpenAI?
Sì. A ogni turno partono verso i modelli di OpenAI il prompt, i file che l'agente legge, i diff che propone, l'output dei comandi e i metadati del repository; con Codex cloud l'intero repository viene scaricato in un container ospitato da OpenAI. Un file che l'agente non apre non viene mai inviato: per questo, in fatto di privacy, la leva principale è limitare ciò che può raggiungere.
Codex usa i miei dati per l'addestramento?
Di default no, se lo usi da un workspace ChatGPT Business, Enterprise o Edu, oppure con una chiave API. Con un piano personale può usarli, finché non lo disattivi: vale per Codex la tua impostazione di ChatGPT «Migliora il modello per tutti», e in più Codex ha nelle proprie impostazioni un interruttore separato per il training sugli ambienti completi. Vanno controllati tutti e due.
Come si disattiva l'addestramento sul mio codice in Codex?
Con un piano personale i passaggi sono due. Prima disattivi «Migliora il modello per tutti» nei Controlli dei dati di ChatGPT (o passi dal portale privacy di OpenAI); poi apri le impostazioni di Codex e spegni il controllo del training sugli ambienti completi, perché il primo passaggio non tocca il secondo. L'alternativa è cambiare login: con un workspace Business o Enterprise, o con una chiave API, il training è disattivato in partenza.
Codex salva le mie sessioni sul computer?
Sì, se non cambi nulla: le trascrizioni finiscono in ~/.codex/history.jsonl, accanto alle credenziali in ~/.codex/auth.json (a meno che tu non usi il portachiavi di sistema), a un file riproducibile per ogni sessione in ~/.codex/sessions/ e ai log in ~/.codex/log/. Impostare history.persistence = "none" in config.toml ferma soltanto history.jsonl: i file di sessione vogliono una pulizia a parte, oppure codex exec --ephemeral per le esecuzioni da script.
Codex può leggere il mio file .env?
Sì, se il file sta nel workspace e la modalità di sandbox consente la lettura. E la consentono sia read-only sia workspace-write: a essere confinate sono solo le scritture. Tieni i segreti veri fuori dall'albero del progetto, e con shell_environment_policy toglili anche dalla shell in cui l'agente lancia i comandi.
Codex e GDPR: i miei dati possono restare in Europa?
Per l'uso via API, OpenAI documenta regioni di residenza dei dati che includono l'Europa (SEE e Svizzera), un'opzione Zero Data Retention sugli endpoint idonei e una conservazione predefinita fino a 30 giorni per i log di monitoraggio degli abusi. Entrambe le opzioni dipendono dall'idoneità e dall'approvazione di OpenAI, la regione Europa richiede un controllo di conservazione ridotta come Zero Data Retention, e la residenza non copre i dati di sistema. Per un workspace ChatGPT, dove vengano elaborati i dati dipende dal contratto del workspace: se il carico di lavoro è regolamentato, fattelo confermare da OpenAI. Sono gli elementi da portare in una valutazione GDPR; nessuna impostazione, da sola, equivale alla conformità.
Codex è sicuro per il codice proprietario dell'azienda?
Può esserlo, a patto di scegliere l'identità e la configurazione giuste: un accesso senza training (Business, Enterprise o chiave API), i segreti fuori dal workspace, la rete lasciata chiusa, i repository sconosciuti dichiarati non fidati, le trascrizioni locali disattivate dove la macchina è condivisa. Resta scoperto il codice che l'agente scrive, e per quello serve un livello di revisione dedicato.


