

In questa pagina
- Cosa fa davvero danger-full-access in Codex?
- Cosa rimuove --dangerously-bypass-approvals-and-sandbox?
- -a never, --full-auto e "modalità unsafe" sono la stessa cosa?
- Cos'è la modalità "Approve for me" di Codex?
- L'accesso completo di Codex è sicuro?
- Come funziona la sandbox di Codex su macOS, Linux e Windows?
- Quando l'accesso completo è la scelta giusta?
- Cosa usare al posto di --yolo?
- La falla che nessun flag chiude
- Domande frequenti
- danger-full-access e --yolo sono la stessa cosa?
- Cosa fa esattamente codex --yolo?
- -a never è pericoloso da solo?
- Cos'è la "modalità unsafe" di Codex?
- A cosa serve --dangerously-bypass-hook-trust?
- Come lascio che Codex usi la rete senza accesso completo?
- La sandbox di Codex funziona su Windows?
- La sandbox ferma la prompt injection?
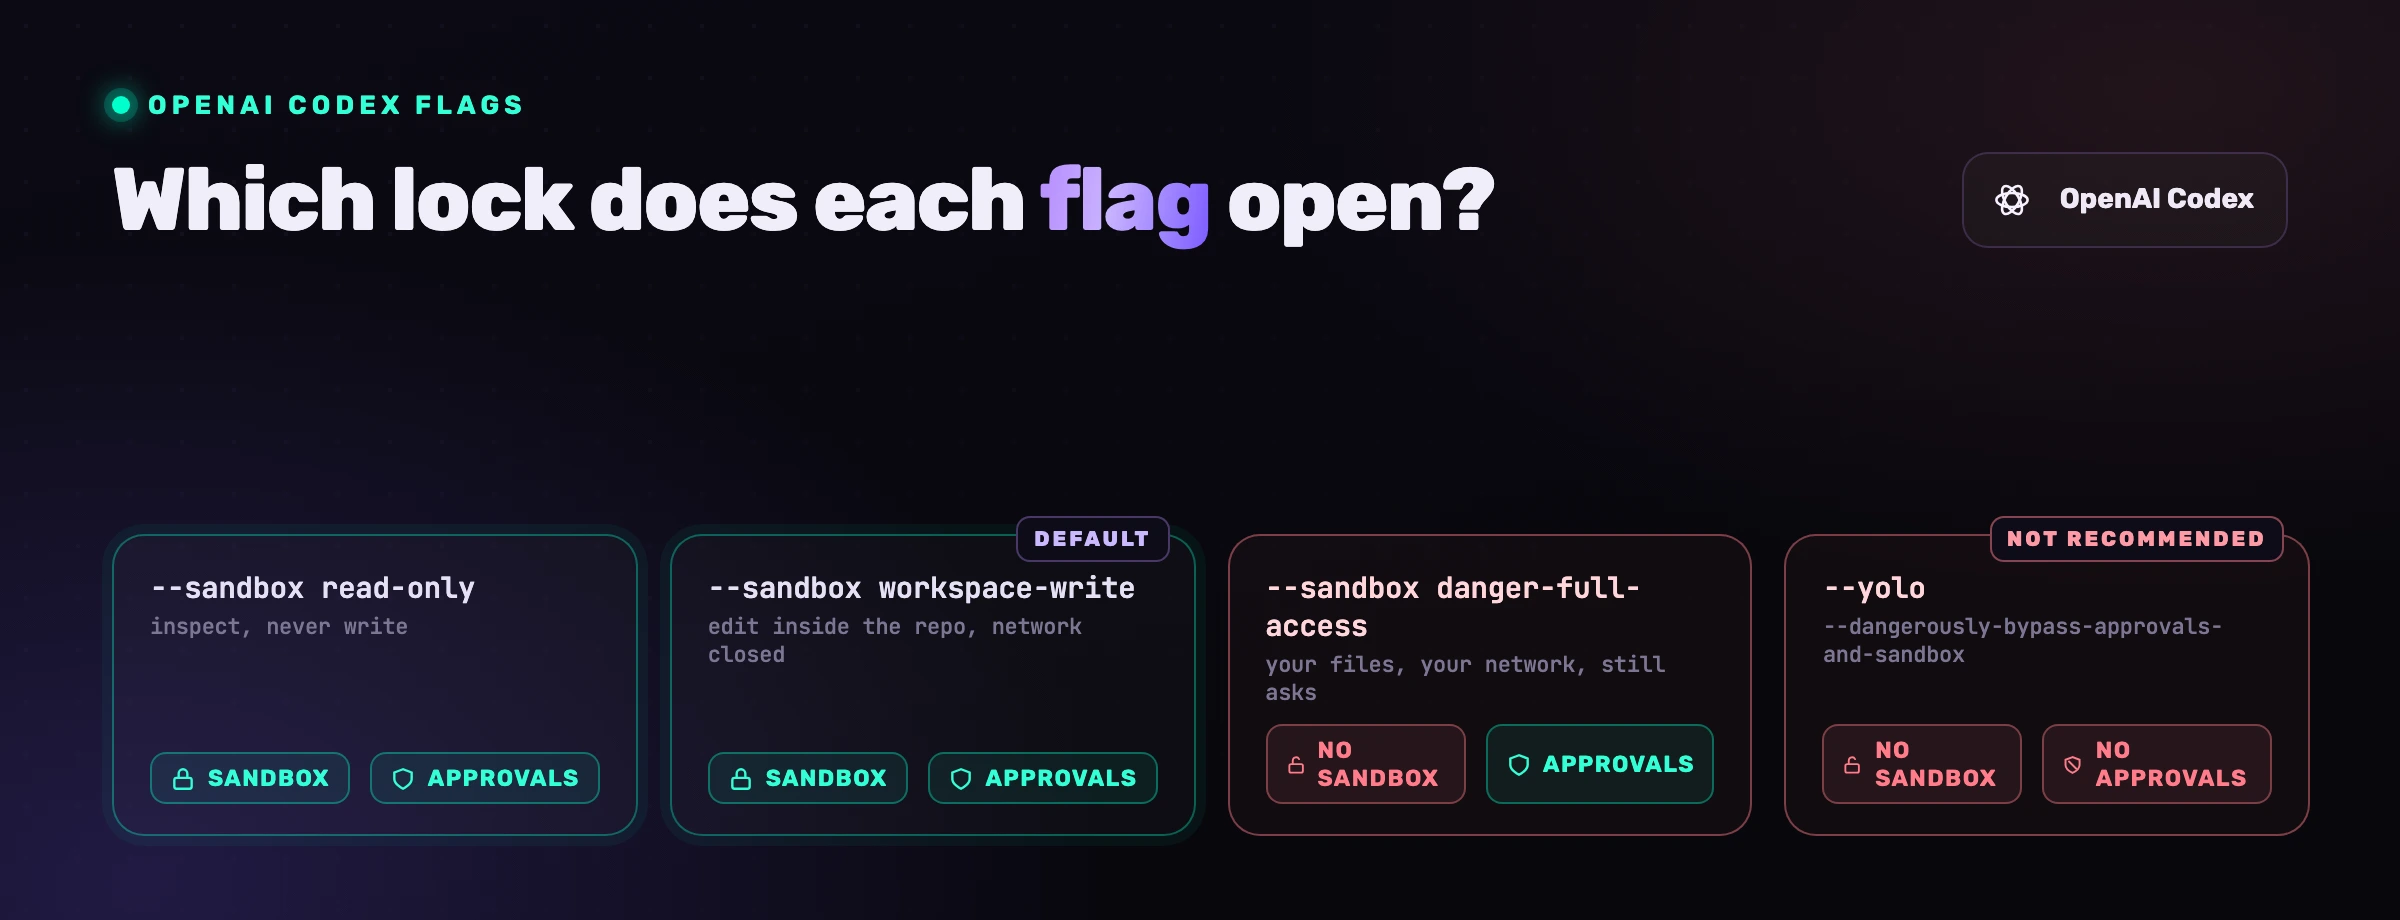
danger-full-access, --dangerously-bypass-approvals-and-sandbox, --yolo, -a never e "Approve for me": OpenAI Codex ha diversi modi per allentare le proprie protezioni, e i loro nomi non sono intercambiabili. --full-auto, che molte guide citano ancora, è stato rimosso con la versione 0.147.0. Alcuni tolgono la sandbox del sistema operativo, altri tolgono le richieste di approvazione, uno toglie entrambe. Questa guida spiega con precisione cosa disattiva ogni flag, come la sandbox viene applicata su macOS, Linux e Windows, quando l'accesso completo è una scelta ragionevole, e la configurazione che ti dà un agente veloce senza consegnargli la tua macchina.
Cosa fa davvero danger-full-access in Codex?
danger-full-access è uno dei tre valori del flag --sandbox di Codex, e spegne la sandbox del tutto. La documentazione di sandboxing di OpenAI lo descrive in una frase: l'agente gira senza restrizioni di sandbox, il che rimuove i confini su filesystem e rete. Ogni comando di shell generato dal modello gira quindi come il tuo utente, con i tuoi permessi, sul tuo filesystem reale, con la tua rete reale.
Gli altri due valori sono quelli che contano nel lavoro quotidiano:
Valore di --sandbox | Lettura file | Scrittura file | Rete | Applicato da |
|---|---|---|---|---|
read-only | Sì | No | No | Sandbox del SO |
workspace-write (predefinito) | Sì | Il workspace, /tmp e $TMPDIR | Chiusa salvo attivazione | Sandbox del SO |
danger-full-access | Tutto ciò che il tuo utente può leggere | Tutto ciò che il tuo utente può scrivere | Senza limiti | Niente |
Due dettagli di workspace-write vanno conosciuti prima di giudicarlo troppo restrittivo. Primo, l'insieme scrivibile non è solo la directory corrente: /tmp e $TMPDIR sono scrivibili per impostazione predefinita, e puoi aggiungere percorsi con sandbox in config.toml (la reference di configurazione espone anche exclude_slash_tmp ed exclude se vuoi escluderli). Secondo, l'accesso alla rete ha un interruttore proprio, sandbox, quindi "mi serve che npm install funzioni" è un argomento a favore di un booleano, non dell'accesso completo.
Dentro ogni radice scrivibile alcune cartelle restano in sola lettura: .git, .agents, .codex e, da Codex 0.159.0 (29 settembre 2026), anche .aws. La pull request della modifica spiega perché: un profilo AWS può indicare un credential helper che l'applicazione esegue, quindi un agente in grado di modificare .aws/config potrebbe lasciarci un comando pronto per la prossima chiamata ad AWS. La protezione blocca la scrittura, non la lettura.
Ciò che danger-full-access non fa è zittire Codex. Le richieste di approvazione dipendono da un flag separato, ed è lì che nasce quasi tutta la confusione della sezione successiva.
Cosa rimuove --dangerously-bypass-approvals-and-sandbox?
--dangerously-bypass-approvals-and-sandbox, con alias --yolo, rimuove entrambe le protezioni in un colpo solo: la sandbox del SO e le richieste di approvazione. La reference della CLI di OpenAI lo descrive così: eseguire ogni comando senza approvazioni né sandbox, da usare solo dentro un ambiente irrobustito dall'esterno. Quella seconda frase è tutta la policy. Il flag esiste per un container o una macchina virtuale che siano essi stessi il confine, non per un portatile con le tue chiavi SSH, le tue credenziali cloud e il .env di produzione.
La differenza tra i due meccanismi diventa semplice quando li metti fianco a fianco:
- La sandbox decide cosa un comando può toccare: quali percorsi sono scrivibili, se può aprire socket. La applica il sistema operativo, quindi un comando che il modello non intendeva eseguire viene contenuto esattamente come uno voluto.
- Le approvazioni decidono quando Codex si ferma per chiederti conferma. Sono un punto di controllo umano, e funzionano solo se un umano le legge.
danger-full-access da solo ti lascia ancora il punto di controllo. --yolo non ti lascia nulla se non il giudizio del modello, e il giudizio del modello è esattamente ciò che una prompt injection nascosta in un README, in una fixture di test o nel messaggio di errore di una dipendenza è progettata per piegare. Non è teoria: la nostra guida sulle evasioni dalla sandbox degli agenti di coding mostra come il contenuto di un repository diventa comandi, e lo schema si applica a Codex senza modifiche.
-a never, --full-auto e "modalità unsafe" sono la stessa cosa?
No. Allentano livelli diversi, uno dei tre non è nemmeno un flag e --full-auto non esiste più. Ecco la mappa completa, flag nuovi compresi:
| Cosa scrive la gente | Cosa è davvero | Sandbox | Approvazioni |
|---|---|---|---|
--sandbox danger-full-access, "full access" | Una modalità di sandbox | Spenta | Invariate |
--ask-for-approval never, -a never | Una policy di approvazione | Invariata | Spente |
--dangerously-bypass-approvals-and-sandbox, --yolo | Un flag di bypass | Spenta | Spente |
--approve-for-me, "Approve for me" | Un'impostazione del revisore (auto-review) | workspace-write | Gestite da un agente revisore |
--dangerously-bypass-hook-trust | Salta la revisione degli hook nuovi o modificati, per una sola esecuzione | Invariata | Invariate |
--full-auto | Rimosso nella 0.147.0; usa --sandbox workspace-write | Attiva | Comportamento ereditato |
| "modalità unsafe", "modalità pericolosa", "run dangerously" | Non è un flag di Codex | Dipende da cosa si intendeva | Dipende da cosa si intendeva |
--ask-for-approval ora accetta solo due valori: on-request (il predefinito: il modello chiede quando vuole escalare, raggiungere la rete o uscire dal workspace) e never. untrusted è stato ritirato in Codex 0.149.0 (20 agosto 2026), e una configurazione che lo usa ancora può impedire a Codex di avviarsi. Le versioni più vecchie accettavano anche on-failure, che eseguiva tutto nella sandbox e chiedeva solo quando un comando lì falliva; --full-auto era la scorciatoia per quella combinazione. Deprecato nella 0.128.0, è sparito con la 0.147.0 (7 agosto 2026).
Il preset "Full access" che vedi nel selettore interattivo è la combinazione di danger-full-access e never, e OpenAI lo etichetta "not recommended" nella sua stessa documentazione sulle approvazioni. È --yolo con un nome più gentile.
Cos'è la modalità "Approve for me" di Codex?
"Approve for me" è la modalità di permessi di Codex in cui a rispondere alle richieste di approvazione è un agente revisore, non tu, mentre la sandbox workspace-write e la policy on-request restano al loro posto. La guida di OpenAI sul sandboxing la riassume così: la stessa sandbox workspace-write di "Ask for approval", ma le richieste idonee passano da una revisione automatica invece di comparire per un'approvazione manuale. La scegli nel menu dei permessi sotto la casella di testo, con /permissions nella CLI oppure all'avvio con --approve-for-me, un flag arrivato con Codex 0.147.0 (7 agosto 2026). In config.toml si scrive approvals; il valore predefinito, user, sei tu.
Non è un'altra policy di approvazione: approval_policy decide quando Codex si ferma, il revisore decide chi risponde. La pagina di OpenAI sull'auto-review la definisce "a reviewer swap, not a permission grant", un cambio di revisore e non un permesso in più: radici scrivibili, accesso alla rete e percorsi protetti non si spostano, e ciò che la sandbox già consente non viene mai revisionato. Serve inoltre che ci siano richieste: con -a never non resta nulla da revisionare, e con danger-full-access o --yolo un'azione può partire senza mai generare la richiesta che il revisore legge. OpenAI avverte che l'auto-review non è una garanzia di sicurezza deterministica; in compenso, tre rifiuti di fila interrompono il turno.
L'accesso completo di Codex è sicuro?
L'accesso completo di Codex è sicuro esattamente finché lo è l'ambiente che lo circonda, e insicuro nel momento in cui smette di esserlo. Dentro un container appena creato, senza credenziali, con un clone usa e getta e una regola di uscita di rete, danger-full-access è uno scambio ragionevole: il container è la sandbox, e quella di Codex lo rallenterebbe soltanto. Su una postazione di sviluppo significa che un modello con la tua identità può fare curl ovunque, scrivere ovunque e leggere ogni token della tua home, e l'unica cosa tra un'istruzione ostile e quel risultato è la decisione del modello di non obbedire.
I dati che abbiamo sugli agenti senza guardia non rassicurano. Nel nostro studio precedente, in cui gli agenti costruivano una piattaforma da zero su un database applicativo attivo, due bracci senza guardia hanno eseguito DROP SCHEMA su quel database sette e undici volte, diciotto in tutto, e uno dei due ha lanciato rm -rf su un percorso assoluto fuori dal proprio progetto. Il braccio con la guardia ha tentato la stessa cancellazione di schema una sola volta, e gli è stata rifiutata. Nel nostro studio controllato del 24 agosto 2026, il guardiano dei comandi ha verificato 1.769 comandi di shell e ne ha rifiutati diciassette. La scomposizione conta più del totale: una cattura vera, un agente che stava per leggere una credenziale salvata; tre applicazioni corrette della policy, su comandi che lì comportavano poco rischio; e tredici falsi positivi, ciascuno dei quali è costato un turno all'agente. Un guardiano che cerca pattern nel testo di un comando è un filo d'inciampo, non un confine. Sa rifiutare il comando che conta, e scatta anche su comandi innocui. Ecco perché la sandbox conta: il sistema operativo confina un comando senza dover indovinare che cosa significa.
esecuzioni di DROP SCHEMA contro un database attivo da parte di agenti senza guardia, nel nostro studio precedente
comandi di shell verificati dal guardiano nel nostro studio controllato del 24 agosto 2026
comandi rifiutati: 1 cattura vera, 3 applicazioni corrette della policy, 13 falsi positivi
Nota da cosa l'accesso completo non ti protegge nemmeno con un ambiente pulito: il codice. Una sandbox contiene comandi; non ha alcuna opinione sulla correttezza del controllo di autorizzazione che il modello ha appena scritto. Ci torniamo alla fine.
Come funziona la sandbox di Codex su macOS, Linux e Windows?
Codex applica la sandbox con il sistema operativo, non con il modello, ed è per questo che regge anche quando il modello viene manipolato. Su macOS usa il framework Seatbelt di Apple, lo stesso meccanismo di policy sandbox-exec che confina i demoni di sistema, e funziona senza installare nulla. Su Linux e sotto WSL2 usa bubblewrap (bwrap) con filtri seccomp; le versioni precedenti usavano direttamente Landlock e seccomp. Su Windows usa una sandbox nativa di Windows, con o senza elevazione, quando viene lanciato da PowerShell, e il meccanismo Linux quando gira sotto WSL2.
Ne derivano due conseguenze pratiche. Se bwrap manca su una macchina Linux, Codex non può costruirvi la sandbox: installalo prima di dare per scontato di essere protetto. E se un comando viene rifiutato senza che tu capisca perché, codex sandbox esegue un comando sotto la policy corrente a scopo di debug, con --log-denials su macOS per stampare cosa ha bloccato Seatbelt. È lo strumento giusto per "Codex non può scrivere qui", e una risposta molto migliore che ricorrere a danger-full-access.
Seatbelt chiude anche una domanda che vediamo spesso nelle ricerche: "Codex seatbelt" non è una funzione da attivare. È ciò di cui read-only e workspace-write sono fatti su un Mac.
Quando l'accesso completo è la scelta giusta?
L'accesso completo è la scelta giusta quando qualcos'altro è già il confine. Lo schema che funziona:
Tre verifiche prima di attivare il flag:
- Cosa può leggere il processo? Se
~/.ssh,~/.aws,~/.codex/auth.jsono un.envcon chiavi attive sono raggiungibili, la risposta non è l'accesso completo. Il file di credenziali di Codex è già stato bersaglio di un pacchetto npm malevolo; non rendergli le cose più facili. - Dove può inviare dati? Rete senza limiti più prompt injection è un canale di esfiltrazione. Se non puoi limitare l'uscita, lascia
network_accesschiuso e lascia che Codex chieda. - Chi legge l'output? Nelle pipeline
codex execnessuno guarda comunque le approvazioni, il che è un motivo per appoggiarsi di più alla sandbox, non per toglierla.
Se una delle tre fallisce, usa invece la configurazione qui sotto.
Cosa usare al posto di --yolo?
Per quasi ogni attività, workspace-write con approvazioni on-request, la rete chiusa e il progetto marcato come fidato ti dà un agente veloce che continua a non poter uscire dalla sua corsia. In ~:
sandbox_mode = "workspace-write"
approval_policy = "on-request"

[sandbox_workspace_write]
network_access = false
writable_roots = ["/Users/tu/scratch"]

[projects."/Users/tu/work/payments-api"]
trust_level = "trusted"
trust dice a Codex di applicare la configurazione .codex/ propria del progetto; i progetti non fidati saltano quei livelli locali, che è esattamente ciò che vuoi per un repository appena clonato da uno sconosciuto. Se il fastidio sono le richieste, restringi ciò che le attiva invece di spegnerle: le build recenti espongono una approval_policy granulare e un'opzione approvals che instrada le approvazioni verso un revisore automatico. Tratta l'auto-review come una comodità, non come un confine: è un modello che giudica un altro modello.
Per la CI e codex exec, tieni la sandbox e togli solo le richieste: --sandbox workspace-write -a never su un runner senza credenziali di produzione è una postura coerente. --yolo sullo stesso runner non lo è, perché la sandbox non ti costava nulla.
La falla che nessun flag chiude
Ogni flag di questo articolo governa ciò che Codex può eseguire. Nessuno governa ciò che Codex scrive, ed è nel codice che vive ormai la maggior parte del rischio. Una sandbox workspace-write lascerà tranquillamente che l'agente committi un endpoint senza controllo di autorizzazione, un gestore di rimborsi senza tetto o una query costruita concatenando stringhe, perché nessuno di questi è un comando. Sono diff.
È questo il livello che VibeDefend aggiunge in agent-time. Si colloca nel loop di Codex, confronta il diff che l'agente sta per scrivere con le tue regole, riscrive la versione insicura prima che atterri, e sorveglia i comandi di shell con la stessa policy che ha prodotto i diciassette rifiuti qui sopra, falsi positivi compresi. Nel nostro studio controllato del 24 agosto 2026, il braccio con il livello ha implementato alla lettera 57 dettagli di regola valutati su 64 (89 %), contro 7 su 55 (13 %) con un file di regole mantenuto a mano nel repository e 8 su 65 (12 %) senza niente. La sandbox tiene Codex lontano dalla tua macchina; il guardiano tiene il suo codice lontano dalla tua coda di incidenti.
Se esegui Codex in --yolo di proposito, in un container, con un guardiano sul diff, hai una configurazione difendibile. Se lo esegui in --yolo sul tuo portatile perché le richieste davano fastidio, leggi la guida completa alla sicurezza di Codex, guarda come funziona lo YOLO mode di Cursor, oggi Run Everything e poi parliamone.
Domande frequenti
danger-full-access e --yolo sono la stessa cosa?
No. --sandbox danger-full-access toglie la sandbox del SO e mantiene le richieste di approvazione. --dangerously-bypass-approvals-and-sandbox (--yolo) toglie la sandbox e le richieste. Il preset "Full access" del selettore corrisponde al secondo.
Cosa fa esattamente codex --yolo?
Esegue subito ogni comando generato dal modello, con i permessi del tuo utente, sul tuo filesystem reale, con rete senza limiti, e non chiede mai nulla. La reference di OpenAI lo riserva a un ambiente irrobustito dall'esterno, cioè un container o una VM che siano essi stessi il confine.
-a never è pericoloso da solo?
Meno di quanto si pensi, purché la sandbox resti attiva. --ask-for-approval never toglie il punto di controllo umano, ma workspace-write continua a confinare le scritture e la rete resta chiusa a meno che tu non l'abbia aperta. Diventa pericoloso nel momento in cui lo abbini a danger-full-access.
Cos'è la "modalità unsafe" di Codex?
Non esiste alcun flag con quel nome. "Modalità unsafe", "modalità pericolosa" e "run dangerously" vengono usati per indicare danger-full-access, --yolo o -a never, che sono tre cose diverse. Verifica a quale si riferisce davvero un tutorial prima di copiare il comando.
A cosa serve --dangerously-bypass-hook-trust?
Esegue gli hook abilitati senza la revisione di fiducia, solo per quell'invocazione. Da Codex 0.129.0 (7 maggio 2026) un hook nuovo o modificato viene saltato finché non approvi la sua definizione esatta in /hooks; questo flag, aggiunto nella 0.131.0 (18 maggio 2026), toglie quel controllo per le esecuzioni senza interfaccia, come quelle in CI. Non viene salvato nulla in config.toml, gli hook disattivati restano disattivati e Codex mostra un avviso all'avvio. La reference della CLI di OpenAI lo riserva all'automazione che verifica già l'origine dei propri hook. Un hook è uno script che gira sulla tua macchina: su un repository che non hai scritto tu, tieni la revisione.
Come lascio che Codex usi la rete senza accesso completo?
Imposta network sotto [sandbox in config.toml, oppure passa -c sandbox per una singola esecuzione. Le scritture restano confinate al workspace; si apre solo la rete.
La sandbox di Codex funziona su Windows?
Sì. Da PowerShell usa una sandbox nativa di Windows, con o senza elevazione; sotto WSL2 usa il meccanismo Linux (bubblewrap e seccomp). I valori di --sandbox e le chiavi di config.toml sono gli stessi su tutte le piattaforme.
La sandbox ferma la prompt injection?
Contiene ciò che un comando iniettato può toccare; non ferma l'iniezione. Un README malevolo può ancora spingere il modello a scrivere codice insicuro, o a chiedere un'escalation che un umano stanco approva. Tieni la sandbox attiva e aggiungi un livello che controlli il codice e i comandi, non solo i percorsi dei file.