


In questa pagina
- Claude Code è conforme al GDPR?
- Che cosa invia Claude Code ad Anthropic?
- Anthropic addestra i suoi modelli sulle mie sessioni di Claude Code?
- Per quanto tempo Anthropic conserva i dati di Claude Code?
- Che cosa salva Claude Code sul mio computer?
- Claude Code può leggere il file .env?
- Come tengo segreti e codice regolamentato lontani da Claude Code?
- Quello che nessuna impostazione di privacy copre
- Domande frequenti
- Claude Code è conforme al GDPR?
- Claude Code invia il mio codice ad Anthropic?
- Anthropic usa il mio codice per addestrare Claude?
- Come si disattiva l'addestramento in Claude Code?
- Per quanto tempo Anthropic conserva i dati di Claude Code?
- Posso tenere in Europa i dati di Claude Code?
- Claude Code ha la certificazione SOC 2 o ISO 27001?
- Claude Code può leggere il mio .env?
- Claude Code salva il mio codice sul computer?
- Claude Code è sicuro?
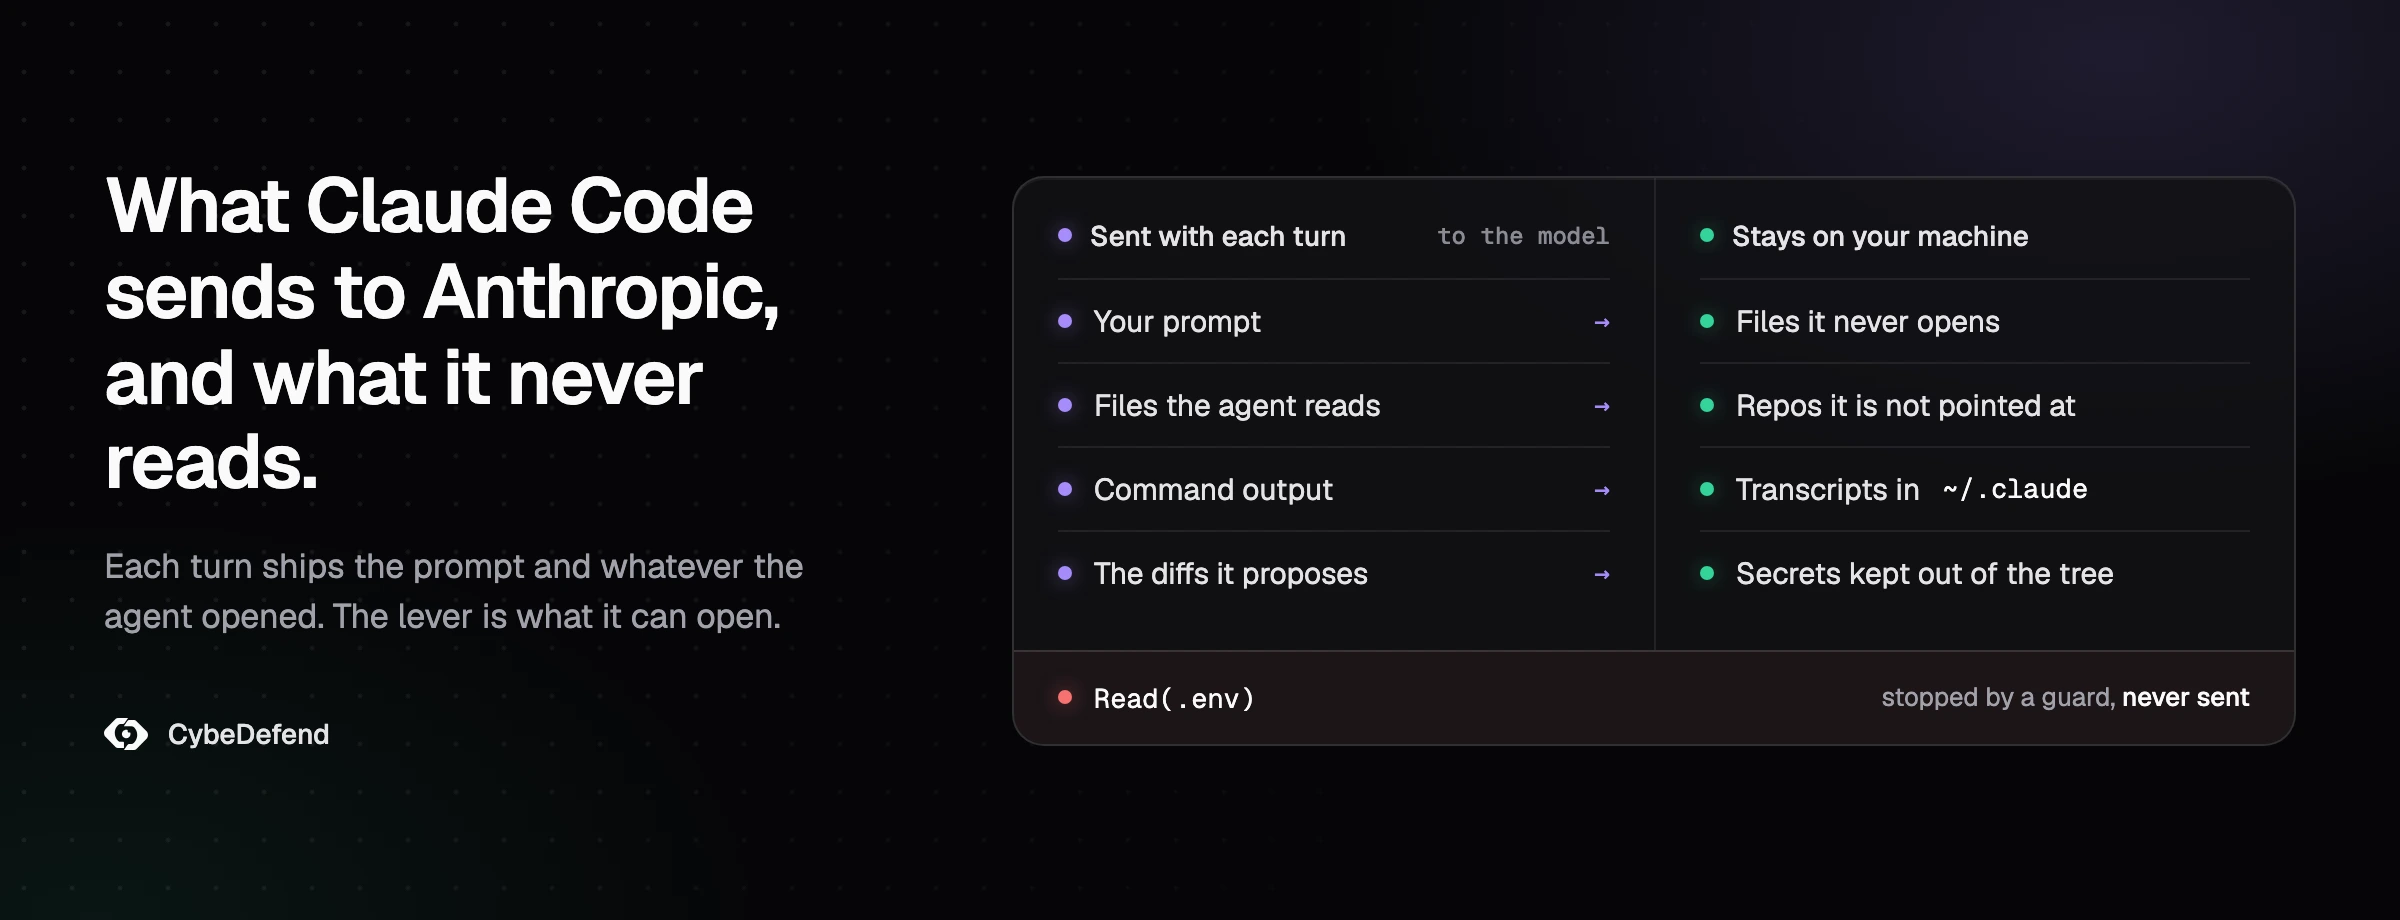
Sì, Claude Code invia il tuo codice ad Anthropic. Ogni prompt, ogni risposta e tutto quello che l'agente porta nella sua finestra di contesto, cioè i file che legge e l'output dei comandi che lancia, arriva al modello: un agente funziona così, non esiste una versione che lavori sul tuo repository senza vederlo. Per chi deve rispondere del GDPR, però, quel sì è solo il punto di partenza. Conta l'account con cui accedi, perché decide se il codice può finire nell'addestramento di un modello e per quanto tempo viene conservato. Conta dove vengono archiviati i dati e chi ne risponde, come titolare o come responsabile del trattamento. Conta quello che resta sul tuo disco, in chiaro. E contano poche impostazioni, quelle che stabiliscono che cosa l'agente può aprire. Questa guida affronta ogni punto partendo dalla documentazione di Anthropic, consultata l'11 ottobre 2026.
Claude Code è conforme al GDPR?
Nessuno strumento è conforme al GDPR di per sé: conforme può esserlo l'uso che ne fa la tua organizzazione, e Anthropic mette a disposizione i documenti per dimostrarlo. Ecco i fatti che il tuo DPO ti chiederà per primi.
- Chi è il titolare e chi il responsabile. Per gli account personali nel SEE, nel Regno Unito e in Svizzera, l'informativa privacy di Anthropic (in vigore dal 10 settembre 2026) indica come titolare del trattamento Anthropic Ireland, Limited, e fornisce i recapiti del suo responsabile della protezione dei dati. Per l'uso aziendale, invece, Anthropic è il tuo responsabile del trattamento ai sensi del suo Data Processing Addendum, in vigore dal 24 febbraio 2025, che incorpora le clausole contrattuali standard (Modulo 2 e Modulo 3) e le sottopone al diritto irlandese. Il DPA entra in automatico nelle condizioni commerciali di Anthropic; se passi da Bedrock o da Google Cloud, valgono le condizioni di quella piattaforma.
- Dove finiscono i dati. Negli Stati Uniti. Alla domanda se ospiti i modelli su server europei, Anthropic risponde che il traffico può essere instradato verso Stati Uniti, Europa, Asia e Australia, poi aggiunge: «Note that data is stored in the US». Quindi l'elaborazione può passare dall'Europa, l'archiviazione no. Sull'API di Claude, le impostazioni di residenza dei dati prevedono l'inferenza solo in
"global"o in"us", e per l'archiviazione di un workspace l'unica area geografica disponibile oggi è"us". - Come tenere le richieste in UE. Passando da un cloud. La documentazione di Claude Code descrive un prefisso di inferenza
eusu Amazon Bedrock (ANTHROPIC) e una località multiregione_BEDROCK _REGION _PREFIX= eu eusu Google Cloud (CLOUD_ML_REGION=eu). I modelli disponibili cambiano da una regione all'altra: prima di impegnarti, verifica che ci sia quello che ti serve. - Le certificazioni di Anthropic. Il suo centro privacy elenca ISO 27001:2022, ISO/IEC 42001:2023, SOC 2 Type I e Type II, più una configurazione HIPAA-ready. Certificano i controlli di Anthropic, non il modo in cui il tuo team usa Claude Code.
Le autorità europee hanno già detto che cosa si aspettano da chi adotta questi strumenti, e le loro richieste corrispondono agli interruttori che trovi più avanti in questa guida. La conferenza tedesca delle autorità per la protezione dei dati (DSK), nelle sue linee guida su IA e protezione dei dati del 6 maggio 2024, considera preferibili le applicazioni che non usano gli input per l'addestramento e suggerisce di configurare gli account dei dipendenti in modo che nessun input addestri un modello e che nessuna cronologia sopravviva alla sessione. La CNIL francese, nelle sue prime indicazioni sull'adozione dell'IA generativa del 18 luglio 2024, chiede a chi la adotta di capire fino a che punto il fornitore possa riutilizzare i dati che riceve, e di adattare l'uso di conseguenza. L'AEPD spagnola ha pubblicato a febbraio 2026 (versione 1.2) delle linee guida sull'IA agentica, l'unico testo di un'autorità che abbiamo trovato dedicato espressamente agli agenti.
In pratica, per un team la questione GDPR riguarda di rado il codice sorgente. Riguarda i dati personali che gli stanno accanto: anagrafiche di clienti nelle fixture, un dump di produzione dimenticato in tmp/, indirizzi email in un file di log, le chiavi di database pieni di persone. Sono questi i file da tenere fuori dalla portata dell'agente, e il primo passo è sapere che cosa l'agente spedisce davvero.
Che cosa invia Claude Code ad Anthropic?
Tutto quello che serve al modello per rispondere, che è molto più del tuo prompt. La pagina di Anthropic sull'uso dei dati lo dice senza giri di parole: Claude Code gira in locale e, per dialogare con il modello, invia dati in rete, cioè tutti i prompt dell'utente e tutte le risposte del modello, cifrati in transito con TLS 1.2 o superiore.
Quello che sfugge a molti è che cosa conti come prompt. La pagina che spiega come funziona Claude Code elenca il contenuto della finestra di contesto: la cronologia della conversazione, il contenuto dei file, l'output dei comandi, il CLAUDE.md, la memoria automatica, le skill caricate e le istruzioni di sistema. Il modello vede solo quello che sta in quella finestra, quindi a ogni turno partono, insieme alle tue parole, i file che l'agente ha aperto e l'output dei comandi che ha eseguito. Se l'agente lancia cat config o git log -p, quell'output viaggia con la richiesta successiva.
Tre modalità inviano più di una sessione locale:
- Claude Code sul web clona il tuo repository in una macchina virtuale di Anthropic. La pagina sull'uso dei dati precisa che il repository viene copiato nella VM isolata della sessione e che Anthropic conserva la trascrizione, così puoi riprendere la sessione più tardi.
- Remote Control, finché resta connesso, salva la trascrizione della sessione sui server di Anthropic per sincronizzarla fra i tuoi dispositivi.
- WebFetch manda a
api.anthropic.comil nome host di ogni URL che scarica, per confrontarlo con una blocklist di sicurezza. Lo fa qualunque sia il provider del modello, anche con il traffico non essenziale disattivato. Parte solo il nome host, non il percorso né il contenuto della pagina, e l'impostazioneskiplo spegne.Web Fetch Preflight
Quello che non parte mai è quello che l'agente non apre. È la leva su cui gira tutto il resto di questa guida. Una cautela, però, dalla pagina di Anthropic sulla sicurezza: il confine della directory di lavoro è una richiesta di permesso, quindi un comando Bash che approvi può comunque scrivere ovunque il tuo account utente abbia accesso. È una domanda, non un muro.
Se usi Claude Code tramite Amazon Bedrock o Google Cloud (Vertex AI, oggi Agent Platform), le richieste vanno a quel cloud, alle sue condizioni. Con Microsoft Foundry dipende da dove è ospitato il modello: su Azure prompt e risposte restano in Azure, ma i metadati di utilizzo e i contenuti segnalati dai sistemi di sicurezza di Anthropic arrivano comunque ad Anthropic; con l'hosting di Anthropic, le richieste finiscono direttamente sulla sua infrastruttura. E qualunque sia il provider, precisa la stessa pagina sull'uso dei dati, il controllo del nome host di WebFetch raggiunge Anthropic.
Anthropic addestra i suoi modelli sulle mie sessioni di Claude Code?
Dipende da come hai fatto l'accesso. Con un account personale sì, se un'impostazione è attiva. Con un account commerciale no.
Per Free, Pro e Max, la pagina sull'uso dei dati dice che Anthropic addestra i nuovi modelli con i dati di questi account quando l'impostazione è attiva, anche quando li usi con Claude Code. L'impostazione è quella introdotta con l'aggiornamento dei termini per i consumatori del 28 agosto 2025, che dava agli utenti esistenti tempo fino all'8 ottobre 2025 per scegliere. Nelle impostazioni Privacy si chiama «Help Improve our AI models», e la documentazione di Claude Code rimanda direttamente a claude.
Spegnerla non ha effetto retroattivo. Lo stesso annuncio precisa che i tuoi dati restano nei cicli di addestramento già avviati e nei modelli già addestrati, e che le sessioni archiviate in precedenza non verranno più usate nei cicli futuri.
Per Team, Enterprise, l'API, Bedrock, Google Cloud e Claude Gov la documentazione è netta: «Anthropic does not train generative models using code or prompts sent to Claude Code under commercial terms». In altre parole, alle condizioni commerciali né il codice né i prompt servono ad addestrare modelli generativi, a meno che il cliente non abbia scelto di condividere i propri dati per migliorarli, per esempio aderendo al Development Partner Program. È un'adesione volontaria decisa dall'amministratore, disponibile solo sull'API diretta di Anthropic, non su Bedrock né su Google Cloud.
Tre strade portano comunque il tuo codice ad Anthropic anche con l'addestramento spento, ed è bene che la policy del team le nomini una per una:
- Il feedback. Con il comando
/feedbackparte verso Anthropic una copia della cronologia della conversazione, codice compreso. Le trascrizioni condivise con/feedback,/bugo/sharevengono conservate 5 anni. Sugli account personali, anche un pollice in su o in giù conserva l'intera conversazione fino a 5 anni. - Il sondaggio di fine sessione. Il voto in sé non invia altro, ma rispondere «Yes» alla domanda successiva carica la trascrizione e il log grezzo della sessione, con codice sorgente e contenuto dei file caricati «as-is», tali e quali. Anthropic li tiene fino a 6 mesi e non li usa mai per l'addestramento.
- Le segnalazioni di sicurezza. Il centro privacy di Anthropic avverte che le conversazioni segnalate per una revisione di sicurezza possono comunque servire ad addestrare i modelli del suo team Safeguards.
Per quanto tempo Anthropic conserva i dati di Claude Code?
Trenta giorni per la maggior parte degli usi aziendali, 30 giorni o 5 anni con un account personale, e più a lungo in alcuni casi particolari. I valori qui sotto vengono dalla pagina sull'uso dei dati, dalla pagina sulla Zero Data Retention e dal centro privacy.
| Situazione | Che cosa conserva Anthropic |
|---|---|
| Free, Pro o Max, addestramento attivo | Fino a 5 anni, in forma deidentificata, per le sessioni nuove o riprese dopo l'attivazione |
| Free, Pro o Max, addestramento spento | 30 giorni |
| Team, Enterprise o API | 30 giorni come standard (le sessioni che puoi riaprire nel prodotto restano lì, vedi sotto) |
| Claude for Enterprise con Zero Data Retention | Nulla dopo la consegna della risposta, salvo obblighi di legge o contrasto agli abusi |
| Sessione segnalata per una violazione delle policy | Input e output fino a 2 anni, punteggi di classificazione di sicurezza fino a 7 anni |
Trascrizioni inviate con /feedback, /bug o /share | 5 anni |
Due precisazioni per i piani commerciali. Su Team ed Enterprise, le conversazioni e le sessioni di coding che il prodotto ti permette di riaprire, Claude Code sul web compreso, restano conservate nel prodotto proprio a questo scopo, e secondo il centro privacy i periodi di conservazione personalizzati di Enterprise «do not apply to», cioè non si applicano, alle funzioni costruite su Claude Code sul web. Su Bedrock o Google Cloud, invece, la conservazione segue il tuo ambiente cloud, non la tabella di Anthropic.
La Zero Data Retention va letta con attenzione. Per Claude Code è riservata agli account idonei di Claude for Enterprise, non fa parte del piano Claude for Enterprise standard e non si attiva dalle impostazioni dell'amministratore: la abilita Anthropic, un'organizzazione alla volta. Il centro privacy indica anche l'altra strada: un'organizzazione con un accordo di Zero Data Retention copre Claude Code usato via API con la propria chiave API commerciale. In entrambi i casi non copre lo sviluppatore che accede con un account personale o con una chiave API di un'altra organizzazione, né i dati trattati da server MCP o da altre integrazioni esterne. Inoltre, dal 9 giugno 2026, la policy di Anthropic sui Covered Models conserva per 30 giorni prompt e output dei suoi modelli di classe Mythos, Claude Fable 5 e 5.1 compresi, «on every platform where these models are offered», cioè su ogni piattaforma che li offre. La pagina sulla Zero Data Retention li indica come modelli che richiedono la conservazione dei dati per impostazione predefinita.
Che cosa salva Claude Code sul mio computer?
Più di quanto si creda, e in chiaro. Secondo la pagina sull'uso dei dati, Claude Code salva le trascrizioni delle sessioni in testo in chiaro sotto ~/.claude/projects/, per 30 giorni di default, così puoi riprendere una sessione. Il periodo si regola con cleanupPeriodDays: il minimo è 1, e il valore 0 viene rifiutato.
Altri due file meritano una riga nella tua policy. Il riferimento della cartella .claude descrive ~ come «Every prompt you've typed, with timestamp and project path»: ogni prompt che hai digitato, con data, ora e percorso del progetto. E le trascrizioni delle sessioni avviate o riprese in Claude Desktop o in Cowork restano lì senza limiti di età, a meno di impostare desktop (Claude Code 2.1.248 o successivo).
La conseguenza è molto concreta. Un segreto letto dall'agente durante una sessione resta per un mese, di default, in una trascrizione sul disco, alla portata degli strumenti di backup, dei client di sincronizzazione e di chiunque metta le mani sul portatile. Accorciare la conservazione costa poco; fare in modo che il segreto non venga letto affatto è meglio.
Claude Code può leggere il file .env?
Sì, se il file sta nel progetto e niente lo vieta. A gennaio 2026 The Register ha fatto la prova su Claude Code 2.1.12, con .env elencato in un file .claudeignore: «We asked Claude to read the .env file and it did so». I giornalisti hanno chiesto a Claude di leggere il .env, e Claude l'ha letto; una regola deny in settings.json, invece, l'ha bloccato. Oggi la pagina di Anthropic sui permessi è esplicita: un .claudeignore nel progetto «has no effect», non ha alcun effetto, e le sue voci vanno spostate in regole deny su Read.
La soluzione documentata è proprio una regola deny. Questo blocco è adattato dall'esempio che Anthropic stessa propone nella pagina sulle impostazioni:
{
  "permissions": {
    "deny": [
      "Read(./.env)",
      "Read(./.env.*)"
    ]
  }
}
Tre dettagli decidono se la regola tiene. Primo, Read(./.env) vale solo per la cartella in cui hai avviato Claude Code, mentre un Read(.env) senza prefisso segue le regole di gitignore e trova il file a qualunque profondità: in un monorepo serve questa seconda forma. Secondo, una regola deny copre gli strumenti di Claude per i file, i comandi sui file che Claude Code riconosce in Bash (cat, head, tail, sed, tee) e le redirezioni, ma non uno script Python o Node che apre i file per conto suo. Terzo, grep -r sta in una zona grigia: la pagina sui permessi dice che la regola non lo copre, il changelog della 2.1.259 annuncia che ora chiede conferma, e una issue ancora aperta (#91690) segnala che la correzione non si riproduce su Windows con l'estensione di VS Code. Per un blocco che ogni processo rispetti, la documentazione rimanda alla sandbox, dove sandbox tiene anche dentro un permesso di lettura più ampio. La stessa pagina segnala una trappola: i comandi in sandbox ereditano le variabili d'ambiente di Claude Code, compresi i segreti che contengono, a meno di impostare CLAUDE.
Qui serve anche una guardia. VibeDefend, il livello che CybeDefend installa in Claude Code, Cursor e Codex, porta con sé guardie con regole pensate proprio per queste letture, attive di default. La regola sul .env blocca gli strumenti Read, Glob e Grep su **/.env e **/.env.* (esclusi i modelli come .env.example). Una seconda regola blocca i file di segreti riconoscibili dal nome (secrets.*, credentials.json). Una terza chiude la strada della shell: cat, grep, jq, cp e simili, e anche runtime come node -e o python -c puntati su un file di segreti. Viene bloccato anche l'echo di una variabile il cui nome fa pensare a un segreto, mentre il dump dell'intero ambiente fa scattare un avviso. La decisione viene presa sul tuo portatile, prima che lo strumento parta, quindi una lettura bloccata non invia nulla al modello.
Una guardia che confronta il testo dei comandi resta una cintura di sicurezza, non un muro. La nota di ricerca GuardFall della Cloud Security Alliance, pubblicata a luglio 2026, ha aggirato con la shell injection le guardie dei comandi di 10 agenti open source su 11 (Claude Code non era fra quelli testati), e la sua conclusione vale per qualunque strumento del genere, il nostro compreso: guardie così «cannot be trusted as a primary control», non possono fare da controllo principale. Il controllo principale è un segreto che nel progetto non c'è.
Come tengo segreti e codice regolamentato lontani da Claude Code?
Prima scegli l'account, poi restringi quello che l'agente può aprire, infine riduci quello che resta sul disco. In ordine di impatto:
- Scegli l'identità in base ai dati. Il codice aziendale passa da una licenza Team o Enterprise, da una chiave API dell'organizzazione, da Bedrock o da Google Cloud, mai da un login personale. Le richieste che devono restare in UE passano dal prefisso
eudi Bedrock o dalla localitàeudi Google Cloud. - Con un piano personale, controlla l'interruttore. «Help Improve our AI models», nelle impostazioni Privacy. Poi avvisa il team che
/feedbacke il «Yes» del sondaggio inviano comunque la trascrizione. - Tieni i segreti veri fuori dal progetto. Un secrets manager che inietta i valori a runtime batte qualunque regola: quello che non sta sul disco non si può leggere.
- Vieta le letture, in modo centralizzato. Metti
Read(.env),Read(.env.*)e i tuoi percorsi di segreti nelle managed settings, così la regola vale per ogni sviluppatore. E cancella.claudeignore, che non fa nulla. - Attiva la sandbox sui percorsi che contano.
sandboxblocca ogni processo, script compresi, e.filesystem .deny Read CLAUDEtoglie le credenziali dall'ambiente che i comandi dell'agente ereditano._CODE _SUBPROCESS _ENV _SCRUB - Accorcia quello che resta sul disco. Abbassa
cleanupPeriodDays, impostadesktope includiSession Cleanup Period Days ~nella policy sui portatili./ .claude /history .jsonl - Taglia il traffico facoltativo.
CLAUDEspegne gli aggiornamenti automatici, la telemetria, la segnalazione degli errori e_CODE _DISABLE _NONESSENTIAL _TRAFFIC= 1 /feedback. Non ferma il controllo del nome host di WebFetch: per quello serveskip. Le metriche, per quel che vale, secondo Anthropic non contengono mai codice, prompt o percorsi di file.Web Fetch Preflight - Tieni d'occhio la tua osservabilità. OpenTelemetry è spento di default e oscura i prompt. Se attivi
OTELo_LOG _USER _PROMPTS OTEL, codice e conversazioni finiscono nel tuo collector, che da quel momento va protetto come il codice stesso._LOG _RAW _API _BODIES - Cerca i segreti prima che vengano letti e prima del commit. Una chiave che uno scanner ti segnala oggi è una chiave che la prossima sessione non caricherà nel contesto.
Quello che nessuna impostazione di privacy copre
Tutti i controlli visti finora governano quello che Claude Code legge e invia. Nessuno governa quello che scrive, eppure il codice che scrive è una superficie privacy a sé. Pensa a un agente che incolla nel codice un token visto in una fixture, che mette a log il corpo intero di una richiesta con dentro l'email di un cliente, o che restituisce record che il chiamante non era autorizzato a vedere. Ha appena creato un problema di protezione dei dati che nessun periodo di conservazione potrà risolvere, perché la fuga ormai sta nel tuo repository e nei tuoi log di produzione.
È il livello che VibeDefend aggiunge mentre l'agente scrive. Porta le tue regole di business e di sicurezza sulla riga che si sta modificando, ferma l'azione pericolosa prima che parta e, prima del commit, analizza il diff alla ricerca di problemi SAST, IaC e di segreti esposti. Visto che questo articolo parla di dove va il codice, ecco dove va il nostro. Le guardie decidono sul tuo portatile. Per servire le regole adatte alla riga in scrittura, VibeDefend invia un breve estratto di quel codice al backend di CybeDefend, nella regione UE o US che scegli all'installazione; l'analisi prima del commit invia i file modificati; e il tuo codice non viene mai usato per addestrare un modello. La pagina sulla sicurezza spiega che cosa viene conservato e dove.
Le regole servite sulla riga fanno anche una cosa che un file non sa fare. Nello studio controllato di CybeDefend, un agente al lavoro su trenta ticket ha violato 2,28 regole per ticket senza alcuno strumento, 2,27 con un file di regole tenuto a mano nel repository e 0,28 con VibeDefend. Il nostro articolo su quanto Claude Code rispetti il CLAUDE.md spiega perché il file cambia così poco.
Per il resto del quadro, leggi la guida ai rischi di sicurezza di Claude Code e quella su --dangerously-skip-permissions. Se nel tuo team gira anche Codex, la stessa domanda posta a OpenAI ha risposte diverse. E se stai portando Claude Code su codice che non deve uscire dall'azienda, parliamone.
Domande frequenti
Claude Code è conforme al GDPR?
Si può usare Claude Code nel rispetto del GDPR, ma dimostrarlo spetta alla tua organizzazione. Per l'uso aziendale Anthropic offre un Data Processing Addendum con clausole contrattuali standard regolate dal diritto irlandese, e per gli account personali in Europa il titolare del trattamento è Anthropic Ireland. I dati vengono archiviati negli Stati Uniti; per instradare le richieste in UE bisogna passare da Bedrock o da Google Cloud.
Claude Code invia il mio codice ad Anthropic?
Sì. Ogni richiesta porta con sé il tuo prompt e tutto quello che sta nella finestra di contesto dell'agente, compresi il contenuto dei file letti e l'output dei comandi eseguiti, cifrato in transito. Un file che l'agente non apre non parte mai. Su Bedrock o Google Cloud le richieste vanno invece a quel cloud, anche se il controllo del nome host di WebFetch arriva comunque ad Anthropic.
Anthropic usa il mio codice per addestrare Claude?
Con un account Free, Pro o Max, Anthropic usa le tue sessioni di Claude Code per l'addestramento solo se l'impostazione «Help Improve our AI models» è attiva. Con Team, Enterprise, l'API, Bedrock o Google Cloud non lo fa. L'unica eccezione è un'organizzazione che aderisce al Development Partner Program, che esiste solo sull'API diretta di Anthropic.
Come si disattiva l'addestramento in Claude Code?
Con un piano personale, spegni «Help Improve our AI models» nelle impostazioni Privacy di claude.ai. Vale per le sessioni future: i cicli di addestramento già avviati tengono i dati. In alternativa usa una licenza Team o Enterprise, una chiave API dell'organizzazione, Bedrock o Google Cloud, dove l'addestramento è spento di default. Sul codice sensibile evita /feedback e il «Yes» del sondaggio, perché entrambi inviano la trascrizione.
Per quanto tempo Anthropic conserva i dati di Claude Code?
Con un account personale, 30 giorni se l'addestramento è spento e fino a 5 anni se è attivo. Con Team, Enterprise e API, 30 giorni come standard. Per le sessioni segnalate, input e output restano fino a 2 anni, e le trascrizioni inviate con /feedback 5 anni. La Zero Data Retention esiste per le organizzazioni Claude for Enterprise idonee e per le organizzazioni API con un accordo di Zero Data Retention, ed è Anthropic a concederla.
Posso tenere in Europa i dati di Claude Code?
Non sull'API di Anthropic, per ora: l'inferenza gira in un'area globale o negli Stati Uniti e l'archiviazione avviene negli Stati Uniti. Per tenere le richieste in Europa, usa Claude Code tramite Amazon Bedrock con il prefisso di inferenza eu, oppure tramite Google Cloud con la località multiregione eu, alle condizioni di quel cloud, e verifica che il tuo modello sia disponibile lì.
Claude Code ha la certificazione SOC 2 o ISO 27001?
Anthropic elenca fra le sue certificazioni SOC 2 Type I e Type II, ISO 27001:2022 e ISO/IEC 42001:2023, più una configurazione HIPAA-ready per Claude for Enterprise. Coprono i controlli interni di Anthropic. Il tuo auditor SOC 2 ti chiederà comunque come il team ha configurato Claude Code: quali account, quali regole deny, quale conservazione.
Claude Code può leggere il mio .env?
Sì, se non glielo vieti. Aggiungi Read(.env) e Read(.env.*) alla lista deny di settings.json; un file .claudeignore non ha alcun effetto. Una regola deny copre gli strumenti di Claude per i file e i comandi di shell che riconosce, come cat, ma non gli script che aprono il file da soli: per un blocco a livello di sistema operativo attiva la sandbox, e tieni i segreti veri fuori dal progetto.
Claude Code salva il mio codice sul computer?
Sì. Le trascrizioni delle sessioni, compreso quello che l'agente ha letto, restano in chiaro sotto ~/.claude/projects/ per 30 giorni di default, un periodo che regoli con cleanupPeriodDays (minimo 1). Ogni prompt che digiti finisce in ~, e le trascrizioni di Claude Desktop e Cowork non scadono finché non imposti desktop.
Claude Code è sicuro?
Può esserlo, con la configurazione giusta: un account commerciale al posto di un login personale, segreti fuori dal progetto e vietati per regola, la sandbox attiva sui percorsi sensibili, una conservazione locale breve e niente /feedback sul codice dei clienti. Resta scoperto il codice che l'agente scrive, che ha bisogno di controlli dedicati prima di arrivare a un commit.