

In questa pagina
- Claude Code segue il CLAUDE.md?
- Che cosa dice già la ricerca pubblicata?
- Che cosa abbiamo misurato noi che gli studi più grandi non hanno misurato?
- Che cosa succede quando la regola sta nel file, con il valore giusto?
- Le regole erano impossibili da indovinare per come le avete costruite?
- Perché due agenti configurati in modo diverso sbagliano allo stesso modo?
- Un CLAUDE.md perfetto risolve il problema?
- Che cosa dicono i vendor di sicurezza sui file di regole?
- Che cosa vale la pena cambiare e che cosa no?
- Quanta fiducia meritano questi numeri?
- Che cosa vendiamo, detto senza giri di parole
- Domande frequenti
- Claude Code rispetta davvero il CLAUDE.md?
- Come si scrive un buon CLAUDE.md?
- Che cosa deve contenere un CLAUDE.md?
- Quanto deve essere lungo un CLAUDE.md?
- Claude Code legge AGENTS.md o solo CLAUDE.md?
- Perché Claude Code non segue le mie regole?
- Il CLAUDE.md serve davvero a qualcosa?
- Il CLAUDE.md va committato nel repository?
- Karpathy ha davvero misurato errori in calo dal 40% all'11% con un CLAUDE.md?
- Come si impone davvero una regola in Claude Code?
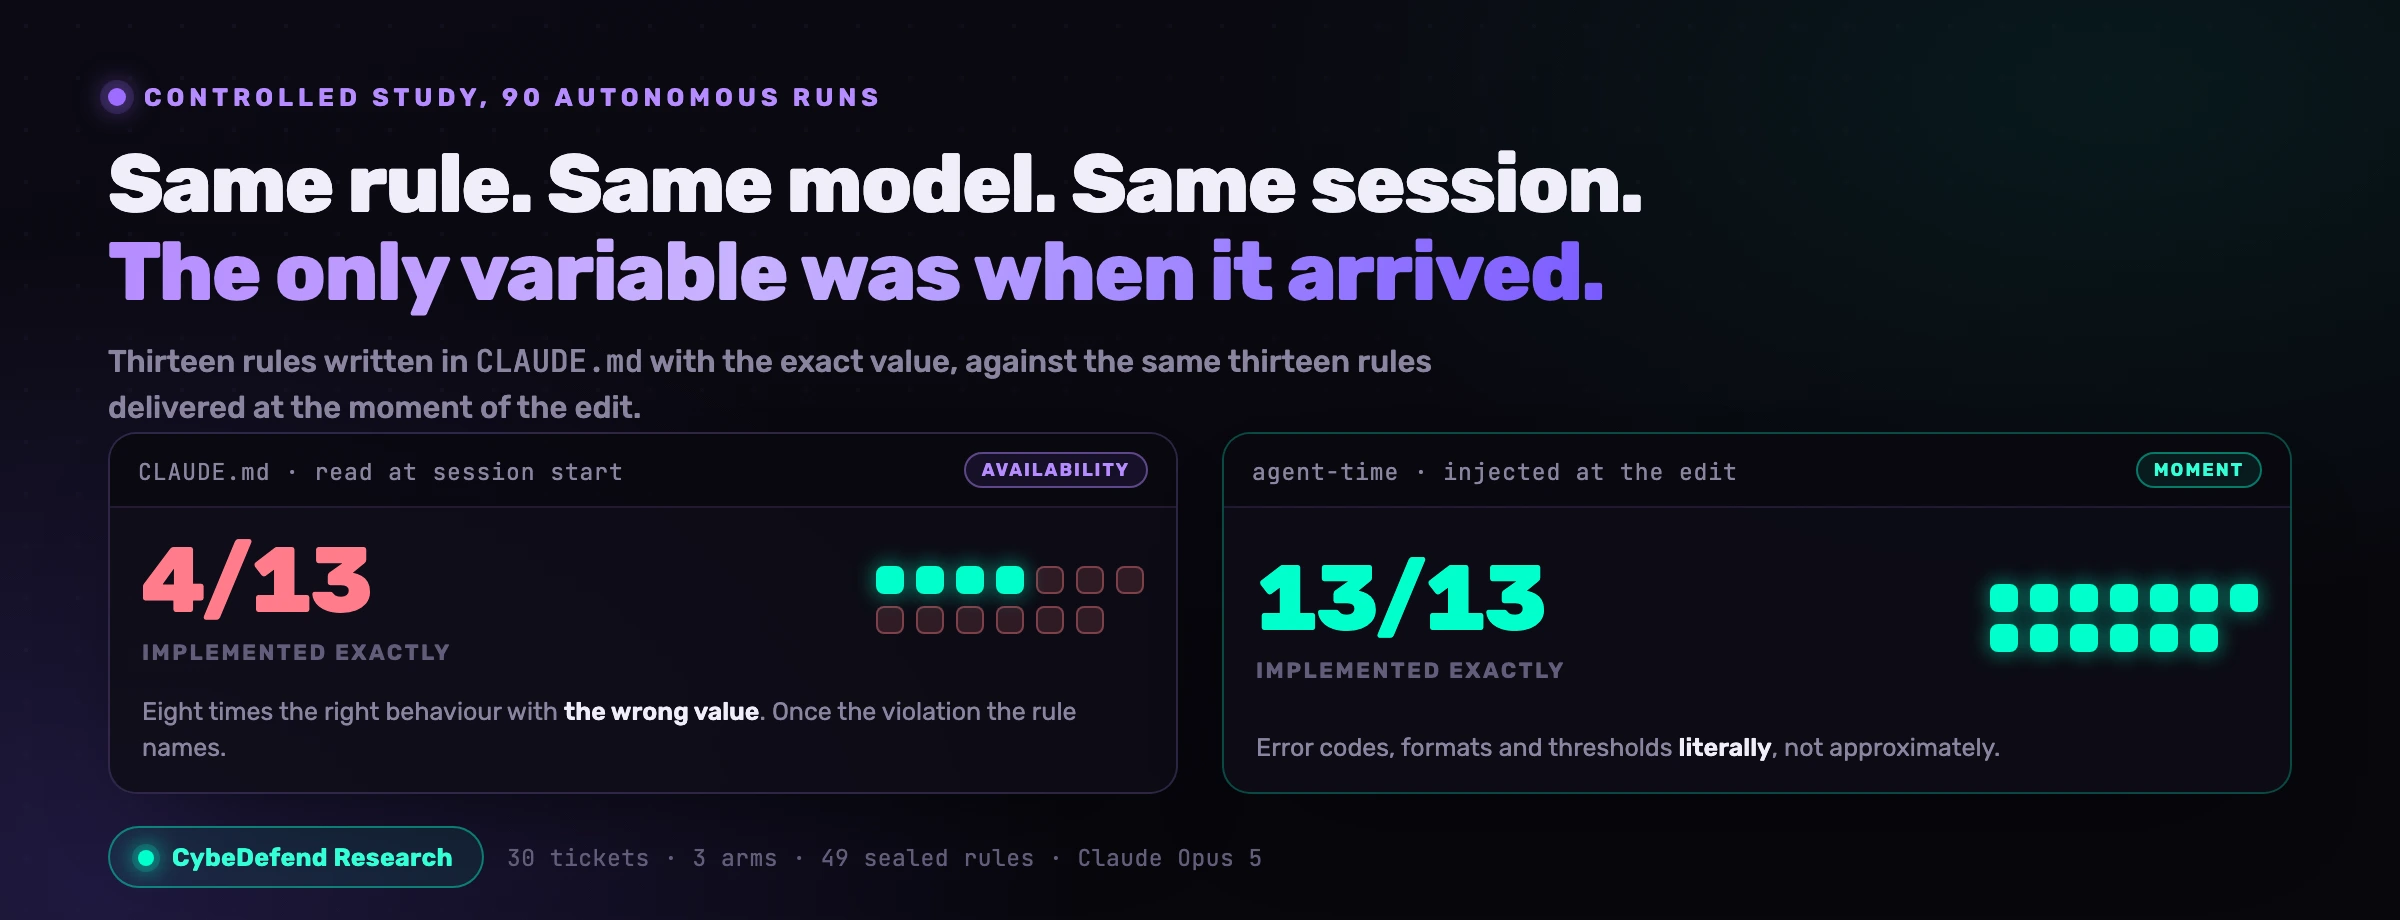
Claude Code rispetta il tuo CLAUDE.md sulle istruzioni che avrebbe azzeccato comunque, e se lo dimentica proprio su quelle per cui il file lo hai scritto. Lo abbiamo misurato: 30 ticket di sviluppo, tre agenti autonomi, una sola codebase, un solo modello, 90 run in tutto. L'unica variabile era da dove l'agente poteva ricavare le 49 regole di business e di conformità della piattaforma. Con una sezione di regole scritta a mano nel CLAUDE.md, come la scrive un team vero, l'agente ha implementato alla lettera 7 dettagli di regola su 55. Senza nessuna regola da nessuna parte, 7 su 55. Stesso punteggio.
Claude Code segue il CLAUDE.md?
In parte, e la parte che si perde per strada è proprio quella che ti interessa. Anthropic non lo nasconde. La pagina della documentazione dedicata alla memoria dice che i file CLAUDE.md vengono caricati all'inizio di ogni conversazione e che Claude «li tratta come contesto, non come configurazione imposta». La pagina di troubleshooting è ancora più netta: Claude lo legge e prova a seguirlo, ma «non c'è nessuna garanzia di rispetto rigoroso, soprattutto per istruzioni vaghe o in conflitto fra loro».
Quello che, al 13 settembre 2026, Anthropic non pubblica è un numero. Nella documentazione non compare nessun tasso di conformità misurato: scelta comprensibile per chi vende il prodotto, inservibile per un team che deve decidere se quel file sia un controllo o un consiglio.
La domanda, intanto, resta viva. Cercando nell'issue tracker di anthropics/claude-code i titoli che contengono insieme CLAUDE.md e una forma di «ignore» si ottengono 199 risultati, 9 dei quali ancora aperti al 13 settembre 2026.
Non tutti parlano di rispetto delle regole, ma il titolo che torna è inequivocabile: CLAUDE.md Mandatory Rules Consistently Ignored Across Multiple Repositories, aperto da giugno 2025 e con 45 reazioni. Il plurale dice tutto. Non stanno segnalando un bug, stanno descrivendo una proprietà.
Che cosa dice già la ricerca pubblicata?
Che la struttura del file non c'entra. Quanto è lungo, dove metti la regola al suo interno, se lo spezzi in più file: niente di tutto questo produce un effetto misurabile, mentre il rispetto delle regole si degrada man mano che la sessione si allunga. Non è un risultato nostro, e vogliamo metterlo in chiaro prima di passare ai nostri numeri.
A maggio 2026 Damon McMillan ha pubblicato Instruction Adherence in Coding Agent Configuration Files: A Factorial Study of Four File-Structure Variables (arXiv 2605.10039, sottomesso l'11 maggio 2026). Sulla domanda è il lavoro più solido che esista, e con distacco: 1.650 sessioni di Claude Code CLI, 16.050 osservazioni a livello di funzione, due codebase TypeScript, cinque task di sviluppo, Sonnet 4.6 con Opus 4.6 come controllo su un secondo modello. Le quattro variabili manipolate in modo fattoriale sono esattamente quelle su cui insistono tutte le guide: la dimensione del file, la posizione dell'istruzione, la divisione in più file e le contraddizioni con i file vicini.
Nessuna delle quattro ha lasciato traccia. Il paper lo scrive così: «nessuna delle quattro variabili strutturali e nessuna delle tre interazioni a due vie produce un contrasto rilevabile dopo la correzione per test multipli». Sulla dimensione e sui conflitti il risultato nullo è sostenuto da fattori di Bayes che giocano a favore del nullo (BF10 fra 0,05 e 0,10), il che dice molto di più di un semplice mancato rifiuto dell'ipotesi nulla.
Una cosa sola si muove, ed è il tempo. Ogni funzione in più che l'agente genera si associa a un calo di circa il 5,6% delle probabilità di conformità a ogni passo (OR = 0,944), con un andamento che il paper descrive come non monotono.
Questo secondo punto è il perno. Un'annotazione banale è un marcatore che l'agente non ha nessun motivo di scrivere se il file non glielo chiede: lì il compito del file è portare la conformità da quasi zero a qualcosa, e quel compito lo assolve. Noi siamo andati a cercare il caso commercialmente scomodo, cioè quando l'istinto dell'agente produce già una risposta plausibile e la regola dice che quella risposta plausibile è sbagliata.
Che cosa abbiamo misurato noi che gli studi più grandi non hanno misurato?
Il caso in cui l'agente una risposta ce l'ha già. Il nostro studio controllato, pubblicato il 24 agosto 2026, ha fatto girare 30 ticket di sviluppo su una codebase Express e SQLite di media taglia, in triplice copia: tre agenti autonomi, stessi ticket, stesso modello (Claude Opus 5 a effort high), 90 run e 93 scansioni di sicurezza indipendenti. Cambiava una cosa sola, il canale da cui l'agente poteva conoscere le 49 regole della piattaforma: niente, una sezione di regole nel CLAUDE.md del repository, oppure l'injection nel momento della modifica.
Le regole coprono undici famiglie: rimborsi, aritmetica del programma fedeltà, minimizzazione GDPR, obbligo di prezzo di riferimento della direttiva Omnibus, tetti al contante, piste di audit. Ognuna porta con sé un dettaglio volutamente arbitrario: 422 REFUND_EXCEEDS_CAPTURED, una soglia di 150,00 euro per l'approvazione del responsabile, erased-{id}@removed.invalid, ORD-{store}-{YYMMDD}-{seq}.
La sezione del braccio con file è stata scritta come la scrivono i team veri: 41 righe per circa metà del corpus, tutto parafrasato, due valori ormai vecchi, famiglie intere assenti. Quello che il file diceva su ciascuna regola è stato congelato prima del primo run, insieme al corpus. I ticket sono stati redatti come incidenti, nella lingua di chi sviluppa, e passati a un controllo automatico per escludere che si portassero dietro i valori letterali. Ogni diff è stato valutato da tre revisori in cieco, che non sapevano da quale braccio arrivasse.
dettagli di regola esatti con una sezione di regole realistica nel CLAUDE.md
dettagli di regola esatti senza nessun file di regole
dettagli di regola esatti con la regola consegnata alla modifica
Sette su 55 in tutti e due i bracci di controllo. Non vicini: identici. Sui diciannove task della fase 1, avere nel repository un file di regole realistico non ha cambiato niente di misurabile nel codice prodotto.
Ha cambiato la forma degli errori, ed è l'unico contributo che gli abbiamo visto dare. Il braccio senza niente violava di più (18 contro 12), quello con il file arrivava più spesso al comportamento giusto con il valore sbagliato (28 contro 20). Un documento parafrasato sposta l'errore da «violata» a «quasi». A «esatta» non ci arriva.
Che cosa succede quando la regola sta nel file, con il valore giusto?
Viene implementata alla lettera nel 31% dei casi. Dato che la copertura del file, regola per regola, era stata congelata prima dei run, la fase 1 si può dividere per quello che il file diceva davvero. Su 13 regole il valore giusto c'era, nero su bianco, dentro un documento che l'agente carica all'inizio di ogni sessione.
| Che cosa diceva il file | Regole valutate | Esatte | Effetto giusto, valore sbagliato | Violate | Esatte se servite alla modifica |
|---|---|---|---|---|---|
| Il valore giusto, scritto per esteso | 13 | 4 (31%) | 8 | 1 | 13 (100%) |
| Vaga: la direzione, senza il valore | 21 | 2 (10%) | 13 | 2 | 15 (71%) |
| Assente: mai scritta | 20 | 1 (5%) | 6 | 9 | 18 (90%) |
La prima riga merita una seconda lettura. La variabile non era la disponibilità dell'informazione, era il momento in cui arrivava.
Il caso più netto è il task M06. Il ticket chiede di accettare una gift card che non copre tutto il carrello, con una carta bancaria per la differenza. La regola dice che si matura un punto fedeltà per ogni euro intero pagato in denaro e che la quota coperta dalla gift card non ne matura nessuno. Il braccio con file quella regola ce l'aveva, esatta.
Ha riscritto la funzione di pagamento, ha calcolato la quota ammissibile per mettere in ordine i mezzi di pagamento, e ha lasciato intatta la riga floor(total / 100) che conia i punti sul totale. Nel flusso appena scritto da lui, gli euro della gift card fanno punti.
Il lavoro di un ingegnere scrupoloso che non ha mai visto il documento delle regole.
Invece lo aveva letto, all'inizio della sessione, in un file caricato prima del primo turno. Il braccio che ha ricevuto la stessa regola dentro il loop, mentre modificava il file dei pagamenti, ha scritto earned = floor(remainderCents / 100) e due test dedicati.
Le regole erano impossibili da indovinare per come le avete costruite?
Alcune sì, ed è un'obiezione da prendere di petto invece che da nascondere. Quanto ogni regola fosse indovinabile lo abbiamo classificato una per una, e congelato prima del primo run: 35 non indovinabili, 13 debolmente indovinabili, 1 indovinabile. I dettagli arbitrari sono voluti, perché sono l'unico modo per distinguere un agente che conosce la regola da uno che ne indovina una ragionevole.
La separazione è il task M21. Tutti e tre i bracci hanno messo il tetto di 1.000 euro ai pagamenti in contanti, perché è un fatto di legge pubblico che il modello conosce e che non c'è bisogno di ricordargli. Solo il braccio che ha ricevuto la regola ha risposto con il codice di errore della piattaforma, 422 CASH_LIMIT, testato al centesimo sul limite della quota in contanti di un pagamento misto. Gli altri due hanno restituito un 422 con un messaggio in prosa.
Per chi consuma la tua API non sono la stessa cosa: il primo caso si gestisce, il secondo lo deve indovinare chi scrive l'integrazione. Un'azienda non paga per quello che il modello sa del mondo, paga per il contratto arbitrario che tiene insieme i suoi sistemi.
Chi trova il nostro corpus troppo arbitrario deve allora rispondere alla domanda che pone M21: i tuoi codici di errore e i tuoi formati, quanto sono meno arbitrari?
Perché due agenti configurati in modo diverso sbagliano allo stesso modo?
Perché gli errori degli agenti sono deterministici, non vari. È il risultato che non avevamo previsto, ed è quello con le conseguenze operative più pesanti. Su 16 dei 30 task i due bracci di controllo, lanciati separatamente in alberi diversi, sono finiti sulla stessa implementazione sbagliata. Non simile: la stessa.
- Lo stesso SQL in scrittura assoluta al riconteggio annuale,
quantity = excluded.quantity, dove la regola pretende un movimento tipizzato su un registro. - Lo stesso design vietato per le promozioni sovrapposte, «la sovrapposizione è una feature, vince la più forte», che è l'istinto di qualunque sviluppatore ed esattamente ciò che la regola di prezzo vieta.
- Lo stesso tetto di 4.000 caratteri sulle diagnostiche conservate, e lo stesso campo
ibandimenticato nell'elenco dei dati da oscurare.
Se parti dal presupposto che un output sbagliato sia un tiro di dadi, e che alla seconda o alla terza occorrenza la review lo intercetti, quel presupposto puoi metterlo via. Chi non mette il proprio contratto davanti all'agente non ottiene un ventaglio di interpretazioni fra cui un revisore possa scegliere. Ottiene ovunque la stessa interpretazione ragionevole e sbagliata, difesa ogni volta dagli stessi test.
Ed è l'ultima parte quella che pesa. Dopo 30 ticket i bracci di controllo si sono lasciati dietro 57 e 52 regole non conformi, di cui 21 e 12 violazioni vere e proprie: dati personali in un export per il corriere e nei log, un prezzo barrato illegale, punti fedeltà sulle gift card, stock sovrascritto senza lasciare traccia.
Almeno un terzo era inchiodato da test verdi che gli agenti si erano scritti da soli. Il debito non è soltanto silenzioso, è difeso dalla CI. Ne parliamo più a fondo in falle di logica di business nel codice generato dall'AI.
Un CLAUDE.md perfetto risolve il problema?
Copre due terzi della strada, e lo abbiamo verificato invece di darlo per buono. Dopo il task 22 il divario sollevava un'obiezione legittima: il braccio con file una vera possibilità l'aveva mai avuta? Abbiamo quindi pre-registrato un emendamento e sostituito la sezione ormai alla deriva con il corpus completo delle 49 regole, parola per parola, codici e formati letterali compresi, presentato come appena sincronizzato dall'engineering. Più forte di così, «metti le regole nel repo» non si può fare.
Il 64% è un miglioramento vero e non faremo finta del contrario. È anche il tetto, costa gli stessi token, e i quattro fallimenti sono istruttivi: il braccio con file ha centrato le regole verso cui il ticket puntava, e ha perso su due fronti diversi.
Il primo fronte sono i dettagli di contorno dentro una regola che per il resto aveva azzeccato. Con 403 ADJUSTMENT_LIMIT oltre più o meno 30 unità scritto nel suo file parola per parola, ha impostato la soglia esatta di 30 e ha risposto con un 403 in prosa, senza il letterale. La diluizione agisce anche dentro una singola regola, non solo lungo un documento.
Il secondo fronte sono le regole trasversali, quelle che il ticket non nomina. Il divieto di scrivere direttamente sulle quantità di stock era nel suo file, per esteso, e ha perso tre volte su tre contro l'abitudine del codice che l'agente aveva davanti.
Il codice esistente, del resto, è un'istruzione implicita più forte di qualunque documento: gli mostra come si fa qui, ce l'ha sotto gli occhi mentre scrive, e per giunta compila. Una regola che contraddice un'abitudine del codice vince solo se arriva nello stesso momento dell'abitudine.
Che cosa dicono i vendor di sicurezza sui file di regole?
Dicono entrambe le cose, spesso dentro lo stesso prodotto, e quasi mai con una misura in mano.
La tesi ottimista è arrivata presto ed è argomentata bene. A giugno 2025 Rami McCarthy, di Wiz, ha pubblicato Rules Files for Safer Vibe Coding e ha rilasciato in open source regole di sicurezza di base per Cursor, Windsurf, Copilot, l'AGENTS.md di Codex e il CLAUDE.md di Claude. La sua tesi è che i file di regole siano «il modo ideale per centralizzare e standardizzare questi accorgimenti di prompt orientati alla sicurezza», con un paletto messo dall'articolo stesso: il miglior file di regole di sicurezza è quello cucito su misura per la tua organizzazione. Sulla classe di rischio a cui punta, la postura generica di secure coding, non abbiamo prove contrarie.
La tesi scettica, di solito, riguarda chi può modificare il file più che il fatto che il modello lo segua. La guida di Kodem sulla messa in sicurezza degli editor di codice AI, pubblicata il 31 ottobre 2025 da Mahesh Babu, sostiene che le protezioni di questi strumenti «nella pratica vengono spesso disattivate», e che così resta «un ambiente in cui codice non fidato o file di regole avvelenati girano senza nessun controllo». Problema reale, ma problema diverso: una regola può saltare perché qualcuno l'ha spenta, e può saltare anche perché il modello l'ha diluita, con il file perfettamente intatto.
Poi c'è lo schema che rivela più di quanto vorrebbe, cioè chi pubblica un file di regole e insieme vende un prodotto che inietta contesto. Sonar pubblica un AGENTS.md per il suo workflow agentico e ti dice di metterlo nella root del repo come file di istruzioni dell'agente, e allo stesso tempo vende Vortex, che «inietta il contesto e i vincoli giusti del progetto, così gli agenti partono con le idee chiare».
Endor Labs, dal canto suo, legge il tuo CLAUDE.md come una dichiarazione d'intenti per il suo scanner: il 7 settembre 2026 osserva che un CLAUDE.md in cui sta scritto «tutte le route API sono autenticate dal nostro middleware SSO» racconta allo scanner qualcosa che nessuna quantità di pattern matching riuscirebbe a far emergere.
Un tasso di conformità non lo ha pubblicato nessuno di loro, e per quanto ci risulta nemmeno Anthropic. Finora la posizione si è retta su affermazioni e su thread GitHub. Adesso si regge su un grande studio fattoriale della struttura del file e su uno studio piccolo del caso difficile. È ancora poco. È comunque più di prima.
Che cosa vale la pena cambiare e che cosa no?
Parti da quello che i dati escludono, perché è lì che i team bruciano più tempo. McMillan ha testato, in modo fattoriale e su larga scala, le quattro cose che ogni guida al «buon CLAUDE.md» raccomanda.
| Il consiglio che gira ovunque | Che cosa ha trovato lo studio fattoriale |
|---|---|
| Accorcia il file | Nessun effetto rilevabile della dimensione, con un fattore di Bayes a favore del nullo |
| Metti la regola importante in cima | Nessun effetto rilevabile della posizione dell'istruzione |
| Spezzalo in più file, o usa gli import | Nessun effetto rilevabile dell'architettura del file |
| Togli le contraddizioni con i file vicini | Nessun effetto rilevabile dei conflitti, con un fattore di Bayes a favore del nullo |
Due precisazioni, perché la tabella non dice «fai come ti pare». La documentazione di Anthropic raccomanda davvero di stare sotto le 200 righe per file CLAUDE.md, e lo fa per ragioni di budget di contesto: sfoltire un file gonfio resta buona igiene. Ma se stai scommettendo un risultato di conformità sul passaggio da 300 righe a 150, l'unico esperimento diretto che esiste dice che quella differenza non la misurerai.
La seconda riguarda il famoso «lost in the middle», citato di continuo per giustificare lo spostamento delle regole in cima al file. McMillan ha confrontato una regola alla riga 2 con la stessa regola alla riga 250, e non ha trovato niente.
Ha sostegno, invece, la cosa che nessuno dei due studi si era proposto di misurare, cioè la distanza dalla scrittura. Il suo decadimento dentro la sessione e la nostra divisione fra regola servita e regola non servita sono lo stesso fenomeno visto da due lati. Delle 58 regole valutate che il nostro layer ha servito nel momento della modifica, 55 sono risultate esatte (95%). Delle 6 che non è riuscito a servire, 4 non lo erano. Stesso agente, stessa sessione, stessa intelligenza, distanza diversa. Il criterio con cui ordinare le tue regole, quindi, è uno solo: l'agente potrebbe indovinarla?
Nel file lascia ciò in cui è bravo: comandi di build, struttura del progetto, convenzioni che un ingegnere competente adotterebbe comunque, e tutto ciò che l'agente non produrrebbe mai da solo. Quest'ultima categoria è proprio quella che lo studio con la potenza statistica ha misurato, e lì il file funziona.
Sposta i dettagli arbitrari nel momento della modifica. Codici di errore, formati dei nomi di file, soglie, la forma della tua riga di audit, le colonne che il tuo export può contenere. Sono le regole che un file gestisce peggio, perché l'agente ha già pronta una risposta plausibile e il file prova a contraddirlo da trentamila token di distanza. Sono anche le regole che hanno dietro un regolatore o un cliente.
Lascia che le regole diventino struttura. Quando la regola arrivava al momento della modifica, l'agente costruiva il meccanismo che la regola implica: un registro dei movimenti, una chiave di idempotenza, un evento di audit. I task successivi lo riusavano, a volte senza che la regola venisse servita di nuovo. Quando al task 14 è arrivato il ticket sulla pista di audit, il braccio che emetteva eventi di audit fin dall'inizio l'ha completata in 334 righe; gli altri due, che non ne avevano mai scritto uno, l'hanno costruita da zero in 1.107 e 1.620. La conformità posata strada facendo è costata cinque volte meno codice di quella recuperata alla fine.
Per tutto ciò che non deve mai accadere, smetti di affidarti alla prosa. Anthropic è inequivocabile: per bloccare un'azione a prescindere da ciò che Claude decide serve un hook PreToolUse, perché le istruzioni del CLAUDE.md modellano il comportamento di Claude ma non sono un livello di enforcement rigido. Una regola che non puoi permetterti di perdere è un hook o un permesso, non un punto elenco. E il file rivedilo come rivedi il codice, perché chiunque possa fare commit lì dentro sta scrivendo la policy del tuo agente: vedi instruction file injection.
Quanta fiducia meritano questi numeri?
Meno di quelli di McMillan, e preferiamo dirlo noi piuttosto che lasciartelo scoprire. Abbiamo fatto un run per braccio e per task, su una codebase sola, con un modello solo, su 25 task che portavano regole e circa 65 regole valutate per braccio. Lui ha fatto 1.650 sessioni e 16.050 osservazioni.
I divari principali, 13% contro 87% e 64% contro 100%, sono troppo larghi per essere incidenti di conteggio, ma le distribuzioni secondarie vanno lette tenendo presente quel campione. Nessun valore p, deliberatamente.
Il corpus lo abbiamo scritto noi, e vendiamo uno strumento che consegna le regole al momento della modifica. Contro quel conflitto abbiamo messo tre tutele: corpus e griglie di valutazione sigillati prima di ogni run, indovinabilità classificata in anticipo, ticket verificati a macchina perché non si portassero dietro i valori letterali. I revisori in cieco sono modelli, non persone. Una replica con revisori umani è il passo successivo ovvio, e non l'abbiamo fatta. Lo studio racconta anche dove ha perso il nostro braccio.
Altri quattro punti, in breve. Due sovra-applicazioni, cioè correzioni giuste fatte nel momento sbagliato. Quattro regole mai recuperate, ognuna di una famiglia verso cui il ticket non puntava, che spiegano quattro delle sette deviazioni del nostro braccio. Sei task con consegna degradata per un errore di autenticazione e un'interruzione del canale, contati contro di noi invece che esclusi. Tredici falsi positivi sulle guardie dei comandi.
Il suo è l'esperimento migliore, il nostro è il caso più duro. Lui ha isolato la struttura in modo pulito, con un bersaglio privo di istinto concorrente; noi abbiamo scelto bersagli fatti solo di istinto concorrente, e per farlo abbiamo rinunciato alla potenza statistica. Messi insieme dicono una cosa semplice: non è la struttura del file a fallire, e le regole su cui un file fallisce sono proprio quelle per cui lo hai scritto.
Che cosa vendiamo, detto senza giri di parole
L'injection agent-time è il nostro prodotto, questo studio la misura, e lo stesso studio dice anche che cosa non sa fare.
VibeDefend si installa nell'ambiente dell'agente, non nel tuo repository. Un hook scatta prima di ogni modifica di file e mette nel contesto del modello le regole che riguardano quel file e quell'intento, subito prima della scrittura. Sui 30 task ha significato 669 injection di regole di business e 1.078 injection di regole di sicurezza, per circa un dollaro a ticket.
Quello che non fa è imporle. Il task M24 sta in questo articolo proprio perché segna il confine più netto di ciò che vendiamo. La parte deterministica del layer è la guardia sull'azione, non la regola nel contesto, e preferiamo dire quale delle due è un controllo piuttosto che far credere che lo siano entrambe. Il quadro completo è in sicurezza degli agenti di codice AI.
Domande frequenti
Claude Code rispetta davvero il CLAUDE.md?
Lo legge a ogni avvio di sessione e lo segue a intermittenza, con l'intermittenza concentrata sui valori precisi. La documentazione di Anthropic dice che Claude tratta questi file come contesto e non come configurazione imposta, e che non esiste nessuna garanzia di rispetto rigoroso. Nel nostro studio su 90 run autonomi, una sezione di regole realistica ha prodotto tanti dettagli implementati alla lettera quanti ne ha prodotti un repository senza nessun file di regole: 7 su 55. E sulle 13 regole in cui il valore giusto era scritto per esteso nel file, l'agente lo ha riprodotto esattamente 4 volte.
Come si scrive un buon CLAUDE.md?
Ordinando le regole in base a quanto il modello può indovinarle, e smettendo di limare la struttura del file. L'unico test fattoriale diretto, su 1.650 sessioni di Claude Code, non ha trovato effetti rilevabili né della dimensione del file, né della posizione dell'istruzione, né della divisione in più file, né delle contraddizioni con i file vicini, e un'istruzione alla riga 2 non ha reso più della stessa istruzione alla riga 250. Nel file tieni quello che un ingegnere competente applicherebbe comunque, porta i valori arbitrari nel momento in cui si scrive il codice, e trasforma in hook tutto ciò che non deve mai accadere.
Che cosa deve contenere un CLAUDE.md?
Comandi di build, struttura del progetto, convenzioni di casa e tutto ciò che l'agente non produrrebbe mai da solo: è questa la classe che lo studio meglio dimensionato ha misurato, e qui il file fa il suo lavoro. Fuori restano i dettagli arbitrari, codici di errore, formati dei nomi di file, soglie. Sulle 13 regole in cui il nostro file portava il valore esatto nero su bianco, l'agente lo ha implementato alla lettera 4 volte.
Quanto deve essere lungo un CLAUDE.md?
Quanto il tuo budget di contesto sopporta, ma non è la lunghezza a decidere se una regola viene rispettata. Anthropic consiglia di restare sotto le 200 righe per file, e sfoltire un file gonfio è buona igiene. Lo studio fattoriale non ha però trovato nessun effetto rilevabile della dimensione, con un fattore di Bayes a favore del nullo: non aspettarti che accorciare il file cambi le probabilità che una certa regola arrivi viva fino alla scrittura.
Claude Code legge AGENTS.md o solo CLAUDE.md?
Solo CLAUDE.md, a meno che non sia tu a collegarlo. La documentazione di Anthropic è esplicita nel dire che Claude Code legge CLAUDE.md e non AGENTS.md, e indica come ponti supportati un import @AGENTS.md oppure un symlink. Nessuno dei due file è migliore dell'altro, perché il meccanismo è identico, un documento caricato in contesto all'avvio della sessione, e quindi è identica anche la modalità di fallimento.
Perché Claude Code non segue le mie regole?
Più che ignorarle, le diluisce. Il file viene caricato una volta sola e alla trentesima modifica è un frammento vecchio, sepolto sotto decine di migliaia di token fra codice, output di comandi e ragionamento. Lo studio fattoriale di Damon McMillan misura la stessa cosa dall'altro lato: ogni funzione in più generata dall'agente si associa a un calo di circa il 5,6% delle probabilità di conformità. La seconda causa è la tua codebase, che mostra all'agente come si fa qui e per giunta compila.
Il CLAUDE.md serve davvero a qualcosa?
Per una classe di regole sì, e proprio per quella che ti ha spinto a scriverlo no. McMillan misurava un'annotazione banale, che l'agente non ha nessun motivo di emettere se il file non la chiede, e lì il file porta la conformità da quasi zero a qualcosa. Noi abbiamo preso il caso opposto, cioè regole per cui l'agente ha già una sua risposta plausibile, e una sezione di regole realistica ha totalizzato esattamente quanto l'assenza di file: 7 dettagli su 55.
Il CLAUDE.md va committato nel repository?
Sì, e poi va riletto come si rilegge il codice, perché chi può fare commit lì dentro sta scrivendo la policy del tuo agente. Committarlo però non vuol dire imporlo: la sezione di regole del nostro studio stava nel repository e veniva caricata a ogni avvio di sessione, e il codice che ne è uscito era indistinguibile da quello del braccio senza nessun file di regole.
Karpathy ha davvero misurato errori in calo dal 40% all'11% con un CLAUDE.md?
Di quel numero non abbiamo trovato nessuna fonte primaria. Circola nei thread social e nelle riprese di seconda mano, in più di una versione, dal 40% o dal 41% all'11%, senza metodo pubblicato e senza una dimensione del campione verificabile. Le misure che hanno dietro un paper o un protocollo sono meno lusinghiere: McMillan non ha trovato effetti rilevabili delle quattro variabili di struttura su 1.650 sessioni, e i nostri 90 run mettono un file di regole realistico alla pari con l'assenza di file.
Come si impone davvero una regola in Claude Code?
Non con la prosa. Anthropic indica l'hook PreToolUse per bloccare un'azione a prescindere da ciò che Claude decide, e le impostazioni gestite per i permessi, dato che le regole delle impostazioni le applica il client, sempre a prescindere da ciò che Claude decide di fare. Una regola che non puoi permetterti di perdere appartiene a un hook o a un permesso. Una regola su cui vuoi che l'agente ragioni appartiene al suo contesto, nell'istante in cui scrive.


