


En esta página
- ¿Qué datos envía Codex a OpenAI?
- ¿OpenAI usa mi código para entrenar sus modelos?
- ¿Qué guarda Codex en mi máquina?
- ¿Codex te roba el código?
- ¿Cómo dejo los secretos y el código regulado fuera del alcance de Codex?
- Lo que no cubre ningún ajuste de privacidad
- Preguntas frecuentes
- ¿Es seguro usar Codex con el código de mi empresa?
- ¿Codex envía mi código a OpenAI?
- ¿Codex usa mi código para entrenar los modelos de OpenAI?
- ¿Cómo evito que Codex use mi código para entrenar?
- ¿Codex guarda un historial en mi máquina?
- ¿Puede Codex leer mi archivo .env?
- Codex y RGPD: ¿se pueden quedar mis datos en Europa?
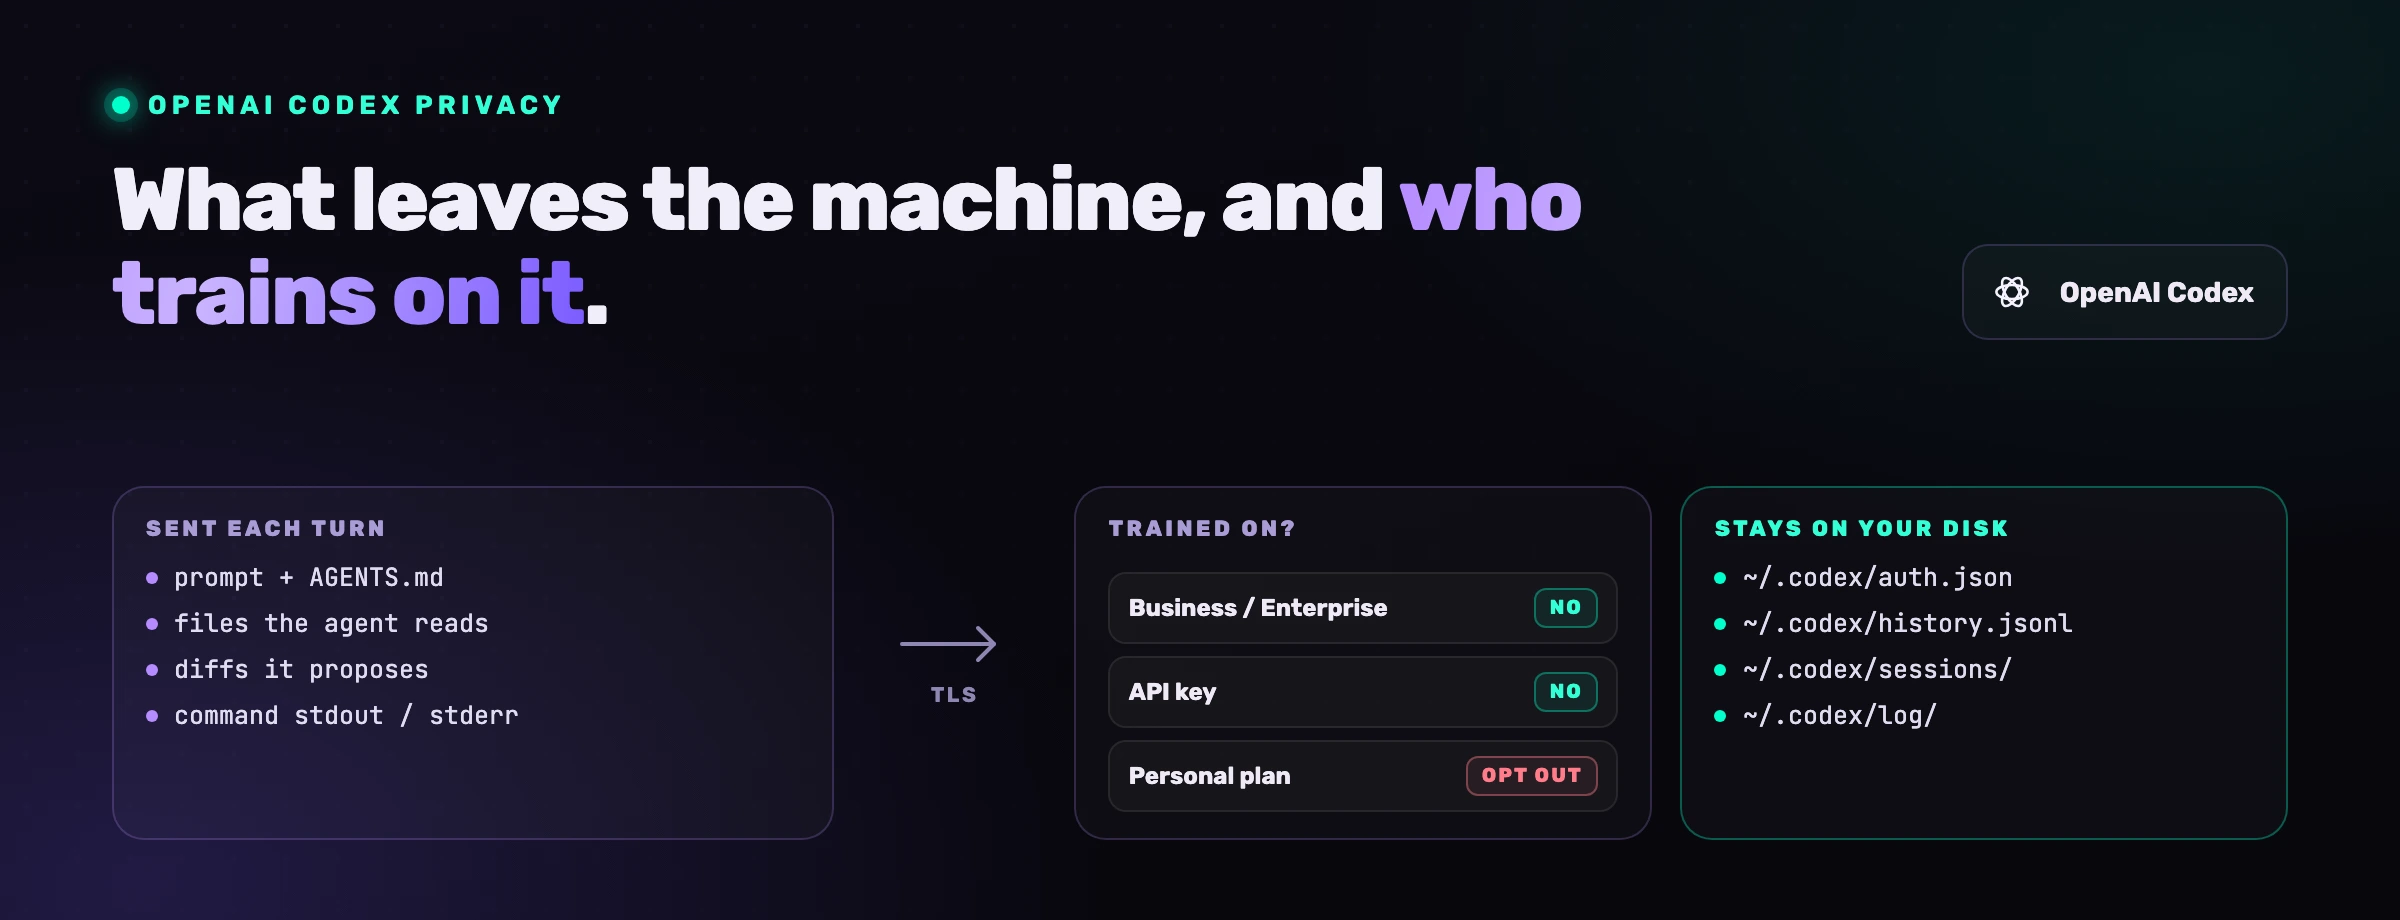
¿Es seguro usar Codex con tu código? La respuesta empieza por un hecho que conviene asumir cuanto antes: sí, Codex envía código a OpenAI. El prompt, los archivos que el agente decide leer, los diffs que propone y la salida de los comandos que ejecuta viajan a los modelos de OpenAI, porque así funciona un agente de código. Lo que de verdad importa son preguntas más concretas: qué sale exactamente de tu máquina, qué se queda en ~/.codex, si OpenAI entrena con ello (depende de cómo hayas iniciado sesión), qué se conserva y durante cuánto tiempo, y qué ajustes dejan los secretos y el código regulado fuera del alcance del agente. Aquí va cada respuesta, con el ajuste que la controla.
¿Qué datos envía Codex a OpenAI?
Codex envía a OpenAI todo lo que necesita para razonar sobre la tarea y nada de lo que no ha abierto. Lo enseña la propia OpenAI en su artículo de ingeniería sobre el bucle del agente de Codex: en cada turno, la CLI manda a la API Responses el prompt que has escrito, los archivos de instrucciones como AGENTS.md, una breve descripción del entorno (directorio de trabajo y shell) y la salida de todas las llamadas a herramientas hechas hasta ese momento. Por esa última vía viajan el contenido de los archivos que el agente ha decidido leer, los diffs que propone, el stdout y el stderr de los comandos que ha ejecutado y lo que esos comandos muestren del repositorio (rutas, estado de git, estructura). En Codex cloud, Codex crea un contenedor y hace checkout de tu repositorio en la infraestructura de OpenAI, de modo que todo lo que hay en ese checkout entra en juego.
La otra cara es la que te interesa: un archivo que el agente no ha leído no sale de tu máquina. Por eso la palanca real de privacidad es el alcance, es decir, qué puede abrir el agente y qué se le ha dicho que no abra.
| Forma de uso | Qué sale de tu máquina | Dónde se ejecuta el modelo | Qué condiciones se aplican |
|---|---|---|---|
| CLI o extensión del IDE, con sesión de ChatGPT | Prompt, archivos leídos, diffs, salida de comandos, metadatos | En OpenAI, dentro de tu workspace de ChatGPT | Las de tu plan de ChatGPT (personal o Business/Enterprise/Edu) |
| CLI o SDK, con clave de API | Lo mismo, más la telemetría opcional que configures | En la API de OpenAI | Los controles de datos de la API (sin entrenamiento por defecto) |
| Codex cloud | La tarea y el repositorio entero, que se descarga de tu servidor Git al contenedor | En un sandbox alojado por OpenAI | Las de tu plan de ChatGPT |
codex exec en local, dentro de CI | Lo mismo que la CLI, sin nadie delante | En OpenAI | Las de la credencial que use el runner |
Hay dos pasajeros con los que casi nadie cuenta. El primero son las variables de entorno: el shell en el que el agente lanza los comandos las ve, así que una DATABASE_URL o una AWS_SECRET_ACCESS_KEY exportada en ese shell puede asomar en la salida de un comando y viajar con ella. La shell_environment_policy de Codex decide qué variables llegan a ese shell, y no quita ninguna hasta que se lo pides: según la referencia de configuración de OpenAI, las variables cuyo nombre contiene KEY, SECRET o TOKEN se conservan por defecto.
El segundo son las búsquedas. Con web_search en live (el flag --search), las consultas que redacta el modelo también salen hacia fuera. El modo por defecto, cached, se apoya en un índice que mantiene OpenAI y no accede a la web externa, aunque la misma referencia avisa de que con --yolo, o con cualquier otro ajuste de sandbox de acceso total, ese valor por defecto pasa a ser live.
¿OpenAI usa mi código para entrenar sus modelos?
Depende de la cuenta con la que hayas iniciado sesión, no de si usas la CLI, la extensión o Codex cloud. La política de uso de datos de OpenAI trata a Codex como al resto de sus productos, con los servicios para particulares a un lado y los servicios para empresas al otro, y una sola particularidad: un interruptor que solo existe en Codex.
| Cómo usas Codex | ¿Entrena por defecto? | Cómo se cambia |
|---|---|---|
| Workspace de ChatGPT Business, Enterprise o Edu | No, según la página de privacidad empresarial de OpenAI | Controles del administrador del workspace; solo si se activa expresamente |
| Clave de API (CLI o SDK de Codex) | No. Los controles de datos de la API de OpenAI lo formulan así: «desde el 1 de marzo de 2023, los datos enviados a la API de OpenAI no se usan para entrenar ni mejorar los modelos de OpenAI (salvo que elijas expresamente compartir tus datos con nosotros)» | Solo si lo activas expresamente |
| Plan personal (Free, Go, Plus, Pro) | Puede, salvo que lo desactives | En la configuración de ChatGPT, Controles de datos, «Mejorar el modelo para todos»; o en el portal de privacidad de OpenAI. Con una de las dos vías basta |
| Entornos completos de Codex (planes personales) | Tiene su propio control | En la configuración de Codex, el interruptor de entrenamiento con entornos completos |
La última fila es la que se le escapa a casi todo el mundo. Según las preguntas frecuentes de OpenAI sobre los controles de datos, en un plan personal el ajuste «Mejorar el modelo para todos» vale también para tus tareas de Codex, pero el entrenamiento con entornos completos se gobierna con un ajuste distinto, en la configuración de Codex, y ni tu ajuste de ChatGPT ni el portal de privacidad lo tocan. Ninguna de las dos páginas dice qué valor trae por defecto ese ajuste de Codex. El caso típico es el de alguien con un plan Plus que desactivó «Mejorar el modelo para todos» hace años y da el tema por zanjado, sin nada que le garantice que Codex fue detrás. Son dos interruptores: revisa los dos.
Hay una excepción que sobrevive a la desactivación, y la política de uso de datos enlazada más arriba la recoge: si envías una valoración sobre una respuesta, un pulgar arriba o abajo por ejemplo, toda la conversación asociada puede usarse para entrenar.
¿Qué guarda Codex en mi máquina?
Más de lo que la mayoría imagina: por defecto, Codex escribe en tu disco el historial de tus sesiones, además de tus credenciales. La guía de configuración avanzada de OpenAI enumera lo que vive en ~/.codex, y conviene conocer los archivos por su nombre:
config.toml: tus ajustes.auth.json: las credenciales en caché, cuando se usa el almacenamiento en archivo (si no, van al llavero del sistema).history.jsonl: lo que la guía llama transcripciones de sesión, activado por defecto.log/: los logs.
A esa lista se suma sessions/, donde Codex conserva cada hilo de trabajo en un archivo que puede reproducir y retomar.
Los que cuentan para la privacidad son history.jsonl y sessions/. Entre los dos guardan tus prompts, las respuestas del agente y la salida de sus comandos, con cualquier fragmento de código o secreto que haya pasado por ellos, y siguen en el disco hasta que los borras.
Lo que se queda en local y lo que se exporta se decide en config.toml:
# No escribir el historial de sesiones en ~/.codex/history.jsonl
[history]
persistence = "none"

# Sin exportación de logs por OpenTelemetry; los prompts en bruto, nunca
[otel]
exporter = "none"
log_user_prompt = false

# Quitar las credenciales del shell que usa el agente
[shell_environment_policy]
ignore_default_excludes = false  # quita también los nombres que contienen KEY, SECRET o TOKEN

[shell_environment_policy.filters]
"AWS_*" = "exclude"
"DATABASE_URL" = "exclude"

# Analítica de la máquina
[analytics]
enabled = false
Un matiz: nada de este bloque cambia lo que recibe el modelo, solo lo que tu máquina escribe y reenvía. Y tres precisiones que salen de la documentación de OpenAI. history.persistence = "none" detiene history.jsonl y nada más: los archivos de sessions/ son un mecanismo aparte, la referencia de configuración no documenta ninguna clave para ellos, y la única forma documentada de evitarlos es codex exec --ephemeral, que se ejecuta sin escribirlos. La tabla filters es la forma actual de shell_environment_policy; el antiguo array exclude sigue funcionando, pero la referencia ya lo marca como heredado, y Codex rechaza que mezcles los dos. Y la exportación de logs por OpenTelemetry viene desactivada, de modo que no se exporta nada mientras no lo configures, con otel.log_user_prompt como activación expresa: solo si la enciendes se incluyen los prompts en bruto.
Quedan otros dos canales, los dos activos por defecto: las métricas anónimas de uso y de estado, que según OpenAI no contienen datos que te identifiquen y que se apagan con analytics.enabled = false, y el comando /feedback (feedback.enabled).
¿Codex te roba el código?
No, y la pregunta merece una respuesta exacta, no una que solo tranquilice. Codex transmite tu código a OpenAI en las condiciones del plan con el que has iniciado sesión, y esas condiciones son públicas: es un flujo de datos que aceptaste, no un robo.
Si la pregunta se busca tanto es por dos incidentes, y en ninguno fue Codex quien se llevó el código:
codexui-android, una interfaz web remota para Codex publicada en npm, que funcionaba de verdad, con desarrollo activo y unos pocos miles de descargas cada semana. Como informó The Hacker News el 1 de junio de 2026, sus versiones publicadas llevaban cerca de un mes leyendo~/.codex/auth.jsonen cada arranque y enviándolo al servidor de un atacante, con un código que nunca estuvo en el repositorio de GitHub.- Un fallo de inyección de comandos en el entorno cloud de Codex, descubierto por BeyondTrust Phantom Labs y recogido por The Hacker News en marzo de 2026: un nombre de rama manipulado permitía robar el token de GitHub que usa Codex, y BeyondTrust señala como afectados la web de ChatGPT, la CLI de Codex, el SDK y la extensión del IDE. OpenAI ya lo ha corregido.
Los dos siguen el mismo patrón: el robo iba a por las credenciales que rodean a Codex, y quien atacaba era un tercero. Ahí es donde tienes que mirar. La guía de autenticación de OpenAI pide tratar ~/.codex/auth.json como una contraseña, y con cli_auth_credentials_store = "keyring" los tokens pasan al llavero del sistema, de modo que el archivo deja de estar ahí para que alguien lo lea. Revisa lo que instalas, sabiendo que un repositorio limpio no demuestra nada sobre el paquete que sirve de verdad el registry, y ante cualquier complemento para Codex desconfía como de una extensión del navegador que te pide la contraseña.
Queda una tercera vía para perder código, la única de la que nadie escribe un informe de incidente: una prompt injection dentro de un repositorio que has clonado, que le pide al agente que mande tus archivos a otra parte con curl, en una sesión con la red abierta. Justo por eso el sandbox workspace-write de Codex mantiene la red cerrada por defecto, y la guía de OpenAI sobre el sandbox y las aprobaciones lo dice sin rodeos: por defecto, el agente se ejecuta con el acceso a la red desactivado. En nuestra guía sobre los flags de sandbox y de aprobación de Codex explicamos cuáles la abren y cuándo es aceptable abrirla.
¿Cómo dejo los secretos y el código regulado fuera del alcance de Codex?
Con dos ideas: que el agente pueda abrir menos, y que lo que abra no tenga nada que llevarse. De mayor a menor impacto:
- Ningún secreto en archivos que el agente pueda leer. Un
.envcon claves en vigor, unconfig/production.ymlcon la contraseña de la base de datos, uncredentials.jsonen el árbol: si está en el workspace, el agente puede leerlo, y de ahí puede acabar en el historial de una sesión. Usa un gestor de secretos e inyéctalos en tiempo de ejecución. - Limpia el shell. Una
shell_environment_policyconignore_default_excludes = falsey entradasfiltersenexcludepara claves, tokens y cadenas de conexión impide que la salida de un comando los filtre. - La red, cerrada. Deja
sandbox_workspace_write.network_accessenfalse. Si una tarea necesita de verdad el registry, ábrela solo para esa ejecución con-c. - Marca como no confiable el repositorio que no conoces. Con
projects."<path>".trust_level = "untrusted", la referencia de configuración de OpenAI indica que Codex se salta las capas.codex/que trae el propio repositorio, con su configuración local, sus hooks y sus reglas, y un proyecto clonado no puede reconfigurar el agente en tu contra. - Sin historial local en máquinas compartidas o reguladas.
history.persistence = "none", más una limpieza programada de~/.codex/sessions/, que esa clave no cubre. En CI, usacodex exec --ephemeral. - Elige la forma de uso según los datos. Para código bajo NDA, una base de código regulada o cualquier cosa con datos de clientes en los fixtures: workspace Business o Enterprise, o clave de API. Si usas la API y tus obligaciones son más estrictas, los controles de datos de la API de OpenAI documentan tres cosas. Los registros de supervisión de abusos se conservan «hasta 30 días» por defecto, o más si la ley lo exige. La opción Zero Data Retention deja el contenido del cliente fuera de esos registros en los endpoints que la admiten (entre ellos
/v1/responses), y OpenAI la concede previa aprobación, no con solo pedirla. La residencia de datos también está sujeta a elegibilidad: su región de Europa (EEE y Suiza) exige Zero Data Retention u otro de los controles de retención reducida de OpenAI, y no cubre los datos de sistema, como los metadatos de cuenta y de uso. - Escanea los secretos antes de que los vea el agente. La clave metida en un commit que un escáner te señala hoy es una clave que la próxima sesión ya no cargará en su contexto.
Lo que no cubre ningún ajuste de privacidad
Todo lo anterior controla lo que Codex lee y transmite. Nada de ello controla lo que Codex escribe, y ese código es, por sí solo, otro frente de privacidad. Piensa en un agente que deja incrustado en el código un token que vio en un fixture, que manda a los logs el cuerpo entero de una petición con un número de tarjeta dentro, o que devuelve la ficha de un usuario con campos que quien la pide nunca tuvo permiso para ver. Ha creado un problema de protección de datos que ninguna política de retención va a arreglar, porque la fuga ya está en tu repositorio y en tus logs de producción.
Esa es la capa que añade VibeDefend, en agent-time. Trabaja dentro del bucle de Codex: contrasta con tus reglas el diff que el agente está a punto de escribir, y el secreto incrustado, la línea de log que cuenta demasiado o la comprobación de autorización que falta se reescriben antes de llegar al repositorio. Su guardia decide en local, en tu máquina; su telemetría son solo metadatos estructurados; y su análisis corre sobre modelos autoalojados, en la región UE o EE. UU. que elijas al instalar, sin ninguna API de LLM de terceros y sin que tu código se use para entrenar un modelo. En nuestro estudio controlado, el agente que llevaba esta capa aplicó la regla exacta en el 89 % de los casos (57 de 64 reglas evaluadas), frente al 12 % sin ninguna herramienta y al 13 % con un archivo de reglas mantenido a mano en el repositorio.
La privacidad es solo una parte. Para el resto (sandbox, supply chain, riesgos de la autonomía) tienes la guía completa de seguridad de OpenAI Codex. Y si tu equipo está adoptando Codex sobre código que no puede salir de casa, hablemos: esta configuración la hemos hecho muchas veces.
Preguntas frecuentes
¿Es seguro usar Codex con el código de mi empresa?
Puede serlo, si eliges bien la identidad y la configuración: una forma de uso que no entrena (Business, Enterprise o clave de API), los secretos fuera del workspace, la red cerrada, los repositorios que no conoces marcados como no confiables y el historial local desactivado cuando la máquina es compartida. Lo que queda por cubrir es el código que escribe el agente, y eso pide una capa de revisión propia.
¿Codex envía mi código a OpenAI?
Sí. En cada turno viajan a los modelos de OpenAI el prompt, los archivos que lee el agente, los diffs que propone, la salida de los comandos y los metadatos del repositorio; en Codex cloud, el repositorio entero se descarga a un contenedor alojado por OpenAI. Lo que el agente no abre no se envía, y por eso limitar su alcance es la principal palanca de privacidad.
¿Codex usa mi código para entrenar los modelos de OpenAI?
Con un workspace de ChatGPT Business, Enterprise o Edu, o con una clave de API, por defecto no. Con un plan personal puede usarlo mientras no lo desactives: se aplica a Codex tu ajuste «Mejorar el modelo para todos» de ChatGPT, y Codex tiene además, en su propia configuración, un interruptor de entrenamiento con entornos completos que también debes revisar.
¿Cómo evito que Codex use mi código para entrenar?
En un plan personal son dos pasos. Primero desactiva «Mejorar el modelo para todos» en Controles de datos (o hazlo desde el portal de privacidad de OpenAI). Después entra en la configuración de Codex y apaga el control de entrenamiento con entornos completos, porque el primer paso no cambia el segundo. La alternativa es iniciar sesión con un workspace Business o Enterprise, o con una clave de API, donde el entrenamiento viene desactivado por defecto.
¿Codex guarda un historial en mi máquina?
Sí, por defecto. El historial de las sesiones se escribe en ~/.codex/history.jsonl, y junto a él están las credenciales en ~/.codex/auth.json (salvo que uses el llavero del sistema), un archivo reproducible por sesión en ~/.codex/sessions/ y los logs en ~/.codex/log/. Poner history.persistence = "none" en config.toml solo detiene history.jsonl: los archivos de sesión necesitan su propia limpieza, o codex exec --ephemeral en las ejecuciones por script.
¿Puede Codex leer mi archivo .env?
Sí, si el archivo está en el workspace y el modo de sandbox permite leer, y tanto read-only como workspace-write lo permiten: lo único que confinan son las escrituras. Deja los secretos en vigor fuera del árbol y usa shell_environment_policy para quitarlos del shell en el que el agente ejecuta los comandos.
Codex y RGPD: ¿se pueden quedar mis datos en Europa?
Para el uso por API, OpenAI documenta regiones de residencia de datos que incluyen Europa (EEE y Suiza), además de una opción Zero Data Retention en los endpoints que la admiten y de una retención por defecto de hasta 30 días para la supervisión de abusos. Las dos opciones dependen de la elegibilidad y de la aprobación de OpenAI, la región de Europa exige un control de retención reducida como Zero Data Retention, y la residencia no cubre los datos de sistema. La residencia ayuda con el RGPD, pero no lo resuelve sola. Dónde se tratan los datos de tu workspace de ChatGPT depende de tu contrato: si tu carga está regulada, confírmalo con OpenAI.


