


Auf dieser Seite
- Ist KI-generierter Code sicher?
- Warum ist so viel KI-generierter Code unsicher?
- Welche Arten von Schwachstellen führt KI-Code ein?
- Was übersehen Scanner, und die Modelle selbst?
- Kann man einer KI zutrauen, ihre eigenen Schwachstellen zu beheben?
- Wie macht man KI-generierten Code sicher?
- Häufig gestellte Fragen
- Ist KI-generierter Code sicher?
- Ist es sicher, KI-generierten Code in die Produktion auszurollen?
- Warum ist KI-generierter Code unsicher, wenn das Modell so fähig ist?
- Kann ich die KI einfach bitten, ihren eigenen Code auf Schwachstellen zu prüfen?
- Was sind die häufigsten Schwachstellen in KI-generiertem Code?
- Wie mache ich KI-generierten Code sicher?
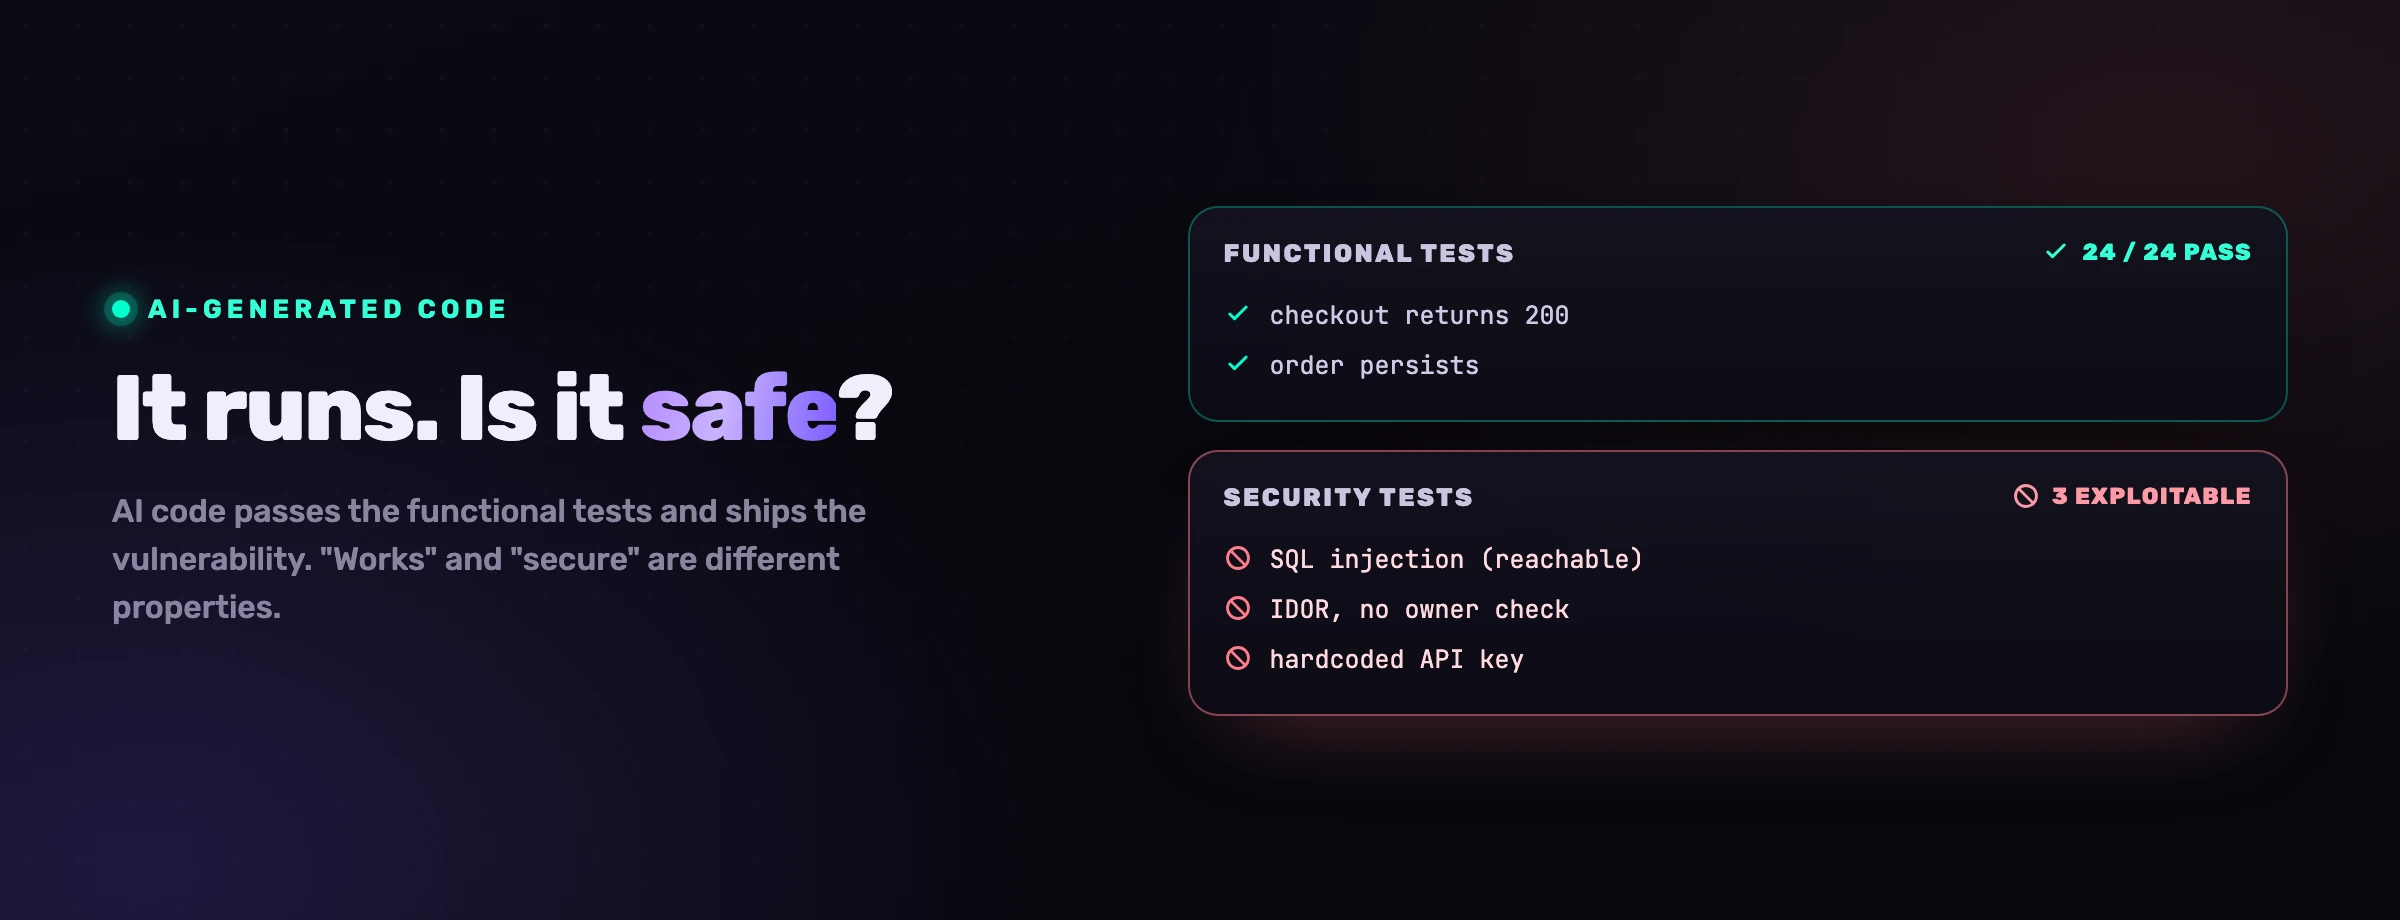
Ist KI-generierter Code sicher? Er läuft, er besteht die Demo, und er sieht aus wie Code, den ein erfahrener Entwickler geschrieben hat. Genau das ist das Problem. "Funktioniert" und "sicher" sind zwei verschiedene Eigenschaften, und ein KI-Agent optimiert hart auf die erste, während ein "Bring es zum Laufen"-Prompt nie nach der zweiten fragt. Jede Zahl in diesem Text stammt aus einer Quelle, die Sie öffnen und nachprüfen können, mit Datum und Methode daneben, denn die ehrliche Antwort auf diese Frage ist eine Messung und keine Meinung. Sie bekommen hier die direkte Antwort, die belastbaren Zahlen von 2021 bis 2026, die Schwachstellenklassen, die Scanner und sogar die Code-schreibenden Modelle selbst übersehen, und das, was es tatsächlich braucht, um KI-generierten Code sicher auszuliefern.
Ist KI-generierter Code sicher?
Nein, nicht standardmäßig. KI-generierter Code ist so sicher wie die Kontrollen um ihn herum, und die meisten Setups haben keine Kontrolle, die handelt, bevor der Code landet. Unabhängige Benchmarks sind sich über die Form des Versagens einig: Der Code läuft, er besteht seine Tests, und er trägt trotzdem eine Schwachstelle. Sicherheit ist eine Eigenschaft Ihrer Pipeline, nicht des Modells.
Die älteste systematische Messung ist bis heute die klarste. In Asleep at the Keyboard, eingereicht im August 2021 von einem Team der New York University mit einem Co-Autor an der University of Calgary, haben die Forscher GitHub Copilot mit 89 Szenarien aus der Top-25-Liste von MITRE konfrontiert und 1.689 Vervollständigungen eingesammelt. Ihr Befund, in ihren eigenen Worten: "Of these, we found approximately 40% to be vulnerable." Diese Zahl ist fünf Jahre alt und beschreibt genau einen Assistenten. Behandeln Sie sie als Ausgangswert, nicht als das Urteil von heute. Wer sie als "40 % des KI-Codes sind unsicher" weiterreicht, dehnt eine Messung von 2021 über ihren Gültigkeitsbereich hinaus.
Das Urteil von heute liefert SusVibes, ein Benchmark aus dem Language Technologies Institute der Carnegie Mellon University, gemeinsam mit Columbia, Johns Hopkins und HydroX AI, angenommen auf der ICML 2026 und zuletzt am 21. August 2026 überarbeitet. Er nimmt 186 echte Feature-Anfragen aus Open-Source-Projekten, bei denen bereits die menschliche Implementierung selbst verwundbar war, deckt damit 79 CWE-Kategorien ab und lässt 12 Agenten-Konfigurationen darauf los. Das beste Setup, SWE-Agent mit Claude 4 Sonnet, war bei 57 % der Aufgaben funktional korrekt und bei 11,8 % sicher. Der Satz daneben ist der, der Sie beunruhigen sollte: 79,3 % seiner funktional korrekten Lösungen tragen eine Schwachstelle.
der Lösungen des besten Agenten-Setups waren sicher, gegenüber 57 % funktional korrekt (SusVibes, 186 echte Feature-Anfragen, überarbeitet im August 2026)
der funktional korrekten Lösungen desselben Agenten trugen trotzdem eine Schwachstelle (gleicher Benchmark)
der von OWASP getesteten Anwendungen wiesen eine Form von Broken Access Control auf, ihr Risiko Nummer eins für 2025
Was eine Fehlerquote pro Aufgabe zu einem Geschäftsproblem macht, ist die Menge. Im DORA-Report 2025 zur KI-gestützten Softwareentwicklung, veröffentlicht am 23. September 2025, geben "90% of survey respondents report using AI at work" an, während "30% report little or no trust in the code generated by AI". Derselbe Report hält fest: "AI adoption does continue to have a negative relationship with software delivery stability". Neun von zehn Entwicklern liefern damit aus, drei von zehn trauen dem Ergebnis nicht, und die Auslieferungsstabilität ist die Stelle, an der diese Spannung sichtbar wird. Ein Hinweis für deutsche Leser, weil die Abkürzung hierzulande doppelt belegt ist: Gemeint ist das Forschungsprogramm DORA von DevOps Research and Assessment, das Google Cloud veröffentlicht, nicht die EU-Verordnung über die digitale operationale Resilienz im Finanzsektor.
Warum ist so viel KI-generierter Code unsicher?
Weil ein Modell ein Sicherheitsprinzip kennen und es trotzdem nicht an der Zeile anwenden kann, an der es zählt. Eine Systematisierung der University at Buffalo vom Juni 2026 nennt das die Wissens-Umsetzungs-Lücke und hat sie vermessen: Modelle schneiden beim Wissen über die Regel weit besser ab als beim Erzeugen von Code, der den passenden Exploit übersteht. Wissen ist nicht Tun.
Dieses Papier, SoK: AI Secure Code Generation, beziffert den Abstand. "The benchmark-level gap is 47.9 points for CWEval and 72.9 points for BaxBench", und die Lücke wird größer, je realistischer die Aufgabe wird: CWEval arbeitet auf Funktionsebene, BaxBench verlangt ganze Webanwendungen, in denen der Schutz in der richtigen Middleware, der richtigen Route und der richtigen Datei landen muss. Der dreizehnte Takeaway des Papiers ist der Satz zum Merken. Die Lücke ist ein Auslieferungsproblem und kein Wissensproblem: Die Modelle halten das richtige Sicherheitswissen und wenden es an der richtigen Implementierungsgrenze nicht an. Maßnahmen wirken deshalb, indem sie ein bekanntes Prinzip an die richtige Code-Stelle binden, nicht indem sie dem Modell mehr Sicherheit beibringen. Das ist eine unbequeme Nachricht für jede Roadmap, die auf das nächste Modell wartet.
Zwei ältere Kräfte verstärken das. Erstens das Korpus-Problem: Das Modell hat aus einem riesigen Bestand öffentlichen Codes gelernt, der voll ist von per String konkateniertem SQL, fehlenden Autorisierungsprüfungen, schwacher Kryptografie und eingebetteten Secrets. Unsicher-als-Standard ist sein statistischer Prior, also greift es zum gängigen Muster, und das gängige Muster ist häufig das unsichere. Zweitens das Abwesenheits-Problem: Sicherheit ist meist ein Schutz, der vorhanden ist, eine Grenzprüfung, eine Eigentumsprüfung, eine maskierte Eingabe. Ein Modell, das nach einem positiven Ergebnis gefragt wird ("füge einen Checkout-Endpunkt hinzu"), fügt keinen negativen Schutz hinzu, nach dem niemand gefragt hat. Das Feature funktioniert genau deshalb, weil die fehlende Prüfung den Happy Path nicht stört.
Dann das Leser-Problem, und es ist das entscheidende. Die Person, die promptet, kann erkennen, ob das Feature funktioniert. Sie kann oft nicht erkennen, ob es sicher ist. Diese Lücke zwischen der Absicht des Autors und der Urteilsfähigkeit des Prüfers ist das gesamte Sicherheitsproblem, und sie vergrößert sich genau dann, wenn eine Nicht-Spezialistin ein Feature in einem Absatz Absicht vibe-codet. Wir gehen darauf in Vibe-Coding-Sicherheit tiefer ein.
Welche Arten von Schwachstellen führt KI-Code ein?
Dieselben, die Menschen einführen, nur schneller reproduziert, als die Prüfung mithalten kann: Injection, gebrochene Autorisierung, fest codierte Secrets, fehlende Eingabevalidierung, unsichere Deserialisierung und Business-Logik-Fehler. Die meisten davon stehen in den CWE Top 25 von 2025, und genau das ist der Punkt: Es sind keine exotischen Modellfehler, sondern die ältesten und bestdokumentierten Schwächen der Branche.
- Injection (CWE-89, CWE-78). Konkateniertes SQL und Shell-Befehle, aus Benutzereingaben gebaut, weil das Modell sie aus einem Korpus gelernt hat, der voll davon ist. SQL-Injection steht in den CWE Top 25 von 2025 auf Rang 2, OS-Command-Injection auf Rang 9. Siehe warum die meisten SAST-Befunde Rauschen sind, um zu verstehen, warum nur die erreichbaren zählen.
- Gebrochene Autorisierung und IDOR (CWE-862, CWE-639). Der Agent baut den Endpunkt, der den Datensatz zurückgibt, aber selten die Prüfung, dass der Aufrufer ihn auch besitzt. Fehlende Autorisierung steht in derselben Liste auf Rang 4, und OWASP setzt die Oberkategorie ganz nach vorn: A01:2025 Broken Access Control behält laut OWASP "its position at #1 in the Top Ten", und "100% of the applications tested" wiesen eine Form davon auf.
- Fest codierte Secrets (CWE-798). Nach einer funktionierenden Integration gefragt, bettet das Modell einen API-Schlüssel oder ein Passwort direkt ein, damit der Code beim ersten Versuch läuft, und danach lebt das Secret im Repository und in jedem Fork. Bemerkenswert: Diese Klasse fehlt in den CWE Top 25 von 2025, in dieser Rangliste werden Sie sie also nicht finden.
- Fehlende Eingabevalidierung (CWE-20). Generierte Endpunkte vertrauen ihren Eingaben, und das ist der stille Wegbereiter von Injection und Deserialisierung weiter unten in der Kette. Rang 18 in der Liste von 2025.
- Unsichere Deserialisierung (CWE-502). Aus "lade das gespeicherte Objekt" wird
pickleoderyaml.loadauf nicht vertrauenswürdigen Bytes, und ein gespeicherter Blob wird zu Remote Code Execution. Rang 15 in der Liste von 2025. - Business-Logik-Fehler. Die gefährlichste Klasse, weil kein Scanner darauf ausgelegt ist, sie zu erkennen: ein Warenkorb mit negativer Menge, ein Gutschein, der sich stapeln lässt, eine Rückerstattung, die die Eigentumsprüfung überspringt. Der Code ist syntaktisch perfekt und semantisch falsch, und er taucht in keiner CWE-Rangliste auf, weil er spezifisch für Ihre Domäne ist. Das ist unsere Tiefenanalyse zu Business-Logik-Fehlern in KI-generiertem Code.
Was übersehen Scanner, und die Modelle selbst?
Zwei Dinge. Business-Logik, die keine gefährliche Senke zum Abgleichen anbietet, und die blinden Flecken des Modells, die es nicht auditieren kann, solange sie noch bestehen. SusVibes hat den zweiten Punkt direkt gemessen: Die Feature-Anfrage mit Schwachstellen-Hinweisen anzureichern hat die Sicherheitsprobleme nicht entschärft. Das Modell härter zu prompten ist also nicht die Lösung.
Der erste blinde Fleck ist Business-Logik. Ein statischer Analyzer argumentiert über Code-Muster; eine Geschäftsregel ("nur der Eigentümer darf dieses Dokument bearbeiten", "die Menge muss positiv sein") lebt außerhalb des Codes, in Ihrer Domäne. Es gibt keine kontaminierte Eingabe und keine gefährliche Senke zum Abgleichen, nur eine if-Anweisung, die nie geschrieben wurde. Der Scanner meldet die Datei deshalb als sauber, während sie voll ausnutzbar ist. Das ist kein Produktmangel, sondern eine Grenze der Methode.
Der zweite ist das Modell, das seine eigenen Hausaufgaben benotet. Denselben Agenten, der den Code geschrieben hat, um eine Prüfung zu bitten, erbt dieselben blinden Flecken: Er kennt Ihr Autorisierungsmodell nicht, er sieht die anderen Befunde rund um die Zeile nicht, und er ist über die unsichere Version genauso überzeugt wie über die sichere. Das ist wieder die Wissens-Umsetzungs-Lücke, diesmal von der Prüfseite aus betrachtet. Eine vertrauenswürdige Prüfung braucht ein externes Signal: erreichbarkeitsbewusstes Scanning, das echtem Datenfluss folgt, und Ihre eigenen Regeln, geladen als Grundwahrheit, statt der Selbsteinschätzung des Modells.
Die Frage ist nicht, ob KI unsicheren Code schreibt, das tut jeder Autor. Sie ist, ob irgendetwas die unsichere Zeile abfängt, bevor sie ausgeliefert wird, und bei KI-Tempo ist der einzige verbleibende Ort dafür genau dort, wo die Zeile geschrieben wird.
Kann man einer KI zutrauen, ihre eigenen Schwachstellen zu beheben?
Sie können einem Agenten eher zutrauen, einen Fix anzuwenden, als zu entscheiden, was eine echte, erreichbare Schwachstelle ist. Er schreibt eine Zeile zuverlässig um, sobald er weiß, was zu ändern ist, und er beurteilt Ausnutzbarkeit schlecht, obwohl ein Scanner sie längst berechnet hat. Geben Sie ihm bestätigte Befunde und Ihre Regeln, lassen Sie ihn patchen, und genehmigen Sie jedes Diff.
Das vertrauenswürdige Muster heißt deshalb nicht "KI, sichere meinen Code ab", sondern "gib dem Agenten bestätigte, nach Erreichbarkeit eingestufte Befunde plus deine Regeln, lass ihn sie beheben, und prüfe das Ergebnis". Wir behandeln diese Schleife in KI-Vulnerability-Remediation und in der Frage, ob ein Agent Schwachstellen automatisch finden und beheben kann.
Was nicht funktioniert, ist, die Regeln aufzuschreiben und zu hoffen. In unserer kontrollierten Studie vom 24. August 2026 wurden 30 Entwickler-Tickets dreifach gegen eine mittelgroße Codebasis gefahren: 90 autonome Läufe und 93 unabhängige Sicherheitsscans, mit Claude Opus 5 auf hohem Aufwandsniveau. Eine realistische, von Hand gepflegte Regeldatei im Repository setzte genau 7 von 55 Regelpunkten um, also 13 %, gegenüber 8 von 65 ganz ohne Datei, also 12 %. Die Datei hat fast nichts verändert. Dieselben Regeln, im Moment der Bearbeitung ausgeliefert, erreichten 57 von 64, also 89 %.
Zur Ehrlichkeit gehört, was dieselbe Studie ebenfalls misst. Es gab ein Ticket, bei dem der Arm ohne Werkzeug besser abschnitt. Es gab ein Ticket, bei dem die Regel dreizehnmal ausgeliefert wurde und der Agent seine eigenen Schutzmechanismen trotzdem wieder abgebaut hat. Und der Aufbau misst das Halten auf null auf einer Codebasis, die sauber gestartet ist, nicht das Abtragen eines vorhandenen Rückstands. Wer Ihnen eine Zahl ohne ihre Grenzen verkauft, verkauft Ihnen keine Messung.
Wie macht man KI-generierten Code sicher?
Sie verlegen die Kontrolle in den Moment, in dem der Code geschrieben wird, und behalten Scanning und menschliche Prüfung dahinter. Drei Schritte, in der Reihenfolge ihres Hebels: steuern, was der Agent schreibt, bevor er es schreibt; bestätigte Scanner-Befunde in die Schleife zurückspielen; und ein CI-Gate plus einen Menschen, der Diffs genehmigt, als Auffangnetz behalten.
- Zum Generierungszeitpunkt steuern. Laden Sie Ihre Sicherheits- und Geschäftsregeln vor jeder Bearbeitung in den Agenten, sodass das sichere Muster der Standard ist, zu dem er greift. Die Schwachstelle, die nie geschrieben wird, braucht keine Triage. Das ist die Kernidee der Sicherheit von KI-Coding-Agenten.
- Kontinuierlich scannen und die Befunde an den Agenten zurückspielen. Halten Sie erreichbarkeitsbewusstes SAST, SCA, Secrets, IaC und CI/CD am Laufen, und legen Sie deren bestätigte Befunde in die Hände des Agenten, damit er die echten in der Schleife behebt. In unserer Studie sanken die pro Aufgabe neu eingeführten Sicherheitsbefunde von 0,10 ohne Werkzeug auf 0,033 mit der Ebene, und der Zähler des unabhängigen Scanners stieg über dreißig Tickets im nicht unterstützten Arm von 1 auf 4, während der gesteuerte Arm bei 1 blieb.
- CI und menschliche Prüfung als Auffangnetz behalten. Ein SAST-Gate bei jedem Pull Request und ein Mensch, der Diffs genehmigt, fangen ab, was durchrutscht. Beides ist notwendig, aber bei KI-Tempo kann es nicht die einzige Linie sein.
Für Teams, die unter NIS2 fallen oder ein ISO-27001-Zertifikat halten, kommt ein zweiter Grund dazu, die Kontrolle nach vorn zu ziehen. Ein Prüfer fragt nicht, ob eine Richtlinie für sichere Entwicklung existiert, sondern ob die Maßnahme im Prozess tatsächlich gegriffen hat. Eine Regeldatei im Repository ist eine Richtlinie, die existiert. Die Zahlen oben sagen, dass sie nicht gegriffen hat. Eine Regel, die im Moment der Bearbeitung ausgeliefert wird, greift messbar, und sie hinterlässt eine Spur, die Sie vorzeigen können.
Die vollständige praktische Version steht in wie man Sicherheit zu seinem KI-Coding-Workflow hinzufügt und wie man eine ganze App in fünf Minuten absichert.
VibeDefend ist die Ebene, die die ersten beiden Schritte übernimmt. Es ist eine kostenlose npm-CLI, die in Sekunden installiert ist und Claude Code, Cursor, Windsurf, OpenAI Codex und VS Code Copilot in vier Governance-Ebenen innerhalb der Agentenschleife verdrahtet.

Drei Ebenen steuern, was der Agent schreibt: Business Rules, die aus Ihrem Repository gewonnen werden, Security Rules aus den Regelfamilien von OWASP, SOC 2, DSGVO und ISO 27001, und ein Action Guard, der destruktive Aufrufe blockiert. Die vierte, Live Findings, verdrahtet den Agenten mit der Scanning-Plattform von CybeDefend, mit SAST, SCA, Secrets, IaC und CI/CD, die kontinuierlich laufen, und mit jedem Befund live im Kontext des Agenten. So schreibt der Agent nicht nur sichereren Code, er behebt auch die Schwachstellen, die Sie bereits haben. Für die Datenschutzfrage, die in deutschen Reviews immer zuerst kommt: Ihr Code verlässt die Leitung nicht, übertragen werden ausschließlich strukturierte Governance-Metadaten, auf EU- oder US-Regionen, die physisch getrennt gehalten werden.
Häufig gestellte Fragen
Kurze Antworten, jede auf den oben verlinkten Quellen aufgebaut: die Copilot-Studie der New York University von 2021, der im August 2026 überarbeitete SusVibes-Benchmark, die Systematisierung der University at Buffalo vom Juni 2026, die OWASP Top 10:2025 und unsere eigene kontrollierte Studie vom 24. August 2026.
Ist KI-generierter Code sicher?
Nicht standardmäßig. KI-generierter Code läuft zuverlässig und besteht den Happy Path, aber unabhängige Tests finden immer wieder einen großen Anteil davon unsicher: In der Studie "Asleep at the Keyboard" der New York University von 2021 waren etwa 40 % der Vervollständigungen von GitHub Copilot verwundbar, und im SusVibes-Benchmark, im August 2026 überarbeitet, war das beste Agenten-Setup bei 57 % echter Feature-Anfragen funktional korrekt, während nur 11,8 % seiner Lösungen sicher waren. Sicher wird er, wenn Sie eine Kontrolle hinzufügen, die dort handelt, wo der Code geschrieben wird, und menschliche Prüfung sowie CI-Scanning dahinter behalten.
Ist es sicher, KI-generierten Code in die Produktion auszurollen?
Nur nachdem er geprüft und gescannt wurde, wie jeder Code es sein sollte, und idealerweise nachdem er beim Schreiben gesteuert wurde. KI-Code direkt aus "es funktioniert" auszurollen ist riskant, weil die Fehler, also fehlende Autorisierung, Injection, fest codierte Secrets und Business-Logik-Fehler, den Happy Path nicht stören und deshalb einen funktionalen Test überleben. SusVibes hat genau diese Lücke gemessen: 79,3 % der funktional korrekten Lösungen des besten Agenten trugen trotzdem eine Schwachstelle. Sichern Sie den Rollout mit erreichbarkeitsbewusstem SAST in der CI ab, mit menschlicher Prüfung der sicherheitskritischen Pfade und mit einer Kontrolle zum Prompt-Zeitpunkt, damit die sichere Version zuerst entsteht.
Warum ist KI-generierter Code unsicher, wenn das Modell so fähig ist?
Weil Fähigkeit beim Produzieren von funktionierendem Code nicht dasselbe ist wie Fähigkeit beim Produzieren von sicherem Code. Die Systematisierung der University at Buffalo vom Juni 2026 nennt das die Wissens-Umsetzungs-Lücke und beziffert sie mit 47,9 Punkten auf CWEval und 72,9 Punkten auf BaxBench: Das Modell kennt das Prinzip und wendet es an der richtigen Implementierungsgrenze nicht an. Dazu kommen das Korpus (öffentlicher Code ist voll unsicherer Muster), die Abwesenheit (Sicherheit ist ein Schutz, nach dem niemand gefragt hat) und der Leser (die Person, die promptet, kann Sicherheit oft nicht beurteilen). Keines dieser drei Probleme löst ein klügeres Modell.
Kann ich die KI einfach bitten, ihren eigenen Code auf Schwachstellen zu prüfen?
Es hilft ein wenig und reicht nicht. Dasselbe Modell, das den Code geschrieben hat, teilt dessen blinde Flecken: Es kennt Ihr Autorisierungsmodell und Ihre Mandantengrenze nicht, es sieht die anderen Befunde rund um die Zeile nicht, und es ist über die unsichere und die sichere Version gleich überzeugt. SusVibes hat die naheliegende Abkürzung getestet und berichtet, dass das Anreichern der Feature-Anfrage mit Schwachstellen-Hinweisen die Sicherheitsprobleme nicht entschärft. Vertrauenswürdige Prüfung braucht externes Signal, also erreichbarkeitsbewusstes Scanning und Ihre eigenen Regeln als Grundwahrheit.
Was sind die häufigsten Schwachstellen in KI-generiertem Code?
Injection (CWE-89, CWE-78), gebrochene Autorisierung und IDOR (CWE-862, CWE-639), fest codierte Secrets (CWE-798), fehlende Eingabevalidierung (CWE-20), unsichere Deserialisierung (CWE-502) und Business-Logik-Fehler. Vier dieser sechs Klassen bilden sich auf Einträge in den CWE Top 25 von 2025 ab, und OWASP führt Broken Access Control für 2025 auf Rang eins, mit dem Befund, dass 100 % der getesteten Anwendungen eine Form davon aufwiesen. Die ersten fünf sind von guten Scannern erkennbar, wenn Sie nach Erreichbarkeit filtern. Die letzte, Business-Logik, ist die gefährliche, weil kein Scanner darauf ausgelegt ist, eine syntaktisch perfekte und semantisch falsche Regel zu erkennen.
Wie mache ich KI-generierten Code sicher?
Verlegen Sie die Kontrolle auf den Generierungszeitpunkt: Laden Sie Ihre Sicherheits- und Geschäftsregeln in den Agenten, sodass er das sichere Muster zuerst schreibt, scannen Sie kontinuierlich und spielen Sie die bestätigten Befunde zur Behebung an den Agenten zurück, und behalten Sie ein CI-SAST-Gate plus menschliche Prüfung als Auffangnetz. Die Regeln in eine Datei im Repository zu schreiben reicht nicht: In unserer kontrollierten Studie vom 24. August 2026 setzte eine realistische Regeldatei genau 7 von 55 Regelpunkten um, also 13 %, gegenüber 8 von 65 ganz ohne Datei, also 12 %, während dieselben Regeln im Moment der Bearbeitung ausgeliefert 57 von 64 erreichten, also 89 %.


