


Auf dieser Seite
- Was bedeutet „Kontext“ für einen Coding-Agenten?
- Wo liegen die Grenzen von CLAUDE.md, AGENTS.md und Skills?
- CLAUDE.md: einmal gelesen, befolgt, wenn es gerade passt
- AGENTS.md: dieselbe Datei, nur für mehr Agenten
- Skills: geladen, wenn der Agent an sie denkt
- Was keines davon leistet
- Warum verliert der Agent die Regel, bevor er schreibt?
- CLAUDE.md, Rules, Skills, MCP oder Hooks: Was gehört wohin?
- Wie kommt eine Regel im Moment der Änderung beim Agenten an?
- Wo stößt die Eigenbau-Lösung an ihre Grenzen?
- Wie sieht die vollständige Methode aus?
- Schritt 1: Regeln aus dem eigenen Code extrahieren
- Schritt 2: Jede Regel von einem Menschen bestätigen lassen
- Schritt 3: Die richtige Regel an der Änderung liefern
- Schritt 4: Das Ergebnis am Ende der Kette prüfen
- Was ändert sich, wenn die Regel an der Änderung ankommt?
- Womit fangen Sie diese Woche an?
- Häufige Fragen
- Wie gebe ich Claude Code den Kontext meiner Codebasis?
- Skills oder Hooks in Claude Code: Was ist der Unterschied?
- Was unterscheidet Rules von Skills in Claude Code?
- Kann man in Claude Code Rules anlegen?
- Wofür braucht man Hooks in Claude Code?
- Mein PreToolUse-Hook läuft, aber Claude ignoriert die Ausgabe. Warum?
- Was bedeutet Context Engineering bei Coding-Agenten?
- Kann Claude Code eine CLAUDE.md automatisch erstellen?
- Liest Claude Code die AGENTS.md?
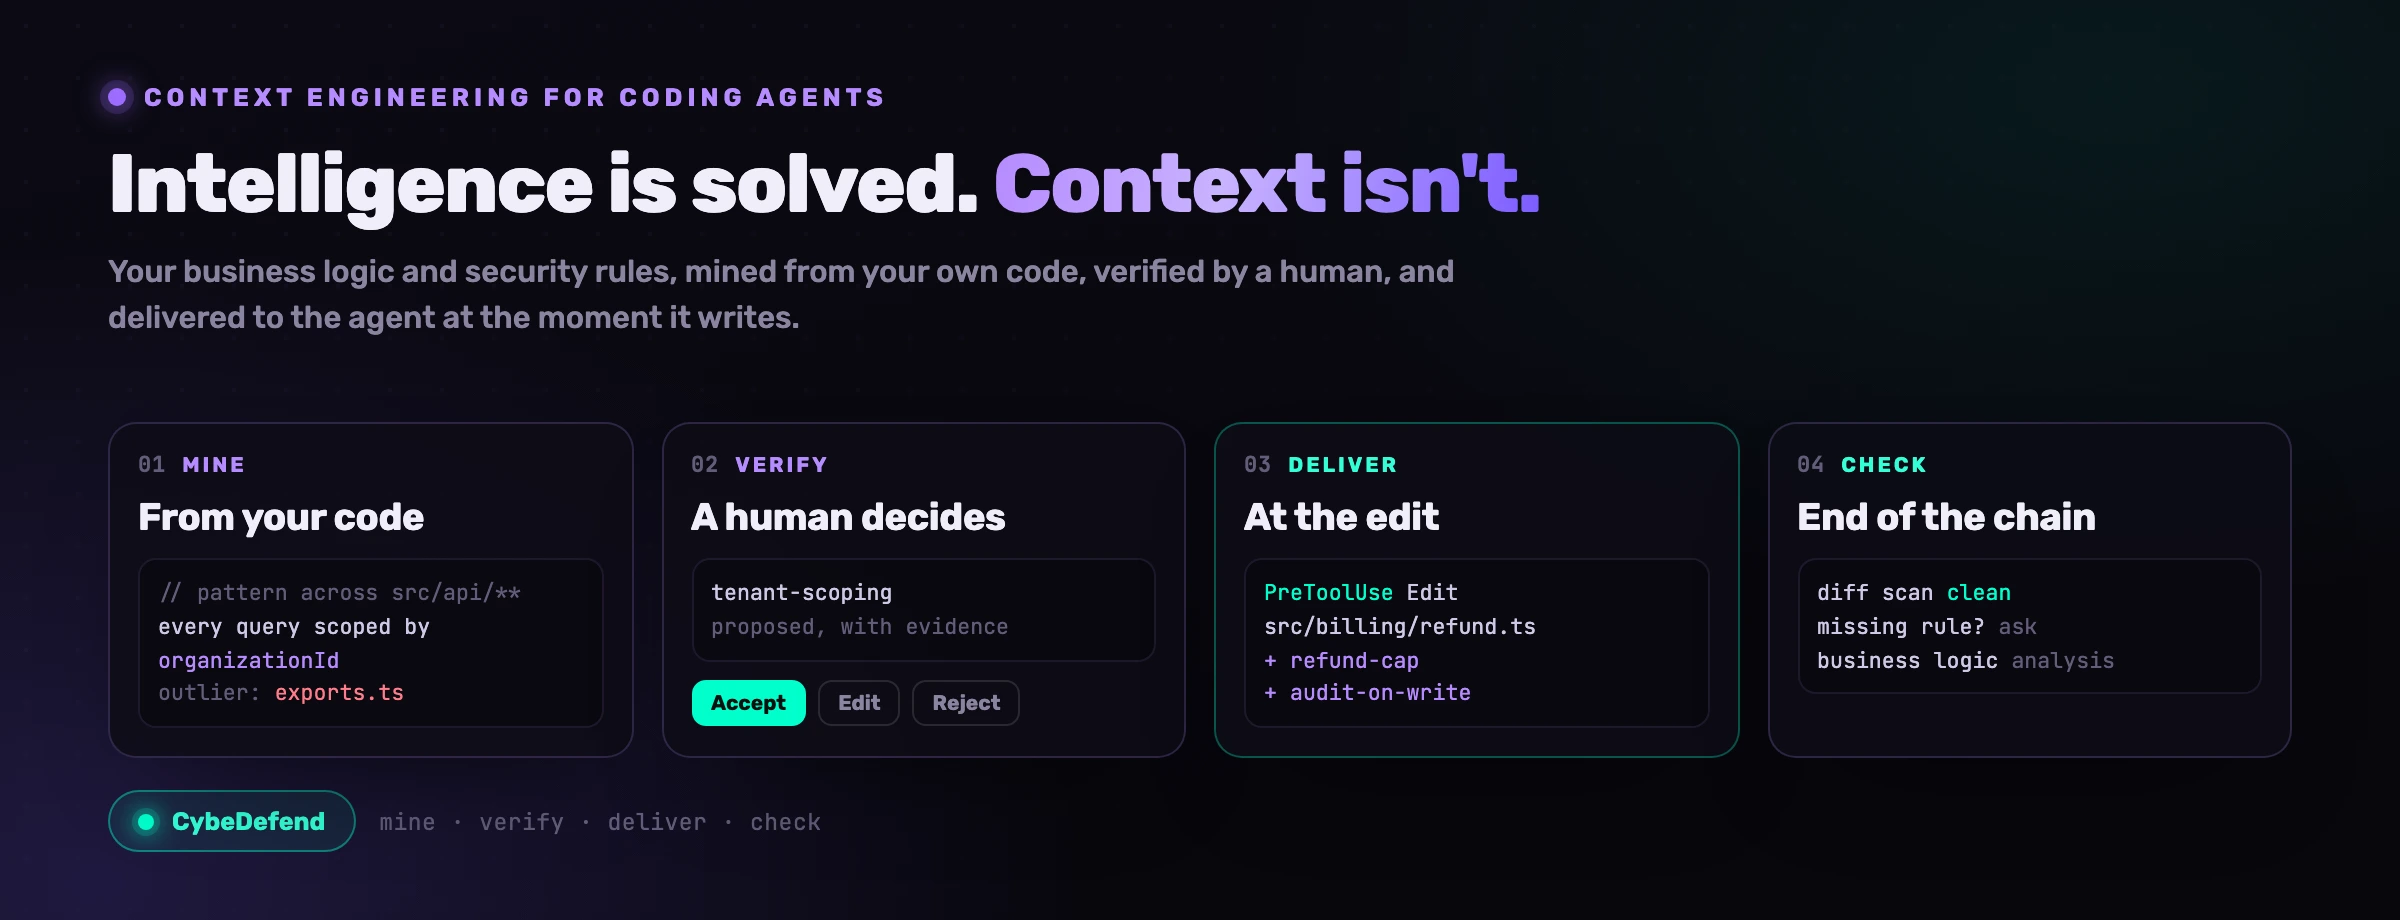
Einen Endpoint für Rückerstattungen schreibt Claude Code auch ohne Hilfe. Woher soll es aber wissen, dass Ihrer mit 422 REFUND_EXCEEDS_CAPTURED antwortet, bei jeder Erstattung ein Audit-Event mit der ID des Auslösers schreibt und niemals die Grenze von einem Mandanten zum nächsten überschreitet? Genau das ist Kontext: Ihre Geschäftslogik, die Namen, die Sie den Dingen geben, Ihre Sicherheitsregeln. Der Engpass ist heute nicht mehr die Intelligenz des Modells, sondern die Frage, wie dieser Kontext im Moment des Schreibens zu ihm gelangt. Dieser Leitfaden zeigt, wohin welche Art von Kontext gehört, liefert einen Hook, den Sie noch heute übernehmen können, und beschreibt die vierstufige Methode, mit der CybeDefend das für eine komplette Codebasis erledigt: Regeln aus Ihrem Code extrahieren, von einem Menschen bestätigen lassen, die passende Regel an der Änderung ausliefern, das Ergebnis prüfen.
Was bedeutet „Kontext“ für einen Coding-Agenten?
Alles, was das Modell über Ihr System wissen muss und aus dem Code vor seinen Augen nicht ableiten kann. Anthropic nennt die zugehörige Disziplin Context Engineering. Birgitta Böckeler, die auf der Website von Martin Fowler über Coding-Agenten schreibt, zitiert dafür die knappste Definition, die im Umlauf ist: „Context Engineering heißt, zu kuratieren, was das Modell sieht, damit Sie ein besseres Ergebnis bekommen.“ Arbeitet ein Coding-Agent an einem echten Produkt, besteht dieser Kontext aus drei Schichten.
Konventionen
Wie Code hier aussieht: die Muster des Frameworks, die Ordnerstruktur, der Befehl, mit dem die Tests laufen. Das meiste davon liest ein Modell aus dem umgebenden Code ab, den Rest erledigt eine kurze CLAUDE.md.
Geschäftslogik
Was Ihre Software leisten muss und kein Modell erschließen kann: Eine Erstattung übersteigt nie den tatsächlich eingezogenen Betrag, oberhalb einer Schwelle gibt eine Führungskraft frei, ein Bestellstatus heißt SHIPPED und nicht DISPATCHED. Auch Ihre Nomenklatur gehört in diese Schicht.
Sicherheitsregeln
Die Regeln, hinter denen eine Aufsichtsbehörde oder ein Kunde steht: welche Felder personenbezogene Daten enthalten, was in einem Log auftauchen darf, welche Abfrage auf den Mandanten eingeschränkt sein muss, welche Aktion ein Audit-Event verlangt.
Um die erste Schicht drehen sich sämtliche Leitfäden zur CLAUDE.md. Teuer wird ein Fehler des Agenten aber in der zweiten und dritten, und genau dort schaut kein Scanner hin, denn eine Erstattung, die zu viel gutschreibt, ist völlig gültiger Code.
Mit dieser Fehlerklasse befasst sich der Artikel über Geschäftslogikfehler in KI-generiertem Code. Hier geht es darum, sie an der Quelle zu verhindern, also dafür zu sorgen, dass der Agent die Regel kennt, während er schreibt.
Wo liegen die Grenzen von CLAUDE.md, AGENTS.md und Skills?
Jedes dieser Werkzeuge wurde für eine echte Aufgabe gebaut, und jedes erfüllt sie. Keines wurde dafür gebaut, die Geschäftsregeln eines Unternehmens bis in den Moment der Änderung zu tragen. Wo jedes davon aufhört, sagen die Hersteller selbst.
CLAUDE.md: einmal gelesen, befolgt, wenn es gerade passt
Anthropics Dokumentation ist da erstaunlich offen. CLAUDE.md-Dateien werden „zu Beginn jeder Konversation“ geladen, und „Claude behandelt sie als Kontext, nicht als erzwungene Konfiguration“. Auf derselben Seite werden Sie gebeten, „unter 200 Zeilen pro CLAUDE.md-Datei“ anzupeilen, denn „längere Dateien verbrauchen mehr Kontext und verringern die Einhaltung“. Zweihundert Zeilen also für Ihre Build-Befehle, Ihre Konventionen und sämtliche Geschäftsregeln, die Sie haben.
Dazu kommt: „Wenn sich zwei Regeln widersprechen, wählt Claude womöglich willkürlich eine davon aus“, und niemand gleicht die Datei mit dem Code ab, den sie beschreibt. Was dabei herauskommt, melden die Nutzer im Issue-Tracker. In Issue #2901, eröffnet im Juli 2025 und mit 31 Kommentaren, heißt es: „Claude Code verstößt häufig gegen ausdrückliche Projekt- und Nutzeranweisungen, die in CLAUDE.md-Dateien festgelegt sind.“ Issue #33603, bis heute offen, trägt den Titel „Harte Regeln aus der CLAUDE.md und dauerhafte Memory-Anweisungen werden durchgehend ignoriert“.
AGENTS.md: dieselbe Datei, nur für mehr Agenten
AGENTS.md ist das offene Format, das Codex, Cursor, Copilot und weitere Agenten lesen, und es wird von mehr als 60.000 Open-Source-Projekten genutzt. Die eigene Website bringt sein Wesen auf den Punkt: „AGENTS.md ist einfach Standard-Markdown“, „ein README für Agenten“. Der Standard regelt also, wo die Datei liegt, aber nicht, ob sie befolgt wird.
Der bislang einzige rigorose Test fällt wenig schmeichelhaft aus. Im Februar 2026 haben Thibaud Gloaguen, Martin Vechev und drei weitere Autoren Evaluating AGENTS.md veröffentlicht, mit einem klaren Befund: Kontextdateien „verbessern die Erfolgsquote bei Aufgaben im Allgemeinen nicht, erhöhen die Inferenzkosten aber im Schnitt um mehr als 20 %“. Die Anweisungen darin wurden „gut befolgt“, und einen Nutzen sehen die Autoren darin, „vom Standard abweichende Programmierpraktiken festzulegen“, während Überblicke über das Repository „nicht hilfreich“ seien.
Dazu kommen drei praktische Grenzen:
- Claude Code übergeht sie, sobald es eine CLAUDE.md gibt. Liegen beide Dateien im Repository, liest Claude Code standardmäßig „nur Ihre CLAUDE.md-Dateien“. Ein Team, das beide pflegt, erlebt also, dass Claude Code seine AGENTS.md überspringt, während die übrigen Agenten sie lesen.
- Codex deckelt sie. Codex hört auf, Anweisungsdateien hinzuzufügen, sobald sie zusammen die Standardgrenze von 32 KiB erreichen.
- Copilot will sie kurz. Der Prompt, den GitHub vorschlägt, um die eigenen Anweisungen zu verfassen, schreibt vor, sie dürften „nicht länger als 2 Seiten“ und „nicht aufgabenspezifisch“ sein. Eine Geschäftsregel ist aber ihrem Wesen nach aufgabenspezifisch.
Skills: geladen, wenn der Agent an sie denkt
Ein Skill ist ein Ordner mit Anweisungen und Skripten, der erst geladen wird, wenn er zum Einsatz kommt. Wie Claude die Auswahl trifft, erklärt Anthropics Skills-Dokumentation: Es liest die Beschreibung des Skills, um „zu entscheiden, wann der Skill angewendet wird“. Eine Regel, die als Skill verpackt ist, greift also nur, wenn der Agent den richtigen Moment erkennt.
Woran dieses Erkennen scheitert, zählt die Dokumentation gleich selbst auf. Die Beschreibung wird „bei 1.536 Zeichen abgeschnitten“. Sind viele Skills installiert, „lässt Claude Code einige Beschreibungen weg, damit die Liste in ihr Zeichenbudget passt, und dabei gehen die Schlüsselwörter verloren, die Claude braucht, um Ihre Anfrage zuzuordnen“. Und wird eine lange Session kompaktiert, „können ältere Skills ganz wegfallen“.
Für Abläufe sind Skills hervorragend. Als Träger für Regeln, die jedes Mal gelten müssen, hängen sie aber an genau dem, wovon Sie eigentlich nicht abhängig sein wollen. Ein Skill aus fremder Feder führt außerdem Code in Ihrer Session aus, ein Risiko für sich, das der Beitrag Sind Claude Code Skills sicher? ausleuchtet.
Was keines davon leistet
Alle drei setzen voraus, dass der schwierige Teil schon erledigt ist. Keines davon
- findet Ihre Regeln. Jedes enthält nur, was jemand im Kopf hatte und aufgeschrieben hat.
- weiß, welche Regel für diese Änderung gilt. Geladen wird nach Session, nach Pfad oder nach Beschreibung, nie danach, was der gerade geschriebene Code tatsächlich tut.
- merkt, wenn eine Regel nicht mehr zum Code passt. Ein veralteter Wert bleibt in der Datei stehen, bis ihn zufällig jemand liest.
- prüft das Ergebnis. Ob die Regel eingehalten wurde, bleibt dem Code-Review überlassen.
- funktioniert bei all Ihren Agenten gleich. Ein Team mit fünf Agenten pflegt fünf Dialekte.
Warum verliert der Agent die Regel, bevor er schreibt?
Weil die Aufmerksamkeit eines Modells nicht gleichmäßig verteilt ist und eine Regel, die zu Beginn gelesen wurde, längst weit von der Änderung entfernt ist, wenn es auf sie ankommt. Das Engineering-Team von Anthropic sagt es unverblümt: Kontext „muss als endliche Ressource mit abnehmendem Grenznutzen behandelt werden“. Den Effekt nennt es Context Rot: „Mit steigender Zahl an Token im Kontextfenster nimmt die Fähigkeit des Modells ab, Informationen aus diesem Kontext präzise abzurufen.“
Unabhängige Arbeiten haben das gemessen. Chroma hat für seinen Context-Rot-Bericht 18 Modelle getestet und festgestellt, dass „die Leistung der Modelle mit wachsender Eingabelänge nachlässt, oft auf überraschende und ungleichmäßige Weise“. Die ältere Studie Lost in the Middle zeigte, dass die Leistung „deutlich nachlässt, wenn Modelle auf relevante Informationen in der Mitte langer Kontexte zugreifen müssen“. Und IFScale, ein Benchmark, der Anweisungen aufeinanderstapelt, kam bei 500 gleichzeitigen Anweisungen zu dem Ergebnis, dass „selbst die besten Frontier-Modelle nur 68 % Genauigkeit erreichen“.
Sicherheit bekommt dabei keine Sonderbehandlung. Im SusVibes-Benchmark waren 57 % der Lösungen, die SWE-Agent mit Claude Sonnet 4 erzeugte, funktional korrekt, aber nur 11,8 % sicher, und auch „die Feature-Anfrage um Hinweise auf Schwachstellen zu ergänzen“ half nicht. Einem Agenten zu sagen, er solle vorsichtig sein, ist eben nicht dasselbe, wie ihm Ihre Regeln zu geben.
Unsere eigene Messung hat sich den schwierigsten Fall vorgenommen: Regeln, für die der Agent bereits eine eigene, plausible Antwort parat hat. Ein realistischer Regelabschnitt in der CLAUDE.md brachte 7 von 55 Regeldetails exakt ins Ziel, genau so viele wie gar keine Datei. Das vollständige Protokoll steht im Artikel Hält sich Claude Code an die CLAUDE.md?
Zwei Kräfte erklären das Ergebnis. Die erste ist Verdünnung: Bei der dreißigsten Änderung ist die Datei nur noch ein altes Fragment unter Zehntausenden Token aus Code und Ausgaben. Die zweite ist Gewohnheit: Der Code, den der Agent vor sich hat, zeigt ihm, wie man es hier macht, und er kompiliert.
Wie das bei einem einzelnen Prompt aussieht, zeigt ein kleiner Versuch. Am 27. September 2026 haben wir Claude Code (mit dem Modell Haiku) gebeten, in einem leeren Repository eine Erstattungsfunktion zu schreiben, einmal ohne jede Regel und einmal mit dem weiter unten gezeigten Hook, der unsere Erstattungsregel mitbringt. Es gab je einen Lauf, das Ganze ist also eine Illustration und keine Messung.
Die Zeilen, die die Regel im zweiten Lauf verändert hat:
if (amountCents > availableForRefund) {
  throw new RefundError("REFUND_EXCEEDS_CAPTURED");
}
order.refundedCents += amountCents;
await audit.log("refund.created", {
  orderId: order.id, amountCents, actorId,
});
Vernünftiger Code sind beide Fassungen, Ihr Code ist aber nur eine davon. Genau diese Lücke, das richtige Verhalten mit den falschen Details, übersieht ein Reviewer, und an genau ihr scheitert später ein API-Client.
CLAUDE.md, Rules, Skills, MCP oder Hooks: Was gehört wohin?
Jeder dieser Mechanismen erreicht das Modell zu einem anderen Zeitpunkt, und dieser Zeitpunkt entscheidet, wofür er taugt.
| Mechanismus | Wann er beim Modell ankommt | Stark bei | Schwach bei |
|---|---|---|---|
| CLAUDE.md oder AGENTS.md | Einmal, beim Start der Session | Build-Befehlen, Projektaufbau, Konventionen, vom Standard abweichenden Praktiken | Einem konkreten Wert, der dreißig Änderungen später gebraucht wird |
.claude/rules/ mit paths | Sobald Claude eine Datei liest, die zum Muster passt | Regeln, die an ein Verzeichnis oder einen Dateityp gebunden sind | Regeln, die davon abhängen, was der Code tut, und nicht davon, wo er liegt |
| Skills | Sobald Claude entscheidet, dass ein Skill zur Aufgabe passt | Abläufen und Playbooks, die Sie sonst von Hand einfügen würden | Regeln, die gelten müssen, ob der Agent an sie denkt oder nicht |
| MCP-Tools | Sobald der Agent beschließt, sie aufzurufen | Großen Datenbeständen, Suche, Live-Daten | Allem, was davon abhängt, dass der Agent ans Nachfragen denkt |
| Hooks | Bei einem Ereignis, und zwar jedes Mal: Session-Start, Prompt, vor oder nach einem Tool | Der richtigen Regel an der Änderung, dem Blockieren eines Befehls | Nichts, außer dass Sie die Zuordnungslogik selbst schreiben |
Entscheidend ist die zweite Spalte. Eine Datei, ein Skill und ein MCP-Tool setzen alle voraus, dass vorher etwas passiert ist oder dass das Modell von sich aus nachsieht. Einen Hook dagegen führt die Umgebung um das Modell herum aus, also Claude Code selbst, ganz gleich, ob das Modell an ihn denkt.
Rules mit Pfadbezug liegen dazwischen. Anthropics Dokumentation zufolge „greifen sie, wenn Claude Dateien liest, die zum Muster passen, und nicht bei jeder Tool-Nutzung“. Gegenüber einer einzigen großen Datei ist das ein echter Fortschritt, der Auslöser bleibt aber ein Pfad und nicht die Operation. Wie es um die Sicherheit von Skills steht, die ja Code aus fremden Repositorys ausführen, klärt der Beitrag Sind Claude Code Skills sicher? im Detail.
Wie kommt eine Regel im Moment der Änderung beim Agenten an?
Über einen PreToolUse-Hook auf den Schreib-Tools. Er sucht die Regeln heraus, die zur gerade geschriebenen Datei gehören, und gibt sie als additionalContext zurück. Sie brauchen dafür drei Dateien. Zuerst tragen Sie den Hook in .claude/settings.json ein:
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Edit|Write",
        "hooks": [
          { "type": "command", "command": "node \"$CLAUDE_PROJECT_DIR/.claude/hooks/rules-at-edit.mjs\"" }
        ]
      }
    ]
  }
}
Danach legen Sie jede Regel als kleine Datei in .claude/edit-rules/ an. In der ersten Zeile steht, für welche Pfade sie gilt:
applies-to: src/billing/**, src/api/refunds/**
Refunds: never refund more than the captured amount.
Answer 422 with the code REFUND_EXCEEDS_CAPTURED, never a prose message.
Every refund writes an audit event: audit.log("refund.created", { orderId, amountCents, actorId }).
Fehlt noch der Hook selbst, .claude/hooks/rules-at-edit.mjs. Er braucht Node 22.5 oder neuer, weil er path.matchesGlob verwendet:
import { readFileSync, readdirSync } from "node:fs";
import path from "node:path";

const root = process.env.CLAUDE_PROJECT_DIR ?? process.cwd();
const input = JSON.parse(readFileSync(0, "utf8"));
const file = path.relative(root, input.tool_input?.file_path ?? "");
const dir = path.join(root, ".claude/edit-rules");

const rules = readdirSync(dir)
  .map((name) => readFileSync(path.join(dir, name), "utf8"))
  .filter((text) => {
    const globs = text.match(/^applies-to:\s*(.+)$/m)?.[1] ?? "";
    return globs.split(",").some((g) => path.matchesGlob(file, g.trim()));
  });

if (rules.length > 0) {
  // JSON, not plain text: on PreToolUse, Claude Code only reads additionalContext.
  process.stdout.write(JSON.stringify({
    hookSpecificOutput: {
      hookEventName: "PreToolUse",
      additionalContext: `Rules for ${file}:\n\n${rules.join("\n---\n")}`,
    },
  }));
}
Mit genau diesem Aufbau ist die rechte Spalte des Erstattungsvergleichs weiter oben entstanden. Claude Code legt den Kontext eines Hooks „neben das Tool-Ergebnis“. Der Agent liest die Regel also zusammen mit dem Ergebnis seines Schreibvorgangs auf diese Datei und korrigiert sich an Ort und Stelle.
In unserem Lauf schrieb der Agent die Funktion, las die Regel und meldete dann, er habe „die Funktion aktualisiert“, bevor er den Fehlercode und das Audit-Event aufzählte.
Die anderen Agenten sprechen ihre eigenen Dialekte. OpenAIs Codex dokumentiert für PreToolUse dieselbe Form: „Um für das Modell sichtbaren Kontext hinzuzufügen, ohne zu blockieren, geben Sie hookSpecificOutput.additionalContext zurück.“ Bei Cursor kann preToolUse einen Aufruf erlauben, ablehnen oder umschreiben, und der Hook postToolUse ergänzt additional_context „nach dem Tool-Ergebnis“. Die Repository-Anweisungen von GitHub Copilot grenzen eine Datei über ein applyTo-Muster ein, und Vorrang hat die AGENTS.md, die im Verzeichnisbaum am nächsten liegt.
Wo stößt die Eigenbau-Lösung an ihre Grenzen?
Bei den Regeln selbst. Der Hook löst das Problem des Zeitpunkts, und es lohnt sich, ihn noch heute einzubauen. Der Rest der Liste von oben bleibt aber bestehen: Die Regeln stammen weiterhin aus irgendjemandes Gedächtnis und veralten weiterhin, niemand prüft, ob sie eingehalten wurden, und jeder Agent im Team braucht seine eigene Fassung. Eine Grenze bringt der Hook sogar selbst mit, denn ein Pfad verrät keine Absicht: Eine Erstattung lässt sich genauso gut in utils.ts schreiben, und ein Glob kann eine Erstattung nicht von einer Formatierfunktion unterscheiden. Jenseits von zehn Regeln und einem Agenten wird es zu einer eigenen Aufgabe, das alles von Hand aktuell zu halten.
Wie sieht die vollständige Methode aus?
Sie beginnt dort, wo jede Datei aufhört: bevor überhaupt eine Regel aufgeschrieben ist. So arbeitet CybeDefend mit VibeDefend, von der Codebasis bis zum Diff, und gebaut ist das Ganze für ein Entwicklungsteam, nicht für den Laptop einer einzelnen Person. Die Regeln liegen pro Projekt an einer einzigen Stelle, der Agent jedes Entwicklers bekommt denselben geprüften Satz, und jeder Schritt ist die Antwort auf eine der Grenzen von oben.
Schritt 1: Regeln aus dem eigenen Code extrahieren
Ihre Regeln stehen längst in Ihrem Code, nur eben in Form von Wiederholung. Sobald ein Repository angebunden und geparst ist, liest ein Mining-Verfahren seinen Code-Graphen und sucht nach fünf Arten von Regelmäßigkeit:
- Präsenzmuster: ein Feld oder ein Aufruf, den fast jede Instanz mitbringt. Jede Entität hat eine
organizationId, jeder Schreibzugriff aufordersruft den Audit-Logger auf. - Wertemengen: die literalen Namen, die Ihr Code für Status, Rollen und Fehlercodes verwendet. Das ist Ihre Nomenklatur, und ein Agent, der einen sechsten Bestellstatus erfindet, bricht jeden Konsumenten der anderen fünf.
- Gemeinsames Auftreten: Guards und Decorators, die immer zusammen vorkommen, etwa eine Authentifizierungsprüfung und ein Rate Limit.
- Pflichtaufrufe vor sensiblen Operationen: Berechtigungsprüfungen, Einschränkung auf den Mandanten, Rate Limits, Feature Flags.
- Konventionen, die ein Modell benennt, abgeleitet aus Clustern ähnlichen Codes, samt einer Liste der Ausreißer.
Zu jedem Vorschlag gehören Belege, also wo das Muster gefunden wurde und wie oft, dazu ein Konfidenzwert. Am wertvollsten sind die Ausreißer. Ein einzelner Endpoint ohne Mandantenbezug in einer Codebasis, in der vierzig andere ihn haben, ist entweder eine gewollte Ausnahme oder ein Fehler, den niemand bemerkt hat. Genau an dieser Stelle treffen Geschäftslogik und Sicherheit aufeinander.
Schritt 2: Jede Regel von einem Menschen bestätigen lassen
Das Mining schlägt vor, entscheiden darf es nie. Ein Muster kann eine bloße Gewohnheit sein statt einer Regel. Und eine Regel ist Policy: Wer sie schreibt, steuert jeden Agenten im Team, und deshalb sind Anweisungsdateien eine eigene Angriffsfläche.
In VibeDefend wird jeder Vorschlag im Dashboard angenommen, bearbeitet oder verworfen, alternativ direkt im Agenten, wenn eine Session startet. Eine Regel, die der Agent selbst vorschlägt, wird abgelehnt, solange Sie sie nicht bestätigt haben. Einmal pro Woche prüft ein Drift-Check, ob sich der Code von einer angenommenen Regel entfernt hat, und schlägt in dem Fall eine Aktualisierung vor. So bleiben die Regeln wahr, ohne dass jemand eine Datei pflegen muss.
Schritt 3: Die richtige Regel an der Änderung liefern
Im Kern ist das der Hook aus dem vorigen Abschnitt, nur dass Retrieval die Globs ersetzt. Vor jedem Schreibvorgang gehen der Dateipfad und der Anfang des gerade geschriebenen Codes als Absicht hinaus. Zurück kommen bis zu fünf Geschäftsregeln und fünf Sicherheitsregeln, die für genau diese Änderung relevant sind, als Kontext für diese Datei. Der Installer bindet das in Claude Code, Cursor, Codex, Windsurf und GitHub Copilot in VS Code ein, jeweils mit den Grenzen, die das eigene Hook-System des Agenten setzt.
Die Zustellung informiert den Agenten, zwingen kann sie ihn nicht. Für alles, was nie passieren darf, prüft ein separater Guard jeden Befehl, bevor er läuft, und kann ihn blockieren. Die Regel im Kontext ist eine starke Empfehlung, der Guard auf der Aktion ist die Kontrolle. Wir sagen lieber offen, was was ist.
Schritt 4: Das Ergebnis am Ende der Kette prüfen
Drei Prüfungen, von der einzelnen Session bis zur Architektur:
- Am Ende einer Session stellt ein Review genau eine Frage: Hat diese Arbeit eine dauerhafte Regel zutage gefördert, die nirgends aufgeschrieben ist? Es schlägt höchstens eine vor, oft keine, und ohne Ihr Ja wird nichts gespeichert.
- Vor dem Commit wird der Diff auf Schwachstellen, Fehlkonfigurationen der Infrastruktur und Secrets gescannt, damit der Agent sie noch in derselben Session behebt.
- Bei der Geschäftslogik selbst liest BLSA, unsere Business Logic Security Analysis, die gesamte Architektur Segment für Segment und findet, was kein Muster finden kann: eine Erstattung, die sich per Replay ein zweites Mal auslösen lässt, einen Mandanten, der die Daten eines anderen lesen kann, personenbezogene Daten, die über einen Export abfließen, eine Operation, die nicht idempotent ist. BLSA ist ein Forschungsvorhaben mit dem CNRS und dem Labor CRIStAL, läuft bereits bei Design-Partnern und ist noch nicht allgemein verfügbar. Lesen Sie, worauf es im Fintech-Bereich achtet.
Nebeneinandergestellt zeigt sich: Der Unterschied liegt weniger beim Agenten als beim Team um ihn herum.
Was ändert sich, wenn die Regel an der Änderung ankommt?
Die meisten Regeln gehen nicht mehr verloren. Unsere kontrollierte Studie hat 30 Entwicklertickets von drei autonomen Agenten bearbeiten lassen, auf einer Codebasis und mit einem Modell. Über die 19 Aufgaben der ersten Phase setzten der Agent ohne Regeln und der Agent mit einer realistischen Regeldatei jeweils 7 von 55 Regeldetails exakt um. Der Agent, der die Regeln an der Änderung bekam, schaffte 46 von 53.
exakt ganz ohne Regeln (7 von 55)
exakt mit einem realistischen Regelabschnitt in der CLAUDE.md (7 von 55)
exakt mit der Regel, geliefert an der Änderung (46 von 53)
Was diese Zahlen messen und was nicht: Gemessen wird die Zustellung an der Änderung. Die 49 Regeln haben wir selbst geschrieben und nicht extrahiert, über die Qualität des Minings sagt die Studie also noch nichts. Es ist eine einzige Codebasis, mit einem Lauf pro Arm und Aufgabe, bewertet von verblindeten Modellen als Prüfern.
Außerdem enthält sie ihr eigenes Gegenbeispiel: Bei einer Aufgabe wurde eine Regel dreizehnmal geliefert, und der Agent hat sie trotzdem gebrochen. Genau dafür gibt es den Guard. Protokoll und sämtliche Zahlen finden Sie in der Studie.
Womit fangen Sie diese Woche an?
Mit zehn Regeln, nicht mit einer Plattform.
- Schreiben Sie zehn Regeln auf, die Ihr Team im Code-Review immer wieder anmahnt. Gemeint sind die Kommentare, die Sie schon mehr als zweimal getippt haben.
- Sortieren Sie sie nach einer einzigen Frage: Würde ein kompetenter Entwickler, der neu im Team ist, die Regel erraten? Wenn ja, gehört sie in die CLAUDE.md. Wenn nein, muss sie den Agenten an der Änderung erreichen.
- Grenzen Sie alles, was an ein Verzeichnis gebunden ist, über
.claude/rules/und einpaths-Feld ein. - Bauen Sie für die willkürlichen Regeln den Hook von oben ein, und prüfen Sie, dass er JSON zurückgibt.
- Machen Sie aus allem, was nie passieren darf, eine Deny-Regel oder einen Guard, keinen bloßen Satz.
- Testen Sie dort, wo es scheitert: ein Feature, das eine Regel berührt, dreißig Züge nach Beginn einer Session.
Sobald die Liste nicht mehr in Ihren Kopf passt, ist der Moment gekommen, sie zu extrahieren, statt sie zu schreiben.
Häufige Fragen
Wie gebe ich Claude Code den Kontext meiner Codebasis?
In drei Schichten. Build-Befehle, Projektaufbau und Konventionen kommen in eine kurze CLAUDE.md, die Claude zu Beginn jeder Session liest. Verzeichnisbezogene Regeln legen Sie in .claude/rules/ mit einem paths-Feld ab, dann werden sie geladen, sobald Claude eine passende Datei liest. Geschäfts- und Sicherheitsregeln, die das Modell nicht erraten kann, etwa Fehlercodes, Schwellenwerte oder Audit-Formate, liefern Sie im Moment der Änderung, mit einem PreToolUse-Hook, der JSON mit additionalContext zurückgibt.
Skills oder Hooks in Claude Code: Was ist der Unterschied?
Einen Skill lädt Claude, wenn es sich dafür entscheidet. Einen Hook führt Claude Code aus, ganz gleich, wie Claude sich entscheidet. Von einem Skill liegt nur die Beschreibung im Kontext, der eigentliche Inhalt wird geladen, sobald Claude oder Sie ihn aufrufen, und das macht Skills stark bei Abläufen. Ein Hook feuert bei einem Ereignis, etwa beim Start einer Session, bei einem Prompt oder bei einem Tool-Aufruf. Damit ist er der richtige Ort für eine Regel, die den Agenten jedes Mal erreichen muss, oder um einen Befehl zu blockieren.
Was unterscheidet Rules von Skills in Claude Code?
Rules sind Anweisungen, Skills sind Abläufe. Dateien in .claude/rules/ landen ohne Bedingung im Kontext, oder dann, wenn Claude eine Datei liest, die zu ihrem paths-Muster passt. Ein Skill bündelt einen mehrstufigen Ablauf, auf Wunsch mit Skripten, und wird erst geladen, wenn er zum Einsatz kommt. Als Faustregel gilt: Rules für das, was am Code immer stimmen muss, Skills dafür, wie eine Aufgabe erledigt wird.
Kann man in Claude Code Rules anlegen?
Ja. Markdown-Dateien in .claude/rules/ werden als Anweisungen geladen, auch aus Unterordnern, ein Thema pro Datei. Hat eine Rule im Frontmatter ein paths-Feld, wird sie nur geladen, wenn Claude eine Datei liest, die zu einem ihrer Glob-Muster passt. Ohne dieses Feld ist sie in jeder Session dabei. Persönliche Rules in ~/.claude/rules/ gelten für alle Projekte auf Ihrem Rechner.
Wofür braucht man Hooks in Claude Code?
Für alles, was jedes Mal passieren muss, denn dafür sind sie der einzige verlässliche Mechanismus. Wer eine Aktion „unabhängig davon, wofür Claude sich entscheidet“, blockieren will, soll laut Anthropics eigener Dokumentation einen PreToolUse-Hook nehmen und keine Anweisung. Hooks können außerdem Kontext zu einem genau bestimmten Zeitpunkt nachreichen, etwa die Regeln für die Datei, die gerade geschrieben wird. Eine Datei, die beim Start der Session gelesen wird, kann das nicht.
Mein PreToolUse-Hook läuft, aber Claude ignoriert die Ausgabe. Warum?
Weil reiner Text aus einem PreToolUse-Hook im Debug-Log landet und nicht beim Modell. In den Kontext übernimmt Claude Code reinen Text aus stdout nur bei UserPromptSubmit, UserPromptExpansion, SessionStart und PostModelSwitch. Geben Sie stattdessen JSON zurück, mit hookSpecificOutput.hookEventName auf PreToolUse und Ihrem Text in additionalContext. Den Unterschied haben wir am 27. September 2026 mit Claude Code 2.1.282 geprüft.
Was bedeutet Context Engineering bei Coding-Agenten?
Die Entscheidung, welche Informationen wann im Kontextfenster des Modells landen, damit es die Aufgabe richtig erledigt. Bei einem Coding-Agenten geht es dabei weniger um einen längeren Prompt als um das Timing: die stabilen Fakten zum Start der Session, die relevanten Regeln im Moment der Änderung und sonst nichts, was um Aufmerksamkeit konkurriert. Das Engineering-Team von Anthropic verwendet den Begriff für die Disziplin als Ganzes.
Kann Claude Code eine CLAUDE.md automatisch erstellen?
Ja. /init analysiert Ihre Codebasis und schreibt eine erste CLAUDE.md mit Build-Befehlen, Hinweisen zu den Tests und den Konventionen, die es dabei entdeckt. Für die erste Kontextschicht ist das ein guter Anfang, mit dem Extrahieren von Geschäftsregeln hat es aber nichts zu tun. Die Studie Evaluating AGENTS.md fand, dass von Modellen erzeugte Kontextdateien die Erfolgsquote im Allgemeinen nicht verbesserten. Und auch eine generierte Datei kommt nur einmal an, beim Start der Session, und muss trotzdem von jemandem geprüft werden.
Liest Claude Code die AGENTS.md?
Ja, sofern es keine CLAUDE.md gibt. Laut Anthropics Dokumentation liest Claude Code die AGENTS.md als Projektanweisungen, wenn weder im Arbeitsverzeichnis noch darüber eine CLAUDE.md oder CLAUDE.local.md liegt. Sind beide Dateien vorhanden, liest es standardmäßig nur Ihre CLAUDE.md-Dateien, es sei denn, Ihre CLAUDE.md importiert die AGENTS.md oder Sie ändern die Einstellung. So oder so ist es derselbe Mechanismus, eine Datei, die beim Start der Session geladen wird, mit denselben Grenzen für Regeln, die dreißig Änderungen später gebraucht werden.


