

Auf dieser Seite
- Hält sich Claude Code an die CLAUDE.md?
- Was sagt die bisher veröffentlichte Forschung?
- Was haben wir gemessen, das in den großen Studien fehlt?
- Was passiert, wenn die Regel mit dem richtigen Wert in der Datei steht?
- Waren die Regeln von vornherein nicht zu erraten?
- Warum machen zwei unterschiedlich konfigurierte Agenten denselben Fehler?
- Behebt eine perfekte CLAUDE.md das Problem?
- Was sagen die Security-Hersteller zu Regeldateien?
- Was sollten Sie ändern, und was lohnt die Mühe nicht?
- Wie viel Vertrauen verdienen diese Zahlen?
- Was wir verkaufen, klar gesagt
- Häufige Fragen
- Wie erstellt man eine CLAUDE.md Datei?
- Was gehört in eine CLAUDE.md?
- Wie lang sollte eine CLAUDE.md sein?
- Wie schreibt man eine CLAUDE.md, die etwas bewirkt?
- Gehört die CLAUDE.md ins Repository?
- Liest Claude Code auch AGENTS.md?
- Warum befolgt Claude Code meine Regeln nicht?
- Bringt eine CLAUDE.md überhaupt etwas?
- Hat Karpathy wirklich einen Fehlerrückgang von 40 % auf 11 % mit einer CLAUDE.md gemessen?
- Wie erzwingt man eine Regel in Claude Code tatsächlich?
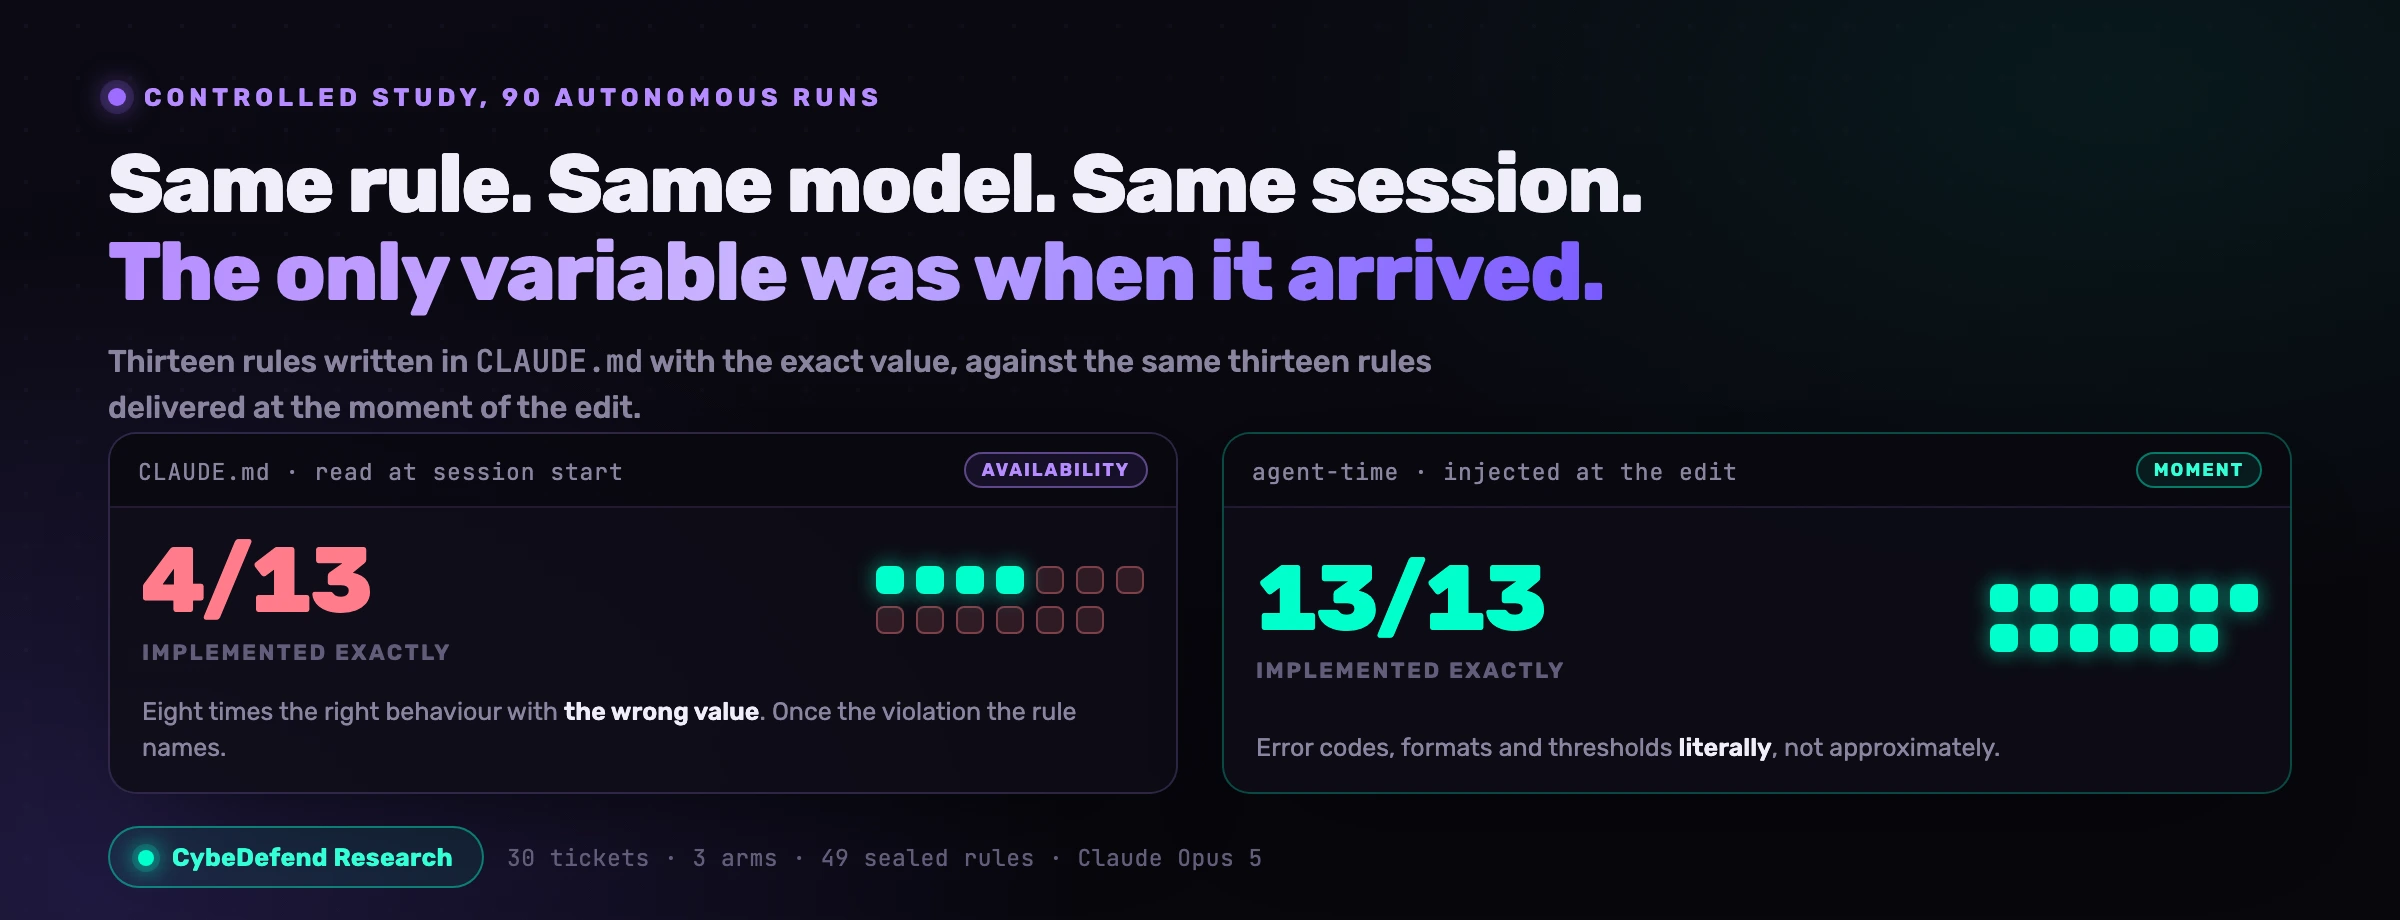
Bei den Anweisungen, die Claude Code ohnehin richtig umgesetzt hätte, hält es sich an Ihre CLAUDE.md. Bei genau den Anweisungen, für die Sie die Datei überhaupt erst geschrieben haben, fällt sie unter den Tisch. Wir haben 30 Entwicklertickets von drei autonomen Agenten bearbeiten lassen, auf derselben Codebasis, mit demselben Modell, 90 Läufe insgesamt. Verändert haben wir dabei genau eine Variable: auf welchem Weg der Agent von den 49 Geschäfts- und Compliance-Regeln der Plattform erfahren konnte. Der Arm mit einem realistischen, von Hand geschriebenen Regelabschnitt in der CLAUDE.md setzte 7 von 55 Regeldetails exakt um. Der Arm ohne jede Regel setzte ebenfalls 7 von 55 um. Punktgleich.
Hält sich Claude Code an die CLAUDE.md?
Teilweise. Und was dabei verloren geht, ist genau der Teil, auf den es Ihnen ankommt.
Anthropic formuliert das in der eigenen Dokumentation bemerkenswert offen. Auf der Memory-Seite steht, dass CLAUDE.md-Dateien zu Beginn jeder Konversation geladen werden und dass Claude sie als Kontext behandelt, nicht als erzwungene Konfiguration. Die Troubleshooting-Seite wird noch deutlicher: Claude lese die Datei und versuche, ihr zu folgen, eine Garantie für strikte Einhaltung gebe es aber nicht, bei vagen oder widersprüchlichen Anweisungen erst recht nicht.
Was Anthropic bis heute, Stand 13. September 2026, nicht veröffentlicht, ist eine Zahl. Eine gemessene Quote der Regeltreue steht nirgends in der Dokumentation. Für einen Hersteller ist das nachvollziehbar. Für ein Team, das entscheiden muss, ob diese Datei eine Kontrolle ist oder ein gut gemeinter Hinweis, hilft es nicht weiter.
Vom Tisch ist die Frage deshalb nicht. Wer den Issue-Tracker von anthropics/claude-code nach Titeln durchsucht, in denen CLAUDE.md und irgendeine Form von „ignore“ zusammen vorkommen, landet bei 199 Treffern, von denen am 13. September 2026 noch 9 offen waren. Es geht dabei nicht durchweg um Regeltreue, der wiederkehrende Titel ist trotzdem eindeutig: CLAUDE.md Mandatory Rules Consistently Ignored Across Multiple Repositories, offen seit Juni 2025, mit 45 Reaktionen. Verräterisch ist der Plural. Hier meldet niemand einen Bug, hier melden Leute eine Eigenschaft.
Was sagt die bisher veröffentlichte Forschung?
Dass genau die Dinge, an denen alle herumschrauben, messbar nichts bringen: die Größe der Datei, die Position der Regel darin, das Aufteilen in mehrere Dateien. Und dass die Regeltreue nachlässt, je länger eine Session läuft. Das ist nicht unser Befund, und das gehört gesagt, bevor wir den eigenen vorlegen.
Im Mai 2026 hat Damon McMillan Instruction Adherence in Coding Agent Configuration Files: A Factorial Study of Four File-Structure Variables veröffentlicht (arXiv 2605.10039, eingereicht am 11. Mai 2026). Von allem, was es zu dieser Frage gibt, ist das mit Abstand die am besten abgesicherte Arbeit: 1.650 Sessions mit der Claude Code CLI, 16.050 Beobachtungen auf Funktionsebene, zwei TypeScript-Codebasen, fünf Programmieraufgaben, Sonnet 4.6, dazu Opus 4.6 als modellübergreifende Gegenprobe. Faktoriell manipuliert wurden vier Variablen: die Größe der Datei, die Position der Anweisung, der Aufbau der Datei und Widersprüche in benachbarten Dateien.
Das Ergebnis fasst die Arbeit so zusammen: „Keine der vier Strukturvariablen und keine der drei Zweifachinteraktionen erzeugt nach Korrektur für multiples Testen einen nachweisbaren Unterschied.“ Bei Dateigröße und Widersprüchen kommen Bayes-Faktoren hinzu, die die Nullhypothese aktiv stützen (BF10 zwischen 0,05 und 0,10), und das ist mehr als ein bloß ausgebliebener Nachweis. Bewegt hat sich eine einzige Größe: „Jede weitere Funktion, die der Agent erzeugt, geht mit einer um rund 5,6 % geringeren Chance auf Einhaltung pro Schritt einher (OR = 0,944).“ Der Verlauf ist laut Arbeit nicht monoton.
An diesem zweiten Punkt hängt alles. Eine triviale Zielannotation setzt der Agent von sich aus nie, er hat schlicht keinen Grund dazu, solange die Datei nicht danach verlangt. Die Datei muss die Einhaltung hier also von praktisch null auf irgendetwas heben, und das schafft sie. Wir haben die kommerziell unbequeme Variante der Frage gestellt: Was passiert, wenn der Agent ohnehin etwas Plausibles hervorbringt und die Regel sagt, dass genau dieses Plausible falsch ist?
Was haben wir gemessen, das in den großen Studien fehlt?
Den Fall, in dem der Agent die Antwort schon zu kennen glaubt. Unsere kontrollierte Studie vom 24. August 2026 hat 30 Entwicklertickets dreifach gegen eine mittelgroße Codebasis aus Express und SQLite laufen lassen: drei autonome Agenten, dieselben Tickets, dasselbe Modell (Claude Opus 5 mit Effort high), 90 Läufe und 93 unabhängige Sicherheitsscans. Manipuliert haben wir nur, auf welchem Weg der Agent die 49 Regeln der Plattform kennen konnte. Gar nicht, über einen Regelabschnitt in der CLAUDE.md des Repositorys, oder über eine Injection im Moment der Änderung.
Die Regeln verteilen sich auf elf Familien: Rückerstattungen, die Arithmetik des Treueprogramms, Datenminimierung nach DSGVO, die Referenzpreispflicht aus der Omnibus-Richtlinie, Bargeldobergrenzen, Audit-Trails. Zu jeder gehört ein bewusst willkürliches Detail, etwa 422 REFUND_EXCEEDS_CAPTURED, eine Freigabeschwelle von 150,00 Euro für die Filialleitung, erased-{id}@removed.invalid oder ORD-{store}-{YYMMDD}-{seq}.
Der Regelabschnitt im Datei-Arm ist so geschrieben, wie echte Teams so etwas schreiben: 41 Zeilen für ungefähr die Hälfte des Korpus, in eigenen Worten paraphrasiert, zwei veraltete Werte, ganze Familien fehlen. Was er zu welcher Regel sagt, war ebenso vor dem ersten Lauf versiegelt wie das Korpus selbst. Die Tickets sind als Störungsmeldungen in Entwicklersprache verfasst und maschinell darauf geprüft, dass keine Literale durchsickern. Drei verblindete Prüfer haben jeden Diff bewertet, ohne zu wissen, aus welchem Arm er stammt.
Regeldetails exakt mit einem realistischen Regelabschnitt in der CLAUDE.md
Regeldetails exakt ganz ohne Regeldatei
Regeldetails exakt, wenn die Regel an der Änderung ankommt
Sieben von 55, in beiden Kontrollarmen. Nicht ungefähr gleich, sondern identisch. Über die neunzehn Aufgaben der Phase 1 hinweg hat die realistische Regeldatei im Repository am erzeugten Code nichts Messbares verändert. Verändert hat sie die Form der Fehler, und das ist der einzige Beitrag, den wir ihr nachweisen können: Der nackte Arm verstieß häufiger (18 gegen 12), der Datei-Arm traf öfter das richtige Verhalten mit dem falschen Wert (28 gegen 20). Ein paraphrasiertes Dokument verschiebt Fehler von „Verstoß“ nach „fast richtig“. Zu „exakt“ macht es sie nicht.
Was passiert, wenn die Regel mit dem richtigen Wert in der Datei steht?
Dann wird sie in 31 % der Fälle exakt umgesetzt. Weil vorab versiegelt war, was die Datei zu welcher Regel sagt, lässt sich Phase 1 danach aufschlüsseln. Bei 13 Regeln stand der richtige Wert schwarz auf weiß darin, in einem Dokument, das zu Beginn jeder Session geladen wird.
| Was die Datei zur Regel sagte | Bewertete Regeln | Exakt | Richtiges Verhalten, falscher Wert | Verstöße | Exakt bei Lieferung an der Änderung |
|---|---|---|---|---|---|
| Exakt, der richtige Wert, ausgeschrieben | 13 | 4 (31 %) | 8 | 1 | 13 (100 %) |
| Vage, die Richtung ohne den Wert | 21 | 2 (10 %) | 13 | 2 | 15 (71 %) |
| Fehlend, nie geschrieben | 20 | 1 (5 %) | 6 | 9 | 18 (90 %) |
Lesen Sie die oberste Zeile zweimal. Nicht die Verfügbarkeit der Information war die Variable, sondern der Zeitpunkt, zu dem sie ankam.
Am deutlichsten wird das bei Aufgabe M06. Das Ticket verlangt, eine Geschenkkarte anzunehmen, die kleiner ist als der Warenkorb, den Rest zahlt eine Bankkarte. Die Regel dazu: Pro vollem Euro, der in Geld bezahlt wird, gibt es einen Treuepunkt, der Anteil der Geschenkkarte bringt keinen. Der Datei-Arm hatte diese Regel exakt vorliegen. Er hat die Zahlungsfunktion neu geschrieben, den anrechenbaren Anteil berechnet, um die Zahlungsarten zu sortieren, und ausgerechnet die Zeile floor(total / 100) stehen lassen, die die Punkte auf den Gesamtbetrag bucht. In seinem eigenen, frisch gebauten Ablauf bringen Geschenkkarten-Euro also Treuepunkte.
Die Arbeit eines sorgfältigen Entwicklers, der das Regeldokument nie gesehen hat.
Gesehen hatte er es sehr wohl, zu Beginn der Session, in einer Datei, die vor dem ersten Zug geladen wurde. Der Arm, der dieselbe Regel mitten in der Schleife bekam, während er die Zahlungsdatei bearbeitete, schrieb earned = floor(remainderCents / 100) und zwei eigene Tests dazu.
Waren die Regeln von vornherein nicht zu erraten?
Ein Teil davon ja, und dieser Einwand gehört beantwortet statt weggeräumt. Die Erratbarkeit wurde Regel für Regel bewertet und vor dem ersten Lauf versiegelt: 35 nicht erratbar, 13 schwach erratbar, 1 erratbar. Die willkürlichen Details sind Absicht, denn nur so lässt sich trennen, ob ein Agent eine Regel kennt oder ob er eine vernünftige Regel errät.
Aufgabe M21 führt diese Trennung vor. Alle drei Arme haben Barzahlungen bei 1.000 Euro gedeckelt, denn das ist eine öffentlich bekannte Rechtslage, die das Modell kennt und die ihm niemand sagen muss. Mit dem plattformeigenen Fehlercode 422 CASH_LIMIT geantwortet hat nur der Arm, der die Regel geliefert bekam, auf den Cent genau an der Grenze getestet, bezogen auf den Bargeldanteil einer gemischten Zahlung. Die beiden anderen gaben einen 422 mit einer Meldung in Prosa zurück.
Für einen API-Client ist das zweierlei: einmal ein behandelter Fall, einmal etwas, das sich derjenige zusammenreimen muss, der die Integration schreibt. Ein Unternehmen bezahlt nicht für das Weltwissen des Modells, sondern für den willkürlichen Vertrag, über den seine eigenen Systeme miteinander reden. Wem unser Korpus zu willkürlich vorkommt, der muss die Gegenfrage aus M21 beantworten: Sind Ihre Fehlercodes und Formate weniger willkürlich?
Warum machen zwei unterschiedlich konfigurierte Agenten denselben Fehler?
Weil Agentenfehler deterministisch sind und nicht streuen. Mit diesem Ergebnis hatten wir nicht gerechnet, und es hat die größten Folgen für den Betrieb. Bei 16 der 30 Aufgaben sind die beiden Kontrollarme, unabhängig voneinander und in getrennten Worktrees, bei derselben falschen Umsetzung gelandet. Nicht bei einer ähnlichen. Bei derselben.
- Bei der Jahresinventur dasselbe absolute Schreiben per SQL,
quantity = excluded.quantity, obwohl die Regel eine typisierte Bewegung im Buch verlangt. - Für überlappende Aktionen dasselbe verbotene Design, Überlappung als Feature und die stärkste Aktion gewinnt. Genau der Entwicklerinstinkt, und genau das, was die Preisregel untersagt.
- Dieselbe Obergrenze von 4.000 Zeichen für aufbewahrte Diagnosedaten, und dasselbe vergessene Feld
ibanin der Schwärzungsliste.
Wer davon ausgeht, eine schlechte Agentenausgabe sei ein Würfelwurf, den das Review beim zweiten oder dritten Mal abfängt, sollte diese Annahme fallen lassen. Ein Unternehmen, das seinen Vertrag nicht vor den Agenten legt, bekommt keine Bandbreite an Auslegungen, aus der ein Reviewer die richtige heraussuchen könnte. Es bekommt überall dieselbe vernünftige, falsche Auslegung, und dieselben Tests verteidigen sie.
Der letzte Halbsatz ist der wichtige. Nach 30 Tickets blieben in den Kontrollarmen 57 und 52 nicht regelkonforme Stellen zurück, darunter 21 und 12 offene Verstöße: personenbezogene Daten in einem Speditionsexport und in den Logs, ein unzulässiger Streichpreis, Treuepunkte auf Geschenkkarten, überschriebene Bestände ohne jede Spur. Mindestens ein Drittel davon war durch grüne Tests festgezurrt, die die Agenten selbst geschrieben hatten. Diese Schuld ist nicht nur stumm, sie wird von der CI verteidigt. Mehr dazu in Geschäftslogikfehler in KI-generiertem Code.
Behebt eine perfekte CLAUDE.md das Problem?
Sie bringt zwei Drittel des Weges, und wir haben das gemessen, statt es anzunehmen. Nach Aufgabe 22 stand ein berechtigter Einwand im Raum: Hatte der Datei-Arm überhaupt je eine faire Chance? Also haben wir eine Ergänzung des Protokolls präregistriert und den abgedrifteten Abschnitt durch das vollständige Korpus aller 49 Regeln ersetzt, wortgleich, samt Maschinenliteralen, präsentiert als frisch aus dem Engineering synchronisiert. Stärker lässt sich „Regeln gehören ins Repository“ nicht mehr umsetzen.
Vierundsechzig Prozent sind eine echte Verbesserung, das wollen wir nicht kleinreden. Sie sind zugleich die Obergrenze, sie kosten genauso viele Token, und die vier Fehlschläge sind lehrreich. Der Datei-Arm traf die Regeln, auf die das Ticket zeigte, und scheiterte an zwei anderen Sorten.
Erstens an Randtoken innerhalb einer Regel, die er sonst traf. 403 ADJUSTMENT_LIMIT jenseits von plus oder minus 30 Einheiten stand wortgleich in seiner Datei, er setzte die Schwelle von 30 exakt und antwortete dann mit einem 403 in Prosa, ohne das Literal. Verdünnung wirkt also schon innerhalb einer einzelnen Regel, nicht erst über ein ganzes Dokument hinweg.
Zweitens an querschnittlichen Regeln, die das Ticket nicht benennt. Das Verbot, Bestandsmengen direkt zu überschreiben, stand wortgleich in seiner Datei und verlor drei von drei Mal gegen die Gewohnheit des Codes, der vor ihm lag. Bestehender Code ist eine Anweisung, die nirgends ausgesprochen wird und trotzdem stärker wirkt als jedes Dokument: Er zeigt, wie es hier gemacht wird, er liegt beim Schreiben unmittelbar vor Augen, und er kompiliert. Eine Regel, die einer Code-Gewohnheit widerspricht, gewinnt nur, wenn sie im selben Moment eintrifft wie die Gewohnheit.
Was sagen die Security-Hersteller zu Regeldateien?
Beides, oft im selben Produkt, und fast nie mit einer Messung im Rücken.
Das optimistische Argument kam früh, und es kam gut begründet. Im Juni 2025 veröffentlichte Rami McCarthy bei Wiz Rules Files for Safer Vibe Coding und stellte Basis-Sicherheitsregeln für Cursor, Windsurf, Copilot, die AGENTS.md von Codex und die CLAUDE.md von Claude quelloffen bereit. Regeldateien seien, so das Argument, der ideale Weg, um sicherheitsorientierte Verbesserungen am Prompt zu zentralisieren und zu vereinheitlichen. Der Beitrag schränkt selbst ein: Die beste Sicherheitsregeldatei ist die, die auf die eigene Organisation zugeschnitten ist. Gegen die Klasse, auf die er zielt, die generische Secure-Coding-Haltung, haben wir nichts in der Hand.
Das skeptische Argument dreht sich meist darum, wer die Datei ändern darf, und nicht darum, ob das Modell ihr folgt. Mahesh Babu schreibt im Kodem-Leitfaden zur Absicherung von KI-Code-Editoren vom 31. Oktober 2025, die Schutzfunktionen dieser Werkzeuge würden in der Praxis häufig abgeschaltet, und zurück bleibe eine Umgebung, in der nicht vertrauenswürdiger Code oder vergiftete Regeldateien ungeprüft laufen. Das ist ein echtes Problem, nur eben ein anderes. Eine Regel kann scheitern, weil jemand sie abgeschaltet hat. Sie kann genauso scheitern, weil das Modell sie verdünnt hat, während die Datei völlig unversehrt ist.
Aufschlussreich ist das leise Muster dahinter: Hersteller, die eine Regeldatei und ein Produkt zur Kontextinjektion gleichzeitig ausliefern. Sonar veröffentlicht für seinen Agenten-Workflow eine AGENTS.md und sagt Ihnen dazu, Sie sollten die Datei als Anweisungsdatei Ihres Agenten in die Wurzel Ihres Repos legen. Daneben verkauft Sonar Vortex, das den passenden Projektkontext und die passenden Einschränkungen einspeist, damit Agenten von Anfang an Klarheit haben. Endor Labs wiederum liest Ihre CLAUDE.md als Absichtserklärung für den eigenen Scanner und hält am 7. September 2026 fest: Eine CLAUDE.md mit dem Satz, dass alle API-Routen über die SSO-Middleware authentifiziert werden, sage dem Scanner etwas, das kein noch so gutes Pattern Matching zutage fördern würde.
Eine Quote der Regeltreue hat keiner von ihnen veröffentlicht, und Anthropic, soweit wir sehen, ebenfalls nicht. Bisher stand die Position auf Behauptungen und GitHub-Threads. Jetzt steht sie auf einer großen faktoriellen Studie zur Dateistruktur und auf einer kleinen Studie zum schwierigen Fall. Das ist immer noch dünn. Dünner war es vorher.
Was sollten Sie ändern, und was lohnt die Mühe nicht?
Fangen Sie mit dem an, was die Evidenz ausschließt, denn genau dort steckt die meiste Mühe der meisten Teams. McMillan hat faktoriell und in großem Maßstab die vier Dinge geprüft, die jeder Leitfaden für eine gute CLAUDE.md empfiehlt.
| Der übliche Rat | Was die faktorielle Studie fand |
|---|---|
| Kürzen Sie die Datei | Kein nachweisbarer Effekt der Dateigröße, gestützt durch einen Bayes-Faktor zugunsten der Null |
| Stellen Sie die wichtige Regel nach oben | Kein nachweisbarer Effekt der Position einer Anweisung |
| Teilen Sie die Datei auf, oder arbeiten Sie mit Importen | Kein nachweisbarer Effekt des Dateiaufbaus |
| Räumen Sie Widersprüche zu Nachbardateien aus | Kein nachweisbarer Effekt von Widersprüchen, ebenfalls mit Bayes-Faktor zugunsten der Null |
Zwei Einschränkungen dazu. Anthropic empfiehlt tatsächlich, unter 200 Zeilen pro CLAUDE.md-Datei zu bleiben, und begründet das mit dem Kontextbudget. Eine aufgeblähte Datei zu entschlacken ist gute Hygiene. Wer allerdings darauf wettet, dass eine Kürzung von 300 auf 150 Zeilen die Regeltreue hebt, dem sagt das einzige direkte Experiment: Sie werden den Unterschied nicht messen. Und das Argument, wichtige Inhalte gingen in der Mitte eines langen Kontexts unter, wird ständig angeführt, um Regeln nach oben zu ziehen. McMillan hat eine Regel in Zeile 2 gegen dieselbe Regel in Zeile 250 gestellt. Kein Effekt.
Belegt ist dagegen das, was keine der beiden Studien eigentlich messen wollte: der Abstand zum Schreibvorgang. Der von ihm gemessene Abfall innerhalb der Session und unsere Aufteilung in geliefert und nicht geliefert sind dasselbe Phänomen, von zwei Seiten betrachtet. Von den 58 bewerteten Regeln, die unsere Schicht im Moment der Änderung geliefert hat, waren 55 exakt, also 95 %. Von den 6, die sie nicht liefern konnte, waren 4 nicht exakt. Derselbe Agent, dieselbe Session, dieselbe Intelligenz, nur ein anderer Abstand. Sortieren Sie Ihre Regeln also danach, ob der Agent sie erraten könnte.
Lassen Sie in der Datei, was die Datei gut kann: Build-Befehle, den Aufbau des Projekts, Konventionen, die ein kompetenter Entwickler ohnehin übernimmt, und alles, was der Agent von allein nie schreiben würde. Diese letzte Kategorie hat die statistisch starke Studie gemessen, und dort funktioniert die Datei.
Verlagern Sie Ihre willkürlichen Festlegungen in den Moment der Änderung. Fehlercodes, Dateinamensformate, Schwellenwerte, die Form Ihrer Audit-Zeile, die Spalten, die ein Export enthalten darf. Mit diesen Regeln tut sich eine Datei am schwersten, weil der Agent längst eine plausible Gegenantwort hat und die Datei aus dreißigtausend Token Entfernung dagegen anargumentiert. Es sind zugleich die Regeln, hinter denen eine Aufsichtsbehörde oder ein Kunde steht.
Lassen Sie aus Regeln Struktur werden. Kam eine Regel an der Änderung an, baute der Agent den Mechanismus gleich mit, den sie voraussetzt: ein Bewegungsbuch, einen Idempotenzschlüssel, ein Audit-Event. Spätere Aufgaben haben ihn wiederverwendet, teils ohne dass die Regel noch einmal geliefert wurde. Als bei Aufgabe 14 das Ticket zum Audit-Trail kam, brauchte der Arm, der die ganze Zeit Audit-Events geschrieben hatte, noch 334 Zeilen. Die beiden anderen, die nie eines geschrieben hatten, bauten den Trail in 1.107 und 1.620 Zeilen von Grund auf. Unterwegs mitgelegte Compliance kostet fünfmal weniger Code als nachgeholte.
Was nie passieren darf, gehört nicht in Prosa. Anthropic ist da eindeutig: Wenn Sie eine Aktion unabhängig davon blockieren wollen, wofür Claude sich entscheidet, nehmen Sie stattdessen einen PreToolUse-Hook. Anweisungen in der CLAUDE.md formen Claudes Verhalten, eine harte Durchsetzungsschicht sind sie nicht. Eine Regel, deren Verlust Sie sich nicht leisten können, ist ein Hook oder eine Berechtigung, kein Aufzählungspunkt. Und prüfen Sie die Datei selbst wie Code, denn wer in sie committen darf, schreibt die Policy Ihres Agenten. Siehe dazu Instruction File Injection.
Wie viel Vertrauen verdienen diese Zahlen?
Weniger als die von McMillan, und das sagen wir lieber selbst, als es Sie nachrechnen zu lassen. Wir hatten einen Lauf pro Arm und Aufgabe, eine Codebasis, ein Modell, 25 regeltragende Aufgaben und rund 65 bewertete Regeln je Arm. Er hatte 1.650 Sessions und 16.050 Beobachtungen. Die großen Abstände, 13 % gegen 87 % und 64 % gegen 100 %, sind zu groß, um Zählfehler zu sein. Die feineren Verteilungen sollten Sie mit dieser Stichprobengröße im Hinterkopf lesen. Einen p-Wert veröffentlichen wir bewusst nicht.
Dazu kommt: Wir haben das Korpus selbst geschrieben, und wir verkaufen ein Werkzeug, das Regeln an der Änderung liefert. Gegen diese Verzerrung stehen drei Vorkehrungen: Korpus und Bewertungsraster vor dem ersten Lauf versiegelt, Erratbarkeit vorab bewertet, Tickets maschinell auf durchgesickerte Literale geprüft. Die verblindeten Prüfer sind Modelle, keine Menschen. Eine Replikation mit menschlichen Reviewern wäre der naheliegende nächste Schritt, und den sind wir nicht gegangen. Die Studie berichtet auch, wo unser eigener Arm verloren hat.
Vier weitere Punkte in Kürze. Zwei Überanwendungen, also richtige Korrekturen zum falschen Zeitpunkt. Vier nie abgerufene Regeln, jede aus einer Familie, auf die das Ticket nicht zielte, was vier der sieben Abweichungen unseres Arms erklärt. Sechs Aufgaben mit beeinträchtigter Lieferung nach einem Authentifizierungsfehler und einem Kanalausfall, die wir uns angerechnet statt sie ausgeschlossen haben. Dreizehn Fehlalarme bei den Befehls-Guards.
McMillans Experiment ist das bessere, unseres ist der härtere Fall. Er hat die Struktur sauber isoliert, mit einem Ziel, gegen das kein Instinkt anläuft. Wir haben Ziele gewählt, bei denen es nichts als konkurrierende Instinkte gibt, und dafür statistische Power geopfert. Zusammen sagen beide etwas Einfaches: Nicht die Struktur der Datei versagt, und die Regeln, an denen eine Datei versagt, sind genau die, für die Sie sie geschrieben haben.
Was wir verkaufen, klar gesagt
Injection zur Agent-Time ist unser Produkt. Diese Studie misst es, und sie sagt auch, was es nicht kann.
VibeDefend wird in der Umgebung des Agenten installiert, nicht in Ihrem Repository. Vor jeder Dateiänderung feuert ein Hook und legt die Regeln, die zu dieser Datei und zu dieser Absicht gehören, unmittelbar vor dem Schreiben in den Kontext des Modells. Über die 30 Aufgaben hinweg kam das auf 669 Injektionen von Geschäftsregeln und 1.078 Injektionen von Sicherheitsregeln, für etwa einen Dollar pro Ticket.
Was es nicht tut, ist erzwingen. Aufgabe M24 steht in diesem Artikel, weil sie die Grenze unseres Produkts am deutlichsten zeigt. Deterministisch ist der Guard auf der Aktion, nicht die Regel im Kontext, und wir sagen lieber, welches von beidem eine Kontrolle ist, als so zu tun, als wären es beide. Das größere Bild steht in Sicherheit von KI-Coding-Agenten.
Häufige Fragen
Wie erstellt man eine CLAUDE.md Datei?
Als schlichte Markdown-Datei im Repository, die Claude Code zu Beginn jeder Session lädt und die sich in jedem Editor öffnen lässt. Das Anlegen ist der leichte Teil, entscheidend ist der Inhalt. Anthropics Dokumentation hält dazu fest, dass Claude solche Dateien als Kontext behandelt und nicht als erzwungene Konfiguration. Die Datei ist also eine Vorgabe und kein Schalter.
Was gehört in eine CLAUDE.md?
Build-Befehle, die Struktur des Projekts, Hauskonventionen und alles, was der Agent von allein nie schreiben würde. Genau diese letzte Klasse hat die statistisch stärkste Studie gemessen, und dort leistet die Datei etwas. Nicht hinein gehören Ihre willkürlichen Festlegungen, also Fehlercodes, Dateinamensformate, Schwellenwerte. Bei den 13 Regeln, in denen unsere Datei den exakten Wert schwarz auf weiß trug, setzte der Agent ihn 4 Mal exakt um.
Wie lang sollte eine CLAUDE.md sein?
So lang, wie Ihr Kontextbudget es verträgt, denn über die Regeltreue entscheidet die Länge nicht. Anthropic empfiehlt, unter 200 Zeilen pro Datei zu bleiben, und eine aufgeblähte Datei zu entschlacken ist gute Hygiene. Einen nachweisbaren Effekt der Dateigröße fand die faktorielle Studie jedoch nicht, gestützt durch einen Bayes-Faktor zugunsten der Null. Erwarten Sie von einer kürzeren Datei also nicht, dass eine bestimmte Regel dadurch bis zum Schreibvorgang überlebt.
Wie schreibt man eine CLAUDE.md, die etwas bewirkt?
Sortieren Sie Ihre Regeln danach, was das Modell erraten kann, und hören Sie auf, an der Struktur der Datei zu feilen. Der einzige direkte faktorielle Test, über 1.650 Claude-Code-Sessions, fand keinen nachweisbaren Effekt der Dateigröße, der Position einer Anweisung, des Aufteilens auf mehrere Dateien oder von Widersprüchen zu Nachbardateien, und eine Anweisung in Zeile 2 schnitt nicht besser ab als dieselbe in Zeile 250. Was ein kompetenter Entwickler ohnehin anwendet, bleibt in der Datei. Ihre willkürlichen Werte wandern an den Moment des Schreibens, und was nie passieren darf, wird ein Hook.
Gehört die CLAUDE.md ins Repository?
Ja, und danach gehört sie wie Code geprüft, denn wer darin committen darf, schreibt die Policy Ihres Agenten. Committen ist allerdings nicht dasselbe wie Erzwingen. Der Regelabschnitt aus unserer Studie lag im Repository und wurde zu Beginn jeder Session geladen, und der Code, der dabei herauskam, war von dem des Arms ohne jede Regeldatei nicht zu unterscheiden.
Liest Claude Code auch AGENTS.md?
Nein, nur CLAUDE.md, solange Sie AGENTS.md nicht selbst verdrahten. Anthropics Dokumentation ist eindeutig: Claude Code liest CLAUDE.md, nicht AGENTS.md. Als unterstützte Brücke dienen ein @AGENTS.md-Import oder ein Symlink. Besser ist keine der beiden Dateien, denn dahinter steckt derselbe Mechanismus, ein zu Beginn der Session in den Kontext geladenes Dokument. Also ist auch der Fehlermodus derselbe.
Warum befolgt Claude Code meine Regeln nicht?
Meist verdünnt es sie, statt sie zu ignorieren. Die Datei wird einmal geladen, und bei der dreißigsten Änderung ist sie ein altes Fragment unter Zehntausenden Token aus Code, Befehlsausgaben und Überlegungen. Damon McMillans faktorielle Studie misst dasselbe von der anderen Seite: Mit jeder weiteren Funktion, die der Agent erzeugt, sinkt die Chance auf Regeltreue um rund 5,6 %. Die zweite Ursache ist Ihre eigene Codebasis. Sie zeigt dem Agenten, wie es hier gemacht wird, und sie kompiliert.
Bringt eine CLAUDE.md überhaupt etwas?
Für eine Klasse von Regeln ja, für die Klasse, derentwegen die meisten Teams sie schreiben, nein. McMillans Studie maß eine triviale Annotation, die der Agent ohne Aufforderung der Datei gar nicht ausgeben würde, und dort hebt die Datei die Einhaltung von fast nichts auf etwas. Wir haben den umgekehrten Fall genommen, Regeln, für die der Agent bereits eine plausible Gegenantwort hat, und ein realistischer Regelabschnitt erreichte dabei genau das Ergebnis von gar keiner Datei: 7 Regeldetails von 55.
Hat Karpathy wirklich einen Fehlerrückgang von 40 % auf 11 % mit einer CLAUDE.md gemessen?
Eine Primärquelle für diese Zahl haben wir nicht gefunden. Sie kursiert in Social-Threads und in Nacherzählungen aus zweiter Hand, in mehr als einer Form, von 40 % oder 41 % auf 11 %, ohne veröffentlichte Methode und ohne prüfbare Stichprobengröße. Nüchterner fallen die Messungen aus, hinter denen tatsächlich ein Paper oder ein Protokoll steht: McMillan fand über 1.650 Sessions keinen nachweisbaren Effekt der vier Strukturvariablen, und unsere 90 Läufe stellen eine realistische Regeldatei mit gar keiner Regeldatei gleich.
Wie erzwingt man eine Regel in Claude Code tatsächlich?
Nicht mit Prosa. Anthropic rät zu einem PreToolUse-Hook, um eine Aktion unabhängig davon zu blockieren, wofür Claude sich entscheidet, und zu Managed Settings für Berechtigungen, denn Regeln aus den Settings werden vom Client durchgesetzt, ganz gleich, was Claude zu tun beschließt. Eine Regel, deren Verlust Sie sich nicht leisten können, gehört in einen Hook oder in eine Berechtigung. Eine Regel, mit der der Agent argumentieren soll, gehört in seinen Kontext, und zwar im Moment des Schreibens.


