


Auf dieser Seite
- Welche Daten überträgt Codex an OpenAI?
- Trainiert OpenAI mit Ihrem Code aus Codex?
- Was speichert Codex lokal auf Ihrem Rechner?
- „Stiehlt“ Codex Ihren Code?
- Wie halten Sie Secrets und regulierten Code von Codex fern?
- Was keine Datenschutzeinstellung abdeckt
- Häufige Fragen
- Landet mein Code bei OpenAI, wenn ich Codex nutze?
- Trainiert OpenAI seine Modelle mit meinem Code aus Codex?
- Wie deaktiviere ich das Training mit meinem Code in ChatGPT und Codex?
- Läuft Codex lokal, und was speichert es auf meinem Rechner?
- Kann Codex meine .env-Datei lesen?
- Ist Codex DSGVO-konform nutzbar, und gibt es Datenresidenz in der EU?
- Wie sicher ist Codex für proprietären Code?
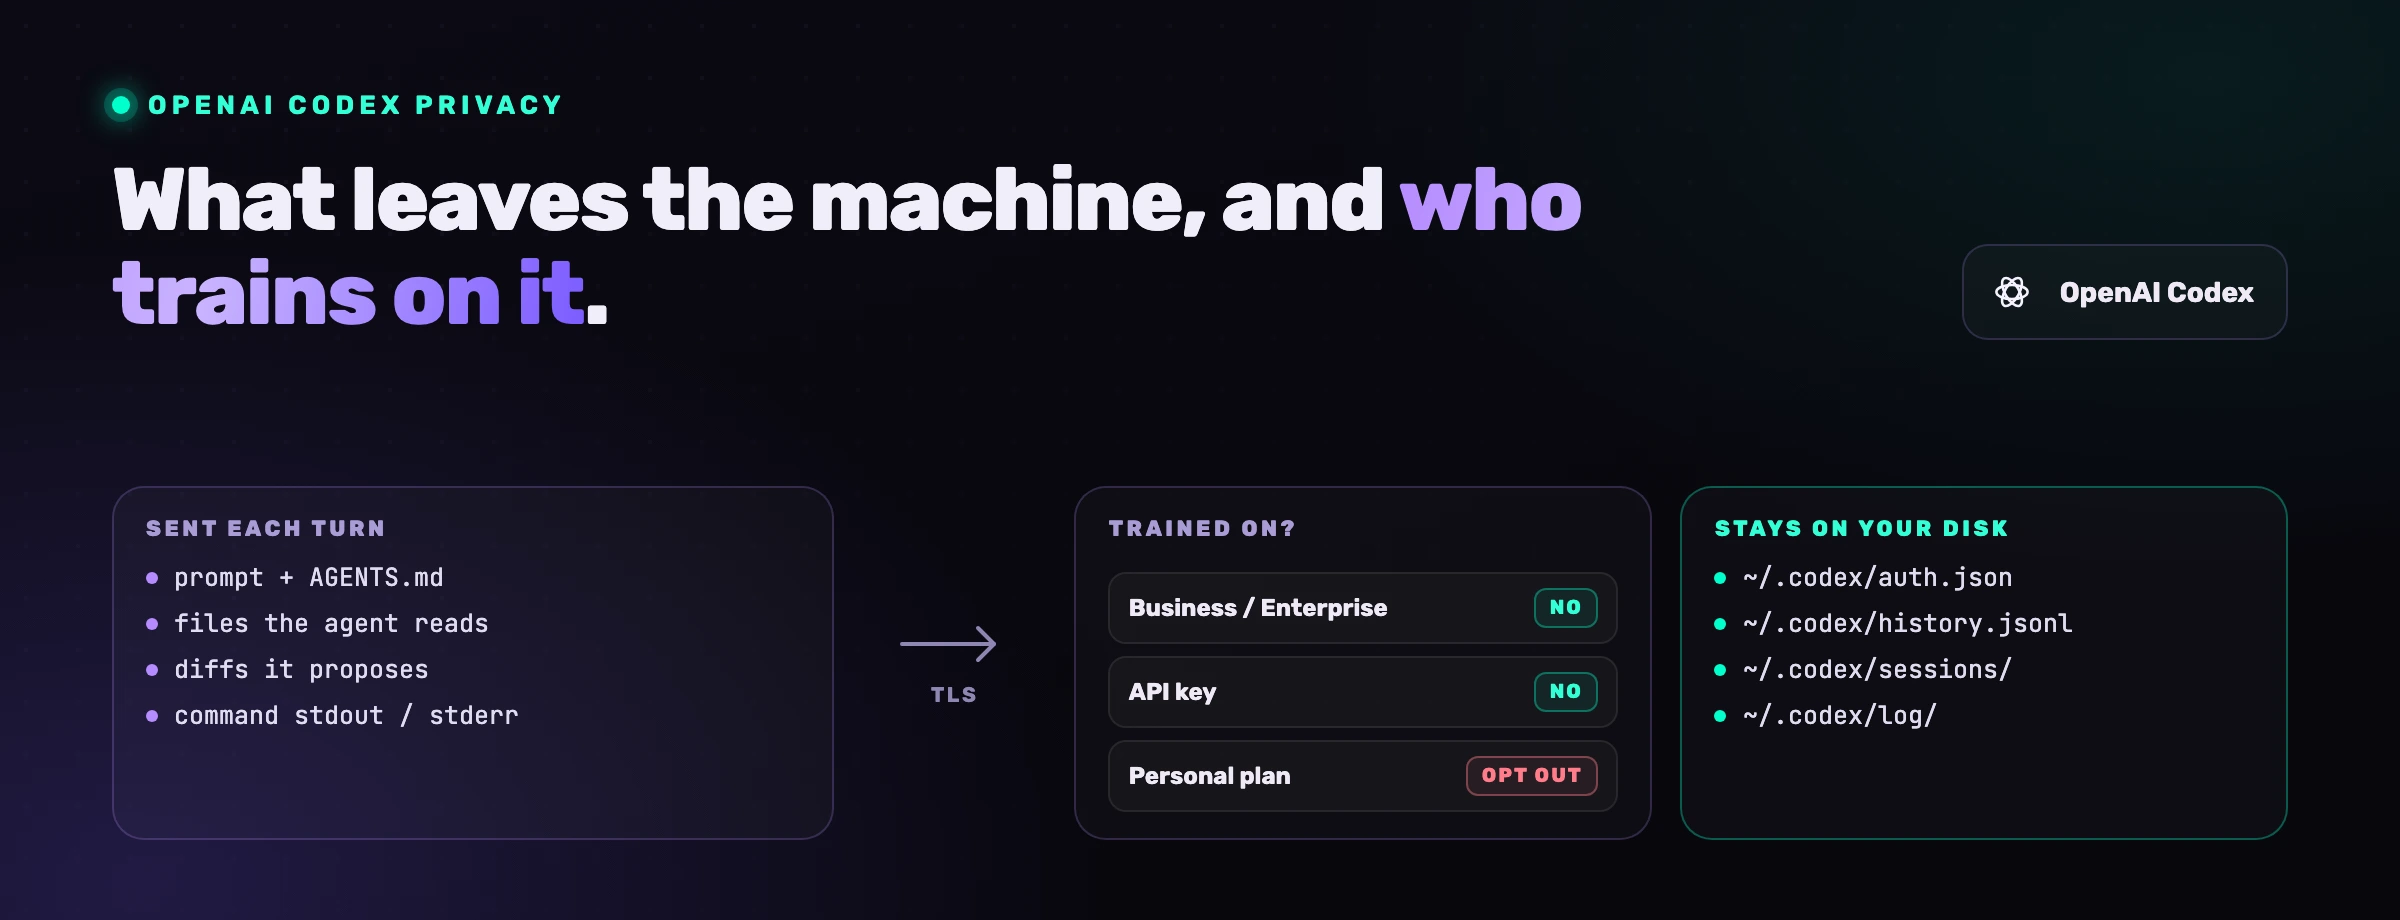
Ja, Codex schickt Ihren Code an OpenAI, und anders könnte der Agent gar nicht arbeiten: Der Prompt, jede Datei, die er zu lesen beschließt, die vorgeschlagenen Diffs und die Ausgabe der ausgeführten Befehle gehen an die Modelle von OpenAI. Wer wissen will, ob sich Codex mit dem eigenen Datenschutz und der DSGVO verträgt, kommt mit diesem Ja allerdings nicht weit und braucht genauere Antworten. Was genau verlässt den Rechner, und was bleibt in ~/.codex auf Ihrer Festplatte liegen? Trainiert OpenAI mit diesen Inhalten (das hängt an Ihrer Anmeldung, nicht am Werkzeug)? Was wird wie lange aufbewahrt? Und mit welchen Schaltern halten Sie Secrets und regulierten Code aus der Reichweite des Agenten heraus? Dieser Leitfaden geht die Fragen der Reihe nach durch und nennt zu jeder die Einstellung, die sie regelt.
Welche Daten überträgt Codex an OpenAI?
Codex überträgt alles an OpenAI, was das Modell für die Aufgabe braucht, und nichts, was der Agent nie geöffnet hat. OpenAI zeigt das selbst, in seinem Engineering-Beitrag zur Agentenschleife von Codex: In jedem Schritt schickt die CLI den Prompt, den Sie eingetippt haben, Anweisungsdateien wie AGENTS.md, eine kurze Beschreibung der Umgebung (Arbeitsverzeichnis und Shell) und die Ausgabe aller bisherigen Tool-Aufrufe an die Responses API. Über diesen letzten Weg reisen der Inhalt der Dateien, die der Agent lesen wollte, die Diffs, die er vorschlägt, stdout und stderr der ausgeführten Befehle und alles, was diese Befehle über das Repository ausgeben (Pfade, Git-Status, Struktur). Bei Codex Cloud erstellt Codex einen Container und checkt Ihr Repository dort aus, auf der Infrastruktur von OpenAI; dort fällt also alles darunter, was in diesem Checkout liegt.
Eine Datei, die der Agent nie gelesen hat, wird dagegen nie gesendet. Der praktische Hebel für den Datenschutz ist deshalb die Reichweite: was der Agent öffnen kann und was er laut Anweisung liegen lassen soll.
| Nutzungsweg | Was den Rechner verlässt | Wo das Modell läuft | Wessen Bedingungen gelten |
|---|---|---|---|
| CLI oder IDE-Erweiterung, Anmeldung mit ChatGPT | Prompt, gelesene Dateien, Diffs, Befehlsausgaben, Metadaten | OpenAI, in Ihrem ChatGPT-Workspace | Ihr ChatGPT-Tarif (persönlich oder Business/Enterprise/Edu) |
| CLI oder SDK, mit API-Schlüssel | Dasselbe, dazu optionale Telemetrie, falls Sie sie konfigurieren | OpenAI API | Datenkontrollen der API (standardmäßig kein Training) |
| Codex Cloud | Die Aufgabe und das gesamte Repository, das von Ihrem Git-Server in den Container ausgecheckt wird | Von OpenAI gehostete Sandbox | Ihr ChatGPT-Tarif |
Lokales codex exec in CI | Wie bei der CLI, nur unbeaufsichtigt | OpenAI | Die Zugangsdaten, die der Runner verwendet |
Die dritte Spalte beantwortet nebenbei eine Frage, die in deutschen Suchanfragen auftaucht, nämlich ob Codex lokal läuft. Auf Ihrem Rechner laufen die CLI und die IDE-Erweiterung. Das Modell rechnet in allen vier Zeilen der Tabelle bei OpenAI.
Zwei Dinge reisen mit, an die kaum jemand denkt. Das erste sind Umgebungsvariablen, denn die Shell, in der der Agent Befehle ausführt, sieht sie alle. Eine dort exportierte DATABASE_URL oder ein AWS_SECRET_ACCESS_KEY kann in einer Befehlsausgabe auftauchen und mit ihr zu OpenAI wandern. Welche Variablen diese Shell erreichen, regelt in Codex die shell_environment_policy, und von sich aus entfernt sie nichts: Laut der Konfigurationsreferenz von OpenAI bleiben Variablen, deren Name KEY, SECRET oder TOKEN enthält, standardmäßig erhalten. Das zweite sind Suchanfragen. Steht web_search auf live (das Flag --search), verlassen auch die Anfragen, die das Modell formuliert, den Rechner. Der Standardmodus cached arbeitet dagegen mit einem von OpenAI gepflegten Index, ohne Zugriff auf das externe Web. Dieselbe Referenz weist allerdings darauf hin, dass dieser Standard mit --yolo oder einer anderen Sandbox-Einstellung mit Vollzugriff auf live wechselt.
Trainiert OpenAI mit Ihrem Code aus Codex?
Ob OpenAI mit Ihrem Code aus Codex trainiert, hängt davon ab, wie Sie angemeldet sind, und nicht davon, ob Sie Codex in der CLI, in der IDE oder in der Cloud nutzen. Die Richtlinie von OpenAI zur Datennutzung behandelt Codex wie die übrigen Produkte, mit Diensten für Privatpersonen auf der einen und Diensten für Unternehmen auf der anderen Seite, ergänzt um einen einzigen Schalter, den es nur in Codex gibt.
| So nutzen Sie Codex | Wird standardmäßig trainiert? | So ändern Sie es |
|---|---|---|
| ChatGPT-Workspace (Business, Enterprise oder Edu) | Nein, laut der Enterprise-Privacy-Seite von OpenAI | Kontrollen des Workspace-Admins; nur per Opt-in |
| API-Schlüssel (Codex CLI oder SDK) | Nein. In den Datenkontrollen der OpenAI API heißt es: „Seit dem 1. März 2023 werden Daten, die an die OpenAI API gesendet werden, nicht zum Trainieren oder Verbessern von OpenAI-Modellen verwendet (es sei denn, Sie entscheiden sich ausdrücklich dafür, Daten mit uns zu teilen)“ | Nur per Opt-in |
| Persönlicher Tarif (Free, Go, Plus, Pro) | Möglich, solange Sie nicht widersprechen | ChatGPT-Einstellungen, Datenkontrollen, „Das Modell für alle verbessern“, oder das Datenschutzportal von OpenAI; einer der beiden Wege genügt |
| Vollständige Codex-Umgebungen (persönliche Tarife) | Eigener Schalter | Codex-Einstellungen, Schalter für das Training mit vollständigen Umgebungen |
Über die letzte Zeile stolpern die meisten. Laut den FAQ von OpenAI zu den Datenkontrollen gilt die Einstellung „Das Modell für alle verbessern“ im persönlichen Tarif auch für Ihre Codex-Aufgaben. Für das Training mit vollständigen Umgebungen hat Codex aber eine eigene Einstellung, die in den Codex-Einstellungen verwaltet wird, und weder die ChatGPT-Einstellung noch das Datenschutzportal ändern daran etwas. Welchen Standardwert diese Codex-Einstellung hat, sagt keine der beiden Seiten. Wer im Plus-Tarif „Das Modell für alle verbessern“ schon vor Jahren abgeschaltet hat, sollte also nicht davon ausgehen, dass Codex mitgezogen hat. Prüfen Sie beide Stellen.
Eine Ausnahme übersteht den Widerspruch, und die oben verlinkte Richtlinie zur Datennutzung hält sie ausdrücklich fest: Wenn Sie Feedback zu einer Antwort geben, etwa mit Daumen hoch oder Daumen runter, kann die gesamte zugehörige Unterhaltung für das Training verwendet werden.
Was speichert Codex lokal auf Ihrem Rechner?
Codex speichert lokal mehr, als die meisten vermuten, und es lohnt sich, die Dateien beim Namen zu kennen. Der Leitfaden von OpenAI zur erweiterten Konfiguration zählt auf, was unter ~/.codex liegt: config.toml (Ihre Einstellungen), auth.json (zwischengespeicherte Zugangsdaten, sofern der dateibasierte Speicher genutzt wird, sonst der Schlüsselbund des Betriebssystems), history.jsonl (im Leitfaden Sitzungstranskripte genannt, standardmäßig eingeschaltet) und die Logs in log/. Daneben liegt sessions/, wo Codex jeden Thread aufbewahrt, als Datei, die es wieder abspielen und fortsetzen kann. Für den Datenschutz zählen vor allem history.jsonl und sessions/. Zusammen enthalten sie Ihre Prompts, die Antworten des Agenten und die Ausgabe seiner Befehle samt jedem Stück Code und jedem Secret, das darin vorkam, und sie bleiben auf der Festplatte, bis Sie sie löschen.
Diese Tabellen der config.toml regeln, was lokal bleibt und was exportiert wird:
# Keine Sitzungstranskripte nach ~/.codex/history.jsonl schreiben
[history]
persistence = "none"

# Kein OpenTelemetry-Export von Logs; rohe Prompts nie exportieren
[otel]
exporter = "none"
log_user_prompt = false

# Zugangsdaten aus der Shell entfernen, die der Agent benutzt
[shell_environment_policy]
ignore_default_excludes = false  # entfernt auch Namen, die KEY, SECRET oder TOKEN enthalten

[shell_environment_policy.filters]
"AWS_*" = "exclude"
"DATABASE_URL" = "exclude"

# Analytics auf Rechnerebene
[analytics]
enabled = false
Drei Präzisierungen aus der Dokumentation von OpenAI gehören zu diesem Block. history.persistence = "none" stoppt history.jsonl und sonst nichts: Die Sitzungsdateien unter sessions/ sind ein eigener Mechanismus, die Konfigurationsreferenz dokumentiert keinen Schlüssel für sie, und der einzige dokumentierte Weg, sie zu vermeiden, ist codex exec --ephemeral, das läuft, ohne sie zu schreiben. Die Tabelle filters ist die aktuelle Form der shell_environment_policy; das ältere Array exclude funktioniert weiter, die Referenz führt es aber inzwischen als Legacy, und eine Mischung aus beiden lehnt Codex ab. Und der OpenTelemetry-Export von Logs ist standardmäßig deaktiviert. Exportiert wird also erst, wenn Sie es konfigurieren, und rohe Prompts landen nur dann im Export, wenn Sie otel.log_user_prompt ausdrücklich einschalten.
Bleiben zwei Kanäle, beide standardmäßig aktiv: die anonymen Nutzungs- und Zustandsmetriken, die laut OpenAI keine Informationen enthalten, mit denen Sie sich identifizieren ließen, und die analytics.enabled = false abschaltet, und der Befehl /feedback (feedback.enabled). Wichtig für die Einordnung: An dem, was das Modell erhält, ändert keine dieser Einstellungen etwas. Sie bestimmen nur, was Ihr Rechner schreibt und weiterleitet.
„Stiehlt“ Codex Ihren Code?
Nein, Codex stiehlt Ihren Code nicht, und die Frage verdient eine genaue Antwort statt einer beschwichtigenden. Codex überträgt Ihren Code an OpenAI, und zwar zu den Bedingungen des Tarifs, mit dem Sie sich angemeldet haben. Diese Bedingungen sind öffentlich. Das ist ein Datenfluss, dem Sie zugestimmt haben, kein Diebstahl.
Auch die beiden Vorfälle, die der Frage ihr Suchvolumen verschafft haben, handeln nicht davon, dass Codex Code entwendet hätte. Im ersten Fall geht es um codexui-android, eine tatsächlich funktionierende Remote-Weboberfläche für Codex auf npm, aktiv weiterentwickelt und einige Tausend Mal pro Woche heruntergeladen. Wie The Hacker News am 1. Juni 2026 berichtete, lasen die veröffentlichten Versionen seit etwa einem Monat bei jedem Start ~/.codex/auth.json aus und schickten die Datei an den Server eines Angreifers, mit Code, der im GitHub-Repository nie aufgetaucht ist. Im zweiten legte BeyondTrust Phantom Labs im März 2026 eine Command-Injection-Schwachstelle in der Cloud-Umgebung von Codex offen, über die The Hacker News berichtete: Über einen präparierten Branch-Namen ließ sich das GitHub-Token stehlen, das Codex verwendet, und BeyondTrust nennt als betroffen die ChatGPT-Website, die Codex CLI, das SDK und die IDE-Erweiterung. OpenAI hat die Lücke inzwischen behoben.
Beide Fälle folgen demselben Muster: Gestohlen wurden die Zugangsdaten rund um Codex, und der Angreifer war ein Dritter. Dorthin gehört Ihre Aufmerksamkeit. Der Leitfaden von OpenAI zur Authentifizierung verlangt, ~/.codex/auth.json wie ein Passwort zu behandeln, und mit cli_auth_credentials_store = "keyring" wandern die Tokens in den Schlüsselbund des Betriebssystems, sodass die Datei gar nicht mehr zum Auslesen daliegt. Prüfen Sie, was Sie installieren, und bedenken Sie dabei, dass ein sauberes Repository nichts über das Paket beweist, das die Registry tatsächlich ausliefert. Begegnen Sie jeder Codex-Erweiterung so misstrauisch wie einer Browser-Erweiterung, die nach Ihrem Passwort fragt.
Bleibt ein dritter Weg, auf dem Code abhandenkommt, und für den schreibt niemand einen Vorfallbericht: eine Prompt Injection in einem geklonten Repository, die den Agenten anweist, Ihre Dateien per curl irgendwohin zu schicken, während in der Sitzung der Netzwerkzugriff offen ist. Aus genau diesem Grund hält die workspace-write-Sandbox von Codex das Netzwerk standardmäßig geschlossen, und der Leitfaden von OpenAI zu Sandbox und Freigaben sagt es ohne Umschweife: Standardmäßig läuft der Agent mit abgeschaltetem Netzwerkzugriff. Welche Flags es öffnen und wann das vertretbar ist, steht in unserem Leitfaden zu den Sandbox- und Freigabe-Flags von Codex.
Wie halten Sie Secrets und regulierten Code von Codex fern?
Secrets und regulierten Code halten Sie von Codex fern, indem Sie verkleinern, was der Agent öffnen kann, und dafür sorgen, dass das, was er öffnet, nichts hergibt. Die Maßnahmen, nach Wirkung geordnet:
- Secrets gehören nicht in Dateien, die der Agent lesen kann. Eine
.envmit aktiven Schlüsseln, eineconfig/production.ymlmit dem Datenbankpasswort, einecredentials.jsonirgendwo im Verzeichnisbaum: Was im Workspace liegt, kann der Agent lesen, und was er liest, kann in einem Transkript landen. Nutzen Sie einen Secrets-Manager und injizieren Sie die Werte zur Laufzeit. - Räumen Sie die Shell auf. Mit
ignore_default_excludes = falseundfilters-Einträgen aufexcludein dershell_environment_policyfür Schlüssel, Tokens und Connection-Strings, damit keine Befehlsausgabe sie verraten kann. - Lassen Sie das Netzwerk geschlossen.
sandbox_workspace_write.network_accessbleibt auffalse. Braucht eine Aufgabe wirklich die Registry, schalten Sie den Zugriff mit-cnur für diesen einen Lauf frei. - Kennzeichnen Sie fremde Repositories als nicht vertrauenswürdig. Mit
projects."<path>".trust_level = "untrusted"überspringt Codex laut der Konfigurationsreferenz von OpenAI die.codex/-Ebenen, die das Repository selbst mitbringt, einschließlich projektlokaler Konfiguration, Hooks und Regeln. Ein geklontes Projekt kann den Agenten dann nicht gegen Sie umkonfigurieren. - Schalten Sie lokale Transkripte ab, wo Rechner geteilt werden oder reguliert sind.
history.persistence = "none", dazu ein regelmäßiges Aufräumen von~/.codex/sessions/, das dieser Schlüssel nicht abdeckt. In CI nutzen Siecodex exec --ephemeral. - Wählen Sie den Zugang nach den Daten. Code unter NDA, eine regulierte Codebasis, Kundendaten in Fixtures: Dafür nehmen Sie einen Business- oder Enterprise-Workspace oder einen API-Schlüssel. Für die API-Nutzung mit strengeren Pflichten dokumentieren die Datenkontrollen der OpenAI API drei Dinge. Logs zur Missbrauchsüberwachung werden standardmäßig „bis zu 30 Tage“ aufbewahrt, länger, wenn das Gesetz es verlangt. Die Option Zero Data Retention hält Kundeninhalte auf dafür zugelassenen Endpunkten, darunter
/v1/responses, aus diesen Logs heraus, und OpenAI gewährt sie nur nach vorheriger Genehmigung, nicht auf bloßen Antrag. Auch die Datenresidenz setzt eine Berechtigung voraus: Die Region Europa (EWR und Schweiz) verlangt Zero Data Retention oder eine andere der Kontrollen von OpenAI für reduzierte Aufbewahrung, und Systemdaten wie Konto- und Nutzungsmetadaten deckt sie nicht ab. Wer prüft, ob sich Codex DSGVO-konform einsetzen lässt, findet hier die Stellschrauben. Ob sie für die eigene Verarbeitung ausreichen, beantwortet allerdings Ihre Vereinbarung mit OpenAI und nicht dieconfig.toml. - Suchen Sie nach Secrets, bevor der Agent sie findet. Ein committeter Schlüssel, den ein Scanner heute meldet, ist ein Schlüssel, den die nächste Sitzung nicht mehr in den Kontext liest.
Was keine Datenschutzeinstellung abdeckt
Alles bisher Genannte regelt, was Codex liest und überträgt. Was Codex zurückschreibt, regelt nichts davon, und dieser Code ist eine Datenschutzfrage für sich. Ein Agent schreibt ein Token fest in den Code, das er in einer Fixture gesehen hat. Er loggt einen vollständigen Request-Body samt Kartennummer. Er liefert einen Nutzerdatensatz mit Feldern aus, die der Aufrufer nie hätte sehen dürfen. In jedem dieser Fälle ist ein Datenschutzproblem entstanden, das keine Aufbewahrungsrichtlinie mehr einfängt, denn das Leck sitzt jetzt in Ihrem Repository und in Ihren Produktions-Logs.
Diese Schicht ergänzt VibeDefend zur Agent-Zeit. VibeDefend sitzt in der Codex-Schleife und prüft den Diff, den der Agent gerade schreiben will, gegen Ihre Regeln. Das fest codierte Secret, die zu gesprächige Log-Zeile und die fehlende Autorisierungsprüfung werden umgeschrieben, bevor sie im Repository landen. Der Guard entscheidet lokal auf Ihrem Rechner, die Telemetrie besteht nur aus strukturierten Metadaten, und die Analyse läuft auf selbst gehosteten Modellen in der EU- oder US-Region, die Sie bei der Installation wählen, ohne LLM-API Dritter und ohne dass Ihr Code zum Trainieren eines Modells verwendet wird. In unserer kontrollierten Studie setzte der Agent mit dieser Schicht die exakte Regel in 89 % der Fälle um (57 von 64 bewerteten Regeln), ohne Werkzeug waren es 12 % und mit einer von Hand gepflegten Regeldatei im Repository 13 %.
Das Gesamtbild mit Sandbox, Supply Chain und den Risiken der Autonomie zeichnet unser vollständiger Leitfaden zur Sicherheit von OpenAI Codex. Und wenn Ihr Team Codex auf Code einführt, der das Haus nicht verlassen darf, sprechen Sie mit uns: Diese Konfiguration haben wir schon viele Male aufgesetzt.
Häufige Fragen
Landet mein Code bei OpenAI, wenn ich Codex nutze?
Ja. In jedem Schritt gehen der Prompt, die vom Agenten gelesenen Dateien, die vorgeschlagenen Diffs, die Befehlsausgaben und Repository-Metadaten an die Modelle von OpenAI, und bei Codex Cloud wird das gesamte Repository in einen von OpenAI gehosteten Container ausgecheckt. Eine Datei, die der Agent nie öffnet, wird auch nie gesendet. Seine Reichweite zu begrenzen ist deshalb der wichtigste Hebel für den Datenschutz.
Trainiert OpenAI seine Modelle mit meinem Code aus Codex?
Standardmäßig nicht, wenn Sie Codex über einen ChatGPT-Workspace (Business, Enterprise oder Edu) oder über einen API-Schlüssel nutzen. Im persönlichen Tarif ist es möglich, solange Sie nicht widersprechen: Dort gilt Ihre ChatGPT-Einstellung „Das Modell für alle verbessern“ auch für Codex. Zusätzlich hat Codex in den eigenen Einstellungen einen separaten Schalter für das Training mit vollständigen Umgebungen, den Sie ebenfalls prüfen müssen.
Wie deaktiviere ich das Training mit meinem Code in ChatGPT und Codex?
Im persönlichen Tarif in zwei Schritten. Zuerst schalten Sie in ChatGPT unter Datenkontrollen „Das Modell für alle verbessern“ ab (oder Sie nutzen das Datenschutzportal von OpenAI). Dann öffnen Sie die Codex-Einstellungen und schalten dort das Training mit vollständigen Umgebungen ab, denn der erste Schalter ändert den zweiten nicht. Oder Sie melden sich über einen Business- oder Enterprise-Workspace oder mit einem API-Schlüssel an: Dort ist Training von vornherein aus.
Läuft Codex lokal, und was speichert es auf meinem Rechner?
Die CLI und die IDE-Erweiterung laufen auf Ihrem Rechner, das Modell rechnet in allen vier oben beschriebenen Nutzungswegen bei OpenAI. Lokal legt Codex standardmäßig Sitzungstranskripte in ~/.codex/history.jsonl ab, dazu Zugangsdaten in ~/.codex/auth.json (sofern Sie nicht den Schlüsselbund des Betriebssystems nutzen), pro Sitzung eine wiederabspielbare Datei in ~/.codex/sessions/ und Logs in ~/.codex/log/. history.persistence = "none" in der config.toml stoppt nur history.jsonl: Die Sitzungsdateien brauchen ein eigenes Aufräumen, oder codex exec --ephemeral bei skriptgesteuerten Läufen.
Kann Codex meine .env-Datei lesen?
Ja, sobald die Datei im Workspace liegt und der Sandbox-Modus das Lesen erlaubt, und das tun sowohl read-only als auch workspace-write: Eingegrenzt sind dort nur Schreibzugriffe. Halten Sie aktive Secrets deshalb aus dem Verzeichnisbaum heraus, und entfernen Sie sie mit der shell_environment_policy aus der Shell, in der der Agent Befehle ausführt.
Ist Codex DSGVO-konform nutzbar, und gibt es Datenresidenz in der EU?
Ein einzelner Schalter beantwortet das nicht, aber OpenAI dokumentiert die Bausteine. Für die API-Nutzung sind das Regionen für die Datenresidenz, darunter Europa (EWR und Schweiz), eine Option Zero Data Retention auf dafür zugelassenen Endpunkten und die standardmäßige Aufbewahrung der Logs zur Missbrauchsüberwachung von bis zu 30 Tagen. Beide Optionen setzen eine Berechtigung und die Genehmigung von OpenAI voraus, die Region Europa verlangt eine Kontrolle für reduzierte Aufbewahrung wie Zero Data Retention, und Systemdaten deckt die Residenz nicht ab. Wo die Daten Ihres ChatGPT-Workspace verarbeitet werden, hängt von Ihrer Vereinbarung ab. Bei regulierten Workloads lassen Sie sich das von OpenAI bestätigen.
Wie sicher ist Codex für proprietären Code?
So sicher wie die Anmeldung und die Konfiguration, mit denen Sie es betreiben: ein Zugang ohne Training (Business, Enterprise oder API-Schlüssel), keine Secrets im Workspace, ein geschlossenes Netzwerk, fremde Repositories als nicht vertrauenswürdig markiert und lokale Transkripte abgeschaltet, wo der Rechner geteilt wird. Übrig bleibt der Code, den der Agent schreibt, und der braucht eine eigene Prüfschicht.


